
OpenCodeReview 是阿里巴巴開源的人工智能代碼審查命令行工具,在 GitHub 累積 42,248 顆星標與 3,030 次複製。它原本是集團內部的官方審查助手,兩年間服務數萬名開發者並找出數百萬個代碼缺陷,如今以 Apache-2.0 授權對外釋出,使用者只需設定一組模型端點即可開始審查。
OpenCodeReview 是阿里巴巴開源的 AI 代碼審查命令行工具,星標達 42,248 顆,以確定性工程搭配代理的混合架構審查 Git 差異。
過去兩年,市場上出現大量以提示詞驅動的代碼審查方案,但它們在大型變更集上的表現普遍不穩定。審查結果不僅取決於模型能力,也取決於流程本身是否具備可驗證的約束,這正是開源版本選擇把工程邏輯拉回核心的原因。
OpenCodeReview 是什麼?
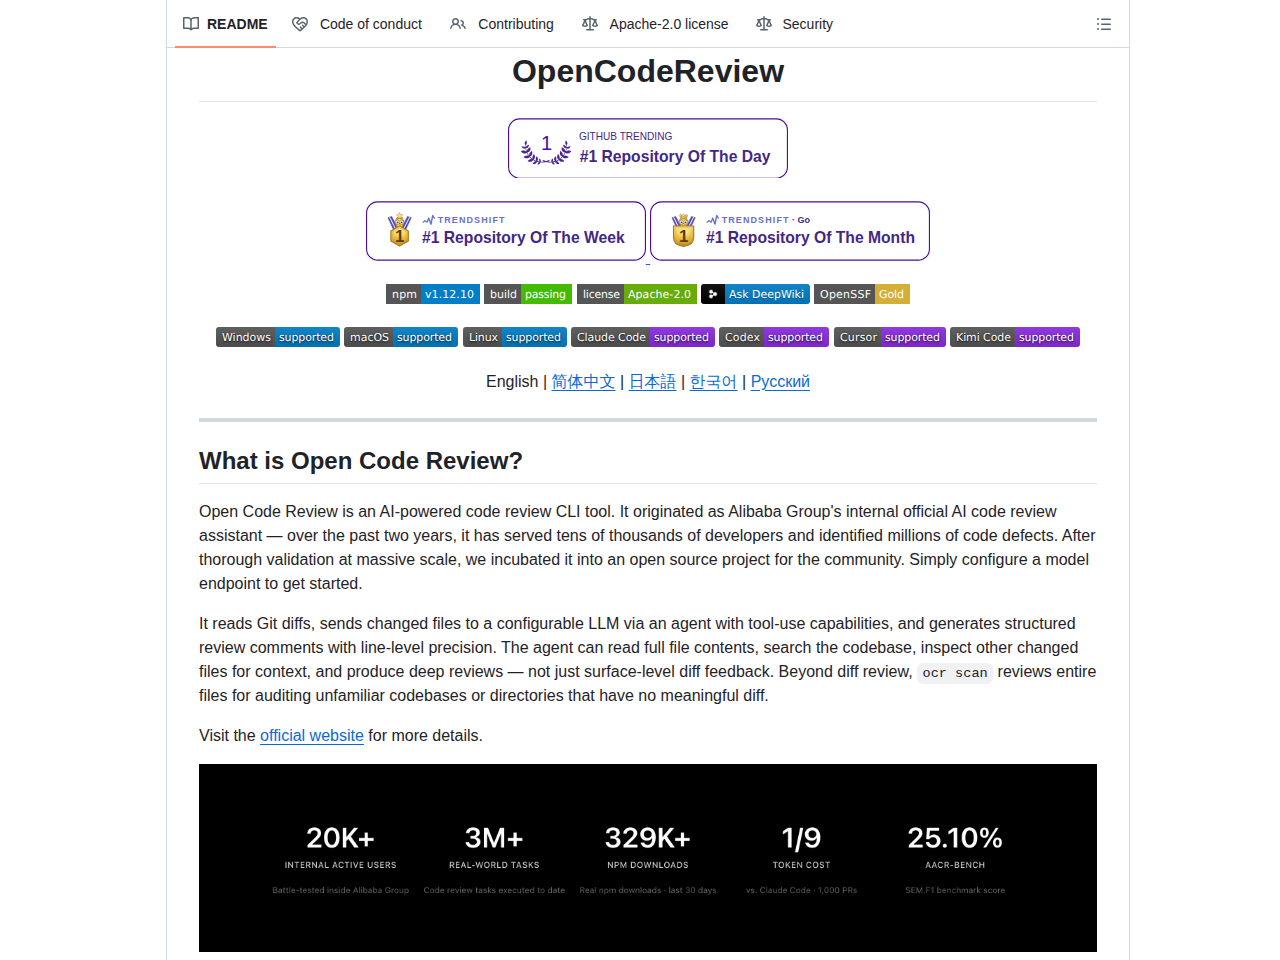
它是一套面向軟件工程的 AI 代碼審查工具,能讀取 Git 差異並產生行級精確的評論;除了差異審查,也支援整檔掃描,用於稽核沒有版本歷史的陌生代碼庫。
工具的核心職責是把變更檔案送進可設定的語言模型,再產生帶有行號定位的結構化評論。與單純把整份差異丟給模型不同,它允許代理讀取完整檔案內容、搜尋代碼庫,並檢視其他被改動的檔案以取得上下文,因此評論的深度不局限於差異表面。
除差異審查之外,另一條命令用於整檔掃描。當團隊接手陌生代碼庫,或面對沒有實質變更的目錄時,這個模式可以直接稽核整份檔案,無需依賴任何提交歷史。
它與通用代理的差異在哪裡?
通用代理在大型變更集上容易漏檔、位置漂移且品質波動;OpenCodeReview 以工程邏輯固定檔案挑選、分組與規則比對,讓語言模型只負責需要動態判斷的環節。
官方文件把通用代理的痛點歸納為三類。其一是覆蓋不完整,變更集一大,代理傾向選擇性審查,只讀部分檔案而漏掉其他。其二是位置漂移,回報的問題經常對不上實際代碼位置,行號或檔名在幾輪對話後失準。其三是品質不穩,純自然語言驅動的技能難以除錯,提示詞出現微小變動,審查品質便明顯起伏。
專案認為根因在於架構本身:完全由語言驅動的流程,對審查過程沒有任何硬性約束。因此它把流程拆成兩半,凡是不可出錯的步驟交給工程邏輯保證,凡需要動態判斷的步驟才交給代理。
它的核心架構如何運作?
架構分為確定性工程與代理兩層:工程層負責精確挑選檔案、智慧分組、細粒度規則比對與獨立的定位反思模組;代理層則專注在場景調校的提示與工具集。
工程層處理四件事。檔案挑選決定哪些檔案需要審查、哪些應該過濾,確保重要變更不會被略過。智慧分組把相關檔案綁成同一個審查單元,例如英文與中文的訊息屬性檔會被合併處理,每個單元以獨立脈絡的子代理執行,形成分而治之的策略,在超大變更集上仍能保持穩定並自然支援並行審查。
規則比對是另一項重點。它依檔案特徵匹配對應的審查規則,把模型的注意力集中在真正相關的範圍,並在源頭消除資訊噪音。相較於以自然語言提示規則,樣板引擎驅動的匹配方式更穩定也更可預測。此外,獨立的定位與反思模組分別改善評論的位置準確度與內容準確度。
代理層則集中在動態決策與檢索。審查場景經過深度調校的提示樣板提升效果並降低代幣消耗;工具集則是從大規模生產資料的工具呼叫軌跡中蒸餾而來,分析涵蓋呼叫頻率分布、每個工具的重複率,以及新增工具對整條呼叫鏈的影響,最終形成一組比通用工具包更穩定、更可預測的專用組合。
基準測試表現如何?
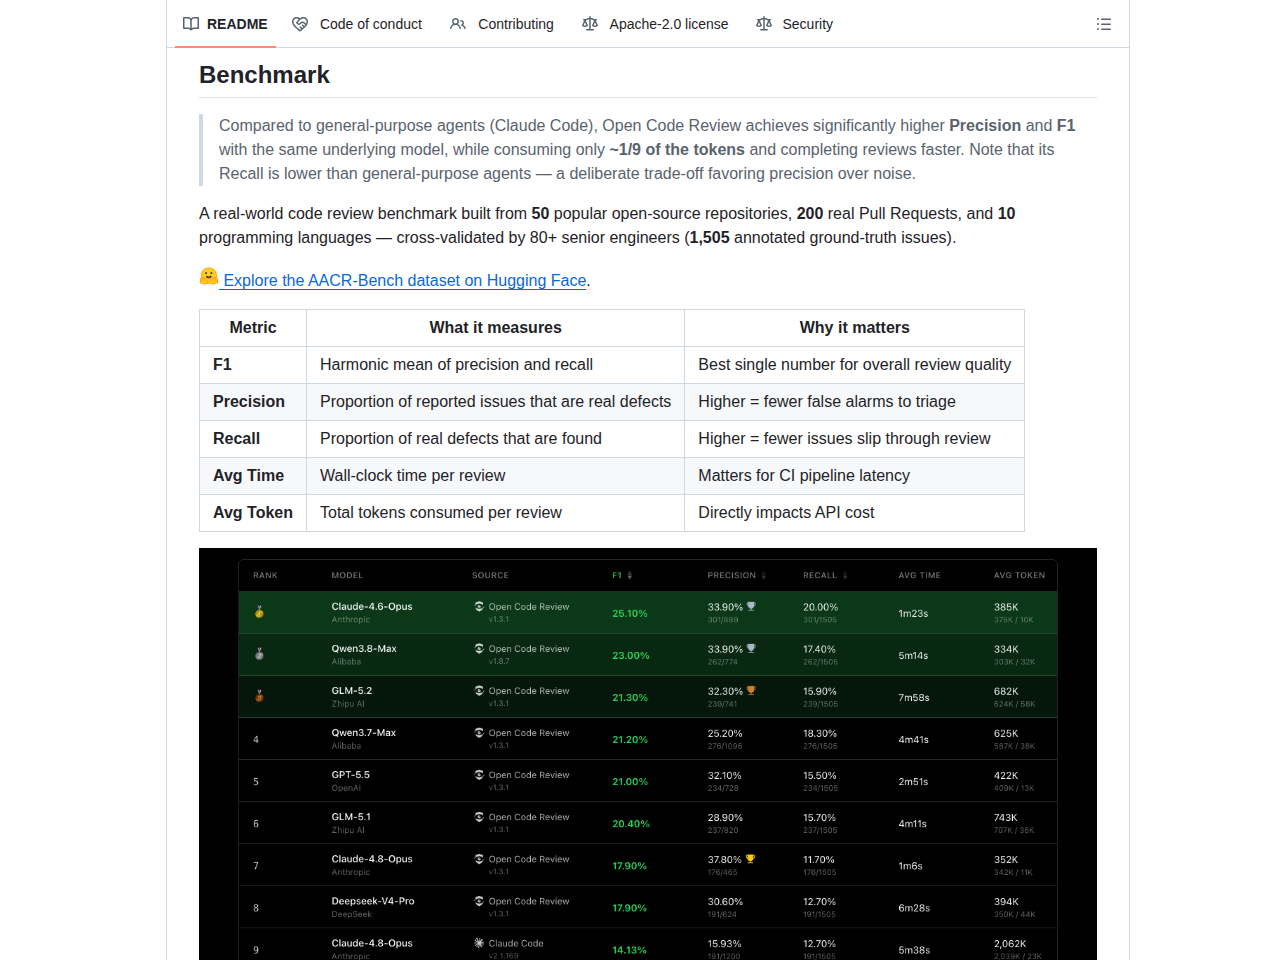
官方基準由 50 個熱門開源倉庫、200 個真實拉取請求與 10 種程式語言組成,並由 80 位以上資深工程師交叉驗證,共 1,505 條人工標註問題。
測試集的建構方式值得注意。它並非合成資料,而是取自真實開源專案的拉取請求,覆蓋十種程式語言,並由八十位以上資深工程師交叉標註,最終形成 1,505 條基準答案,資料集另以 AACR-Bench 之名公開於 Hugging Face。
在相同底層模型下,專案宣稱精確度與 F1 明顯高於通用代理,審查完成速度更快,代幣消耗僅約九分之一。文件同時坦承召回率低於通用代理,並解釋這是刻意取捨:寧可少報,也不願用大量誤報佔用開發者的分類時間。對導入 CI 流程的團隊而言,這項取捨直接影響人工複核的成本結構。
如何開始使用 OpenCodeReview?
先安裝全域套件並執行互動式設定挑選供應商與模型,接著在專案目錄執行審查命令即可;結果可輸出為 JSON,方便其他代理或自動化流程接續處理。
安裝以 npm 為主,完成後系統會提供全域命令。前置條件是 Git 2.41 以上版本,因為差異產生、代碼搜尋與倉庫操作都依賴 Git。設定階段透過互動介面選擇內建供應商或自訂端點、輸入金鑰並挑選模型,最後自動測試連線。
npm install -g @alibaba-group/open-code-review

ocr config provider
ocr config model

# 審查工作區中所有已暫存、未暫存與未追蹤的變更
ocr review

# 審查特定分支自主要分支分岔以來的變更
ocr review --from main --to feature-branch

# 整檔掃描,無需版本歷史
ocr scan --path internal/agent

# 輸出結構化結果,方便其他代理接續處理
ocr review --format json --output result.json
審查中斷可以恢復,工作階段清單會保留先前的執行紀錄,指定識別碼即可續跑。若團隊不希望另外配置模型金鑰,另有一條委派路徑:工具只負責檔案挑選與規則解析,實際審查交由使用者既有的編程代理執行,如此便無需額外端點。
整合層面涵蓋主流編程代理與持續整合系統。官方提供 Claude Code、Codex、Cursor、Kimi Code 與 OpenCode 的插件,各自對應斜線命令或可呼叫技能;CI 方面支援 GitHub Actions、GitLab CI、GitFlic CI 與 Gerrit。另有工作階段檢視器,可在瀏覽器重播審查過程並把評論標記為已修正或忽略。
它的專案數據與生態現況如何?
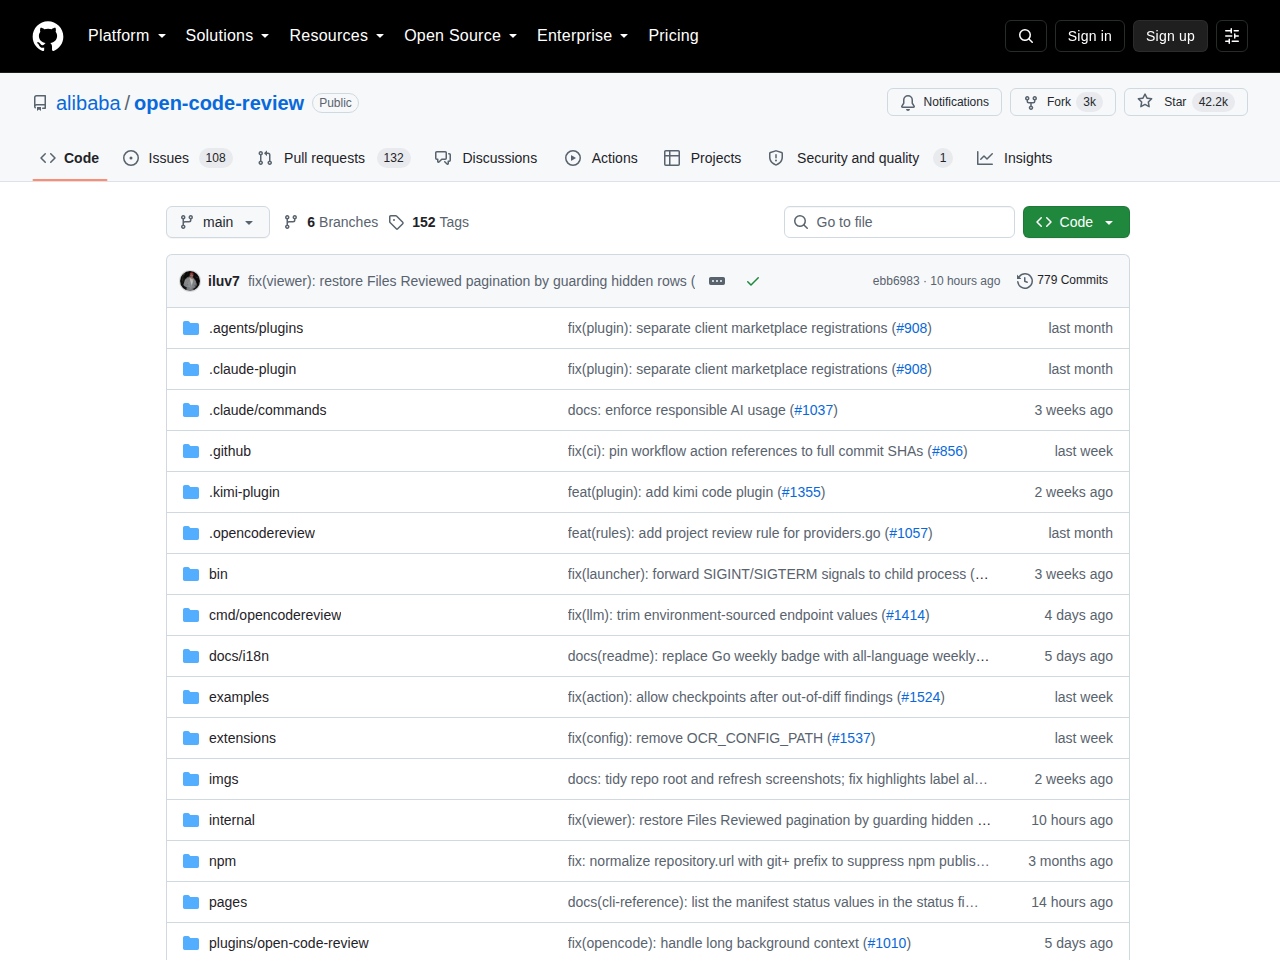
專案於 2026 年 5 月建立,四個月累積 42,248 顆星標與 3,030 次複製,以 Go 撰寫並採 Apache-2.0 授權,程式倉庫仍有高頻推送。
倉庫建立於 2026 年 5 月,技術選型為 Go,授權條款為 Apache-2.0,允許商業使用與自行修改。專案在 2026 年 9 月下旬仍持續推送,並取得 OpenSSF 最佳實踐金級認證,這對需要在企業內部合規審查的團隊具有參考價值。目前待處理議題約 240 項,反映社群提交相當活躍。
- 42,248GitHub 星標
- 3,030複製次數
- Apache-2.0開源授權
- 2026-05專案建立時間
商業化路徑目前以開源主體搭配官方網站文件為主。專案同步登錄 npm 套件庫,並在官方網站提供安裝、設定、規則客製與 MCP 擴充的完整文件,這種以工具本體帶動生態的模式,與近年企業開源專案的常見做法一致。
出處連結有哪些?
本文資訊整理自 OpenCodeReview 的 GitHub 儲存庫與官方網站文件,基準測試數據參考官方公布的 AACR-Bench 資料集說明。
本文內容整理自 OpenCodeReview 的 GitHub 儲存庫(https://github.com/alibaba/open-code-review),並參考官方網站 open-codereview.ai 的安裝、設定與整合文件,以及公開於 Hugging Face 的 AACR-Bench 基準資料集說明。讀者可前往上述來源查閱完整的安裝指引、審查規則與授權條款。
總結:OpenCodeReview 適合什麼團隊?
OpenCodeReview 適合重視審查穩定度與成本控制的團隊。若組織要把代碼審查納入持續整合流程,並願意接受偏低召回率換取更少誤報,此專案值得優先評估。
這套工具的價值在於把代碼審查從提示詞工程拉回可驗證的工程流程。它以硬性約束換取穩定的覆蓋率與位置準確度,並以精確度優先的取捨控制誤報量。評估時宜先確認既有模型供應商能否接入、既有編程代理是否需要委派模式,以及誤報與漏報在自身流程中的成本比重,再決定是否將其納入日常審查與持續整合。