
DeepSeek-R1 是中國 AI 公司 DeepSeek 於二零二五年一月二十日開源的推理模型系列,GitHub 星標已達 91,940 顆,複製次數 11,661 次。該專案首次以完整研究驗證,大型語言模型的推理能力可以單純透過大規模強化學習被激發出來,無需以監督式微調作為前置步驟,被視為開放推理模型發展的關鍵轉折點。
DeepSeek-R1 是 DeepSeek 開源的推理模型系列,以純強化學習訓練推理能力,母模型達 6,710 億參數,並釋出六個版本,採 MIT 授權。
它在一月發布後迅速成為開源社群關注焦點,並在隨後數月帶動一批以推理為核心的模型與工具湧現。理解它的訓練設計與開放策略,有助於掌握當前推理模型的技術走向。
DeepSeek-R1 是什麼?
DeepSeek-R1 是 DeepSeek 推出的開源推理模型,主模型具 6,710 億總參數與 128K 上下文,主打數學、程式與推理任務。
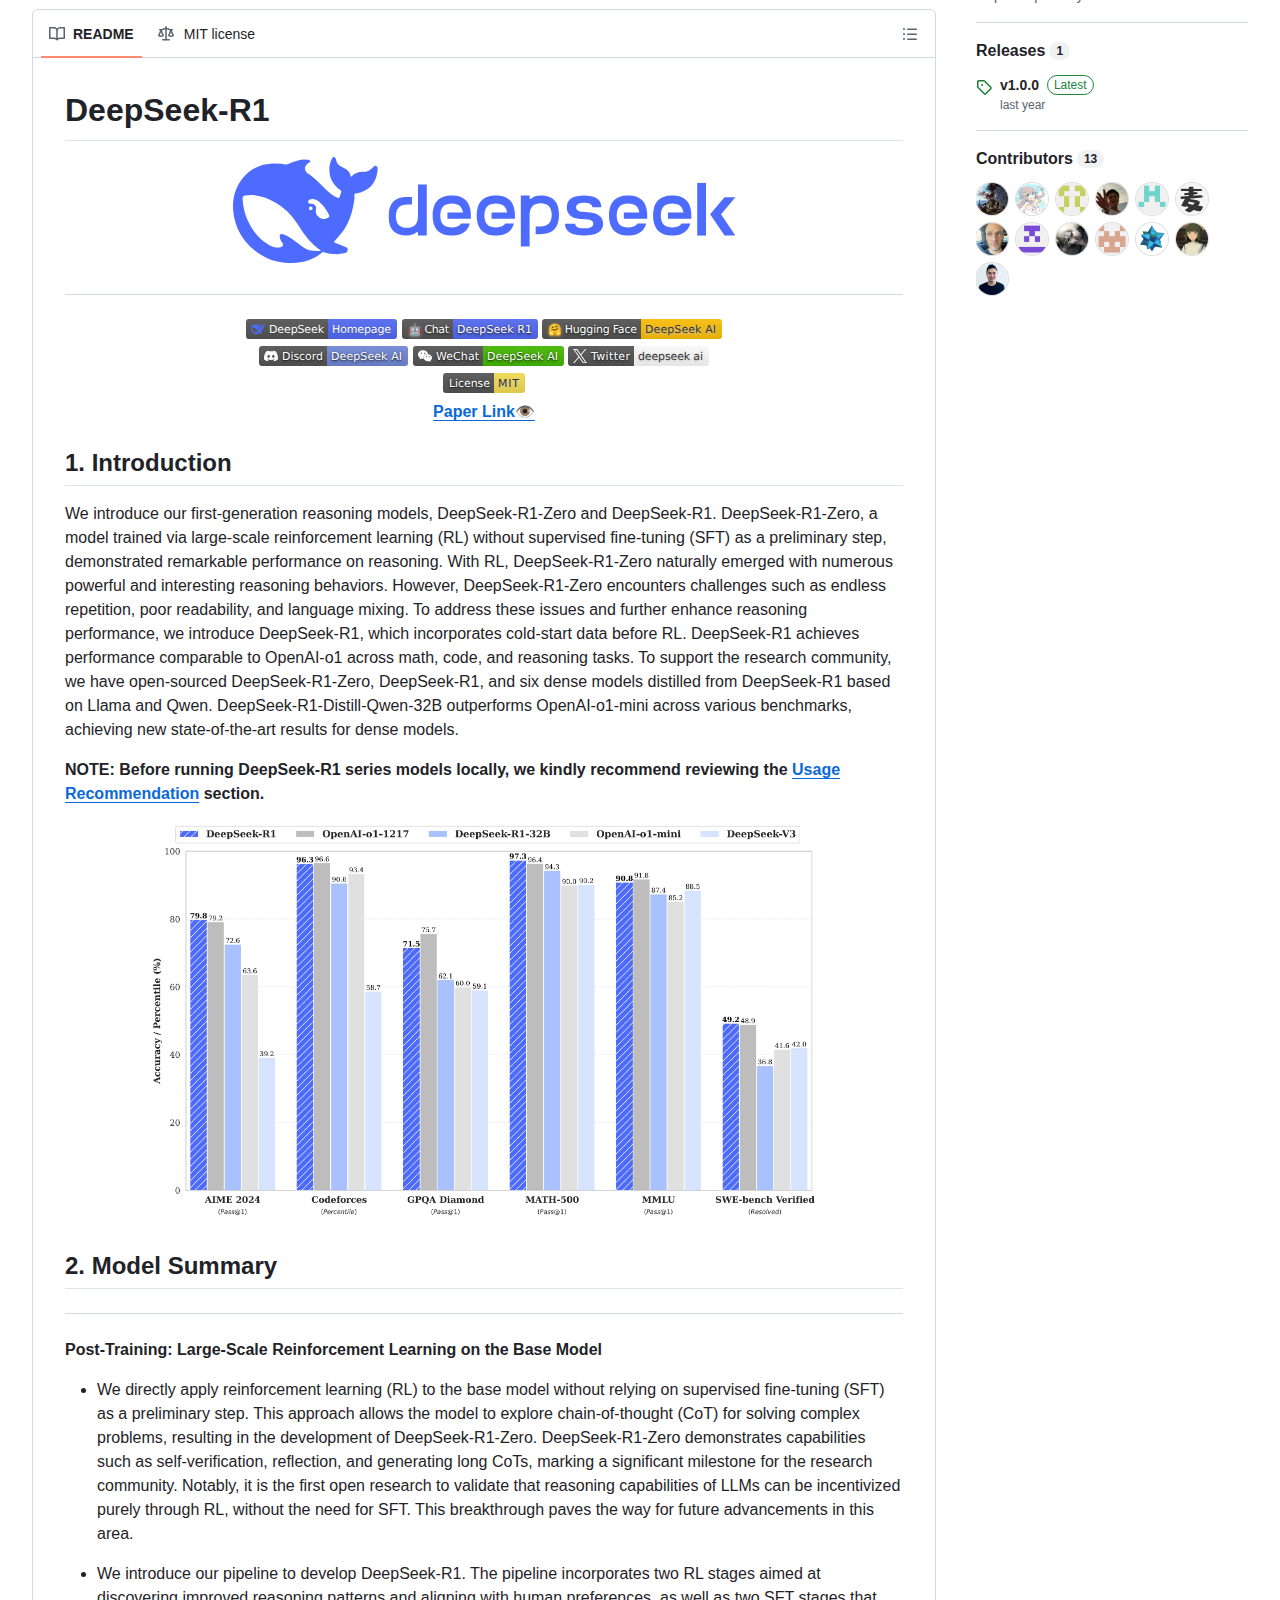
依照官方說明,DeepSeek-R1 屬於第一代推理模型,包含兩個主要成員。DeepSeek-R1-Zero 是完全不使用監督式微調、直接以強化學習訓練的版本,用來驗證推理能力能否自然湧現;DeepSeek-R1 則在強化學習之前加入冷啟動資料,用以修正前者的缺陷。
兩個主模型皆以 DeepSeek-V3-Base 為基礎,採用混合專家架構,總參數為 6,710 億,每個權杖僅激活約 370 億參數,上下文長度達 128K。官方指出,此設計讓模型在維持推理表現的同時,把實際運算量壓在相對可控的範圍。
值得注意的是,專案的倉庫本身以文件與模型權重為主,並非可直接建置的軟體專案。使用者要實際運行,需轉向官方推薦的推理框架與模型下載頁面。
DeepSeek-R1 的訓練方法有什麼創新?
核心創新是先以純強化學習訓練出 DeepSeek-R1-Zero,驗證推理可自然湧現;再以冷啟動資料與四階段流程組成完整方案。
DeepSeek-R1-Zero 的實驗結果,是整個專案最具新聞價值之處。團隊直接把強化學習套用在基礎模型上,不依賴任何監督式微調,模型便在訓練過程中自發出現自我驗證、反思與生成長鏈思維等行為。官方形容這是首次有公開研究證實,推理能力可以純粹由強化學習誘發。
不過,純強化學習版本也暴露出明顯問題,包括無止境重複、可讀性差與語言混雜。為此,團隊在強化學習之前加入冷啟動資料,並設計了兩階段強化學習與兩階段監督式微調的完整流程,分別用來發現更佳推理模式、對齊人類偏好,以及為模型的推理與非推理能力奠基。
除了母模型,專案的另一條主線是蒸餾。團隊以 DeepSeek-R1 產生的推理資料,微調多個社群常用的稠密模型,並將 15 億、70 億、80 億、140 億、320 億與 700 億參數的檢查點全部開源。官方強調,大型模型的推理模式蒸餾到小模型後,表現優於直接在小模型上跑強化學習。
DeepSeek-R1 的基準測試表現如何?
母模型 MATH-500 達 97.3 分、MMLU-Pro 84.0 分,貼近同期頂級閉源模型;蒸餾版 Qwen-32B 於 AIME 2024 得 72.6 分。
官方公布的評測涵蓋英文理解、程式、數學與中文四大類。在不需採樣的基準上,DeepSeek-R1 於 MATH-500 取得 97.3 分,MMLU-Pro 為 84.0 分,DROP 為 92.2 分,ArenaHard 為 92.3 分,多項指標超越同期的閉源模型。
程式能力方面,它在 LiveCodeBench 取得 65.9 分,Codeforces 評分 2,029 分,SWE Verified 解題率 49.2 分;中文基準上,C-Eval 為 91.8 分,CLUEWSC 為 92.8 分。官方提醒,採樣類基準以溫度 0.6、top-p 0.95 並取六十四次回應估計,使用時應比照相同設定。
蒸餾版本的表現同樣受到關注。DeepSeek-R1-Distill-Qwen-32B 在 AIME 2024 取得 72.6 分,MATH-500 為 94.3 分,CodeForces 評分 1,691 分;DeepSeek-R1-Distill-Llama-70B 則在 AIME 2024 共識解與 MATH-500 上分別達 86.7 分與 94.5 分。
如何在本地執行 DeepSeek-R1?
母模型需參考 DeepSeek-V3 的部署說明;蒸餾版本可如 Qwen 或 Llama 模型般以 vLLM 或 SGLang 啟動,官方建議溫度設在 0.5 至 0.7。
完整母模型的本地執行方式,官方指向 DeepSeek-V3 的儲存庫,並提醒 Hugging Face 的 Transformers 尚未直接支援。對多數開發者而言,更實際的路徑是使用蒸餾版本,因為它們與既有的稠密模型工具鏈相容。
以 vLLM 為例,可透過命令列指定模型名稱、張量平行數量與最大長度後啟動服務;SGLang 亦提供對應的啟動參數,並需開啟遠端程式碼信任選項。兩者都能在消費級多卡環境上運行較小的蒸餾版本。
# 以 vLLM 啟動 32B 蒸餾版本
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B \
  --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager

# 以 SGLang 啟動同一模型
python3 -m sglang.launch_server \
  --model deepseek-ai/DeepSeek-R1-Distill-Qwen-32B \
  --trust-remote-code --tp 2
官方同時列出多項使用建議。溫度應設在 0.5 至 0.7 之間,以免出現無止境重複或語意不連貫;不建議加入系統提示,所有指令應寫在使用者提示之中;處理數學問題時,可要求模型逐步推理並把答案放入方框標記。團隊也觀察到模型有時會略過思考區塊,建議在提示開頭強制要求它先輸出思考標記。
DeepSeek-R1 的專案數據與授權條款為何?
- 91,940GitHub 星標
- 11,661複製次數
- 671B總參數
- 128K上下文長度
- MIT授權條款
- 2025-01-20建立日期
截至二零二六年十月,專案累積 91,940 顆星標與 11,661 次複製,程式碼與權重皆採 MIT 授權,允許商業使用與蒸餾。
專案於二零二五年一月二十日建立,並在同日釋出模型權重與研究論文,形成罕見的「開源即論文」發布節奏。倉庫最新版本標記為 v1.0.0,於二零二五年六月發布,其後未再有大版本變動,反映這是一份以模型與文件為核心、而非持續迭代的軟體專案。
授權條款是它廣受採用的重要原因。程式碼與模型權重皆採 MIT 授權,支援商業使用,並允許任何修改與衍生作品,包括用來蒸餾訓練其他大型語言模型。官方同時說明,蒸餾版本因基礎模型不同而帶有各自的原始授權限制,例如 Qwen 系列源自 Apache 2.0,Llama 系列則需遵循 Meta 的社群授權。
DeepSeek-R1 對開源推理模型生態有什麼影響?
它證明了推理能力可純由強化學習獲得,並以 MIT 授權開放權重與蒸餾版本,使小型團隊也能取得推理模型能力,直接推動了其後一波以推理為核心的開源模型與工具。
在 DeepSeek-R1 之前,具備長鏈推理能力的模型多由少數機構以閉源方式提供。它把完整訓練方法、評測數據與多尺寸權重一併公開,等於把推理模型的入場門檻大幅拉低。
這種開放策略產生兩層影響。其一是技術層面,蒸餾版本讓資源有限的團隊能在單一節點上部署具推理能力的模型,不必自行從頭訓練。其二是方法層面,純強化學習可誘發推理的結論,成為後續研究的重要起點,也讓業界重新評估監督式微調在推理任務中的必要性。
代價則是,模型的原始發布距今已有一段時間。在它之後,社群陸續出現更新一代的推理模型與工具鏈,實際選型時仍需與較新的替代方案比較。
出處連結有哪些?
本文資訊整理自 DeepSeek-R1 的 GitHub 儲存庫與官方 README,模型規格、基準數據與部署指令均可於儲存庫查閱。
完整的專案資訊、模型下載與技術文件,可於下列來源查閱:
- DeepSeek-R1(deepseek-ai/DeepSeek-R1)GitHub 儲存庫
- DeepSeek-R1 模型頁(Hugging Face)
- DeepSeek-R1 研究論文(arXiv:2501.12948)
常見問題有哪些?
以下整理四個常見疑問,涵蓋授權費用、本地執行、蒸餾版本差異與提示設定,答案均以官方 README 與授權條款為依據。
DeepSeek-R1 需要付費才能使用嗎?
不需要。程式碼與模型權重採 MIT 授權,可免費下載與商業使用,僅需保留授權聲明。
可以在自己的電腦上執行嗎?
母模型需多卡高階硬體與 DeepSeek-V3 的部署環境;一般使用者建議改用 15 億至 700 億參數的蒸餾版本,並以 vLLM 或 SGLang 啟動。
蒸餾版本和母模型有什麼差別?
蒸餾版本以 DeepSeek-R1 產生的推理資料微調稠密模型而成,體積較小、易於部署,但基礎模型不同也帶來各自的原始授權限制。
使用時需要調整提示或溫度嗎?
建議溫度設在 0.5 至 0.7,避免加入系統提示,並在提示開頭要求模型先輸出思考標記,以確保完整推理。
總結:DeepSeek-R1 適合什麼團隊?
適合需要低成本取得推理能力、可接受自行部署的中小型團隊與研究者;若追求開箱即用或最新一代推理表現,則宜同時評估較新的替代模型。
DeepSeek-R1 的價值,在於把「推理能力從何而來」這個問題,明確回答成「可以純粹由強化學習獲得」。九萬多顆星標與 MIT 授權,讓它成為開放推理模型的重要基準點。
評估是否採用時,建議先確認兩件事:團隊能否負擔本地部署的硬體與維運成本,以及應用場景是否真的需要長鏈推理。兩項條件都符合時,它提供了一條相對低成本、且授權寬鬆的推理模型路徑。