
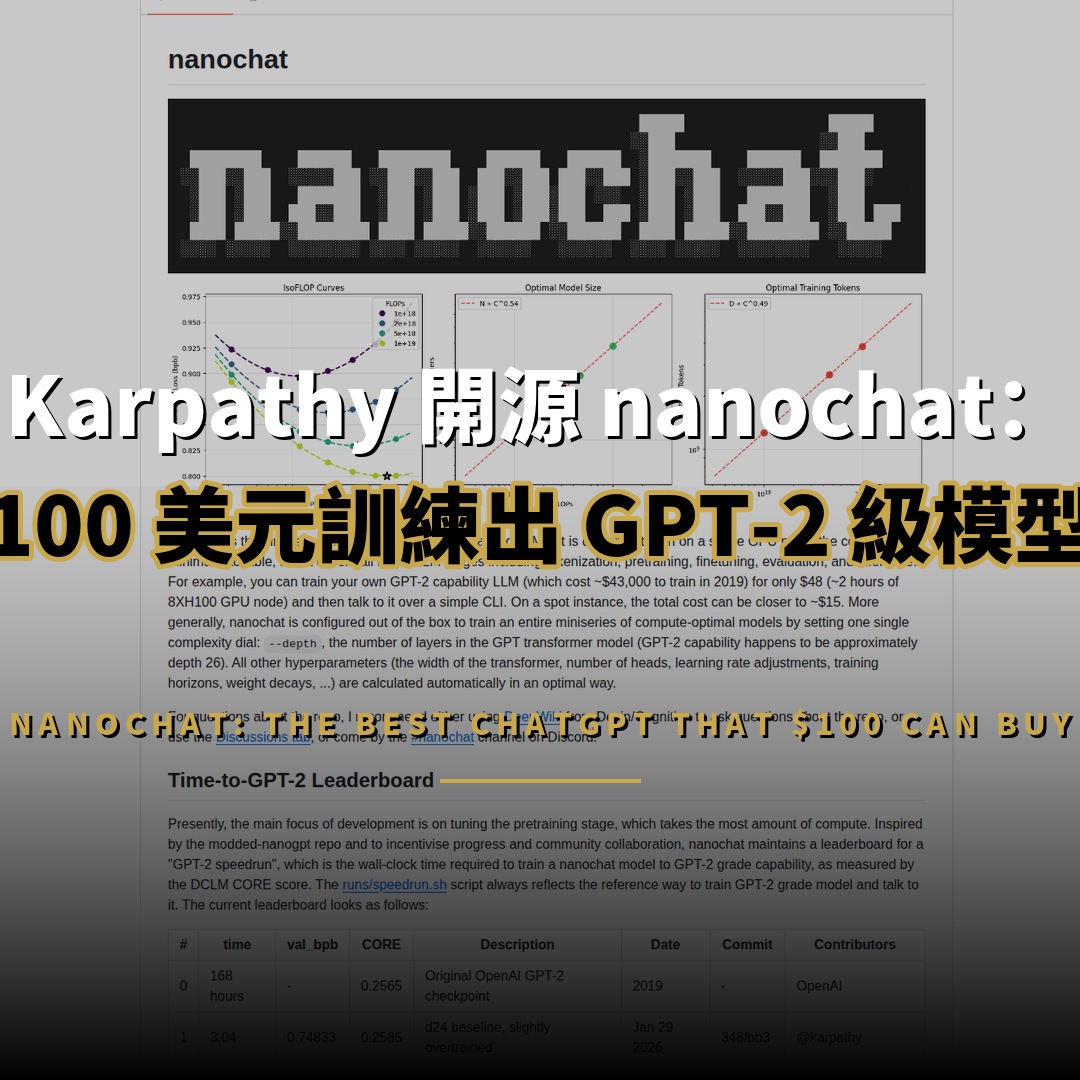
nanochat 是由 OpenAI 前研究科學家 Andrej Karpathy 於二零二五年十月發布的開源專案,目標是在單一 GPU 節點上以極簡程式碼走完大型語言模型的完整訓練流程。截至二零二六年十月,該專案在 GitHub 累積 58,385 顆星標,官方標語為「一百美元能買到最好的 ChatGPT」,主打以約四十八美元的雲端算力訓練出具備 GPT-2 等級能力的對話模型。
nanochat 是 Karpathy 於 2025 年 10 月發布的開源專案,可在單一 GPU 節點以約 48 美元訓練出 GPT-2 等級對話模型,星標達 58,385 顆。

nanochat 是什麼?
nanochat 是一套單 GPU 的極簡大型語言模型訓練工具,涵蓋分詞、預訓練、微調、評估與推論,讓個人研究者能以低預算完成端到端訓練。
README 把專案定位為「訓練大型語言模型最簡單的實驗框架」。它刻意設計成單一 GPU 節點即可運行,程式碼規模精簡且易於修改,並涵蓋語言模型的所有主要階段,包括分詞器訓練、預訓練、監督式微調、評估與推論。使用者只要執行一個腳本,就能訓練出模型並透過命令列與它對話。
這種設計的核心訴求是降低門檻。專案提供一個參考腳本,讓使用者在 8 張 H100 的節點上約兩小時內完成一次 GPT-2 等級模型的訓練,之後即可在終端機與模型聊天。程式碼同時可在單張 GPU 上運行,只是耗時約為八倍,硬體門檻因此更具彈性。
nanochat 的訓練成本與效能表現如何?
當年在 2019 年需約 43,000 美元訓練的 GPT-2,如今以 nanochat 只需約 48 美元、約兩小時,競價執行個體更可低至約 15 美元。
成本對比是這個專案最受關注的數據。OpenAI 在二零一九年訓練 GPT-2 的花費約為 43,000 美元,而 nanochat 依官方基準,在 8 張 H100 節點上約兩小時、約 48 美元即可達到相近的 CORE 分數;若採用競價執行個體,總成本可進一步降至約 15 美元。專案以每 GPU 每小時約 3 美元的行情估算,節點成本約每小時 24 美元。
效能進展則記錄在「Time-to-GPT-2」排行榜。該榜以訓練達到 GPT-2 CORE 分數所需時間為指標,從二零二六年一月二十九日的 3.04 小時,逐步壓縮至三月十四日的 1.65 小時,主要來自資料集更換、批次大小調整與自動研究等改進。README 亦指出,目前瓶頸集中於預訓練階段,社群正持續縮短該階段耗時。
nanochat 的架構與技術設計有什麼特點?
nanochat 以單一 depth 參數自動決定模型寬度、注意力頭數、學習率與訓練期程等超參數,並以 Muon 與 AdamW 混合優化器訓練。
最鮮明的設計是「單一複雜度旋鈕」。使用者只需指定 Transformer 的層數,其餘超參數會自動推算,包括模型寬度、注意力頭數、學習率調整、訓練步數與權重衰減,使產出的模型維持在運算最佳狀態。GPT-2 等級大致落在二十四至二十六層之間,使用者只需調整一個整數,即可得到不同規模的模型系列。
精度管理也採取顯式做法。專案不使用 PyTorch 的自動混合精度機制,而是以一個全域參數控制運算精度,並依硬體自動選擇。A100 與 H100 等新架構預設使用 bfloat16,較舊的顯示卡改用 float32,CPU 與 Apple Silicon 亦以 float32 為安全預設。這種安排讓不同硬體都能取得合理的記憶體占用與速度。優化器方面,專案將 Muon 與 AdamW 整合為單一實作,同時支援單卡與分散式訓練。
nanochat 的社群與專案數據如何?
- 58,385GitHub 星標
- 8,180複製次數
- 123待處理議題
- 379追蹤者
- 51貢獻者
- MIT主要授權
截至二零二六年十月,nanochat 累積 58,385 顆星標、8,180 次複製、123 個待處理議題與 379 位追蹤者,採 MIT 授權並以 Python 撰寫。
專案自二零二五年十月建立,四個月內即累積逾五萬顆星標,顯示社群對「低預算端到端訓練」的需求強烈。目前貢獻者超過五十人,最新一次程式碼提交落在二零二六年七月三日,內容包括推論效能基準測試、測試補強與優化器實作整合。專案並未發布正式版本標籤,而是以主分支持續演進。
生態方面,社群已衍生多個分支與重製版本,包括將訓練流程移植到其他平台、以 WebGPU 在瀏覽器運行,以及在 Hugging Face 上發布訓練完成的模型權重與可執行筆記本。官方亦維護一份涵蓋 GPT-2 能力訓練的完整指南,記錄從成本壓縮到評測口徑的各項細節,使後續研究者能沿用同一套基準。

nanochat 與 nanoGPT 有什麼關係?
nanochat 由 nanoGPT 演進而來,在預訓練之外補上分詞、微調、評估與推論,形成可實際對話的完整端到端流程。
nanochat 的名稱來自同一作者的早期專案 nanoGPT。nanoGPT 只處理預訓練階段,以約三百行程式碼重現 GPT-2 的訓練過程,是廣被引用的教學實作;nanochat 則在此基礎上擴充為完整管線,補上分詞器、監督式微調、獎勵式微調、評估與推論引擎。
官方已在 nanoGPT 的說明中公告,該專案的開發重心轉移至 nanochat,原專案進入維護狀態並保留作為教學參考。換言之,兩者的分工是教育與實作的延續關係:nanoGPT 適合理解預訓練原理,nanochat 則提供可直接對話的成果與更完整的實驗介面。

如何開始使用 nanochat?
使用者先以 uv 安裝 GPU 或 CPU 版本依賴,再執行官方 speedrun 腳本完成訓練,最後透過命令列與模型對話。
專案以 uv 管理相依套件。使用者依硬體選擇 GPU 或 CPU 版本安裝後,即可執行官方提供的 speedrun 腳本完成一次完整訓練;腳本設計為在 8 張 H100 節點上運行,約一點五小時結束。若要在 CPU 或 Apple Silicon 上體驗,官方另備一個縮小模型規模的範例腳本,訓練時間可壓縮至數十分鐘。
uv sync --extra gpu     # CUDA 環境
uv sync --extra cpu     # CPU 或 Apple Silicon
bash runs/speedrun.sh
python -m scripts.chat_cli
需要留意的是,若顯示卡記憶體低於八十 GB,必須下調批次大小以避免記憶體不足。專案亦建議研究者改動程式碼後以短時訓練快速驗證,並透過驗證損失、CORE 分數與硬體使用率三項指標判斷改動是否有效。
出處連結有哪些?
本文資訊整理自 karpathy/nanochat 的 GitHub 儲存庫,訓練數據、排行榜與授權條款均可在該儲存庫查閱。
完整的專案資訊、訓練指南與討論紀錄,可於下列來源查閱:
常見問題有哪些?
以下整理四個常見疑問,涵蓋硬體需求、訓練成本、與 nanoGPT 的差異及授權範圍,答案均以官方文件為準。
nanochat 一定要用 8 張 H100 才能訓練嗎?
不是。程式碼亦可在單張 GPU 或 CPU、Apple Silicon 上運行,只是耗時較長。官方另有縮小模型規模的範例腳本,適合先體驗流程。
訓練一個 GPT-2 等級模型要花多少錢?
依官方基準,在 8 張 H100 節點上約兩小時、約 48 美元;若使用競價執行個體,總成本可降至約 15 美元。
nanochat 與 nanoGPT 該怎麼選?
nanoGPT 聚焦預訓練教學,適合理解原理;nanochat 涵蓋完整管線並可實際對話,適合想端到端實作的開發者。官方已建議轉向 nanochat。
可以用於商業專案嗎?
專案採 MIT 授權,允許商業使用與修改,使用前仍建議確認相關資料集與模型權重的個別授權條款。
總結:nanochat 適合什麼團隊?
nanochat 適合想在有限預算內理解並實作大型語言模型全流程的研究者與教學者;追求生產級部署的團隊則需另行評估。
nanochat 的價值在於把大型語言模型的完整訓練流程壓縮到可負擔的規模。當一次 GPT-2 等級的訓練成本從六位數美元降到數十美元,個人研究者與小型團隊便有機會親手走完整條管線,而不必依賴大型機構的算力。近六萬顆星標與持續的社群分支,說明這種「可動手」的定位確實填補了市場缺口。
評估時可用三個問題判斷是否合適:是否需要理解模型訓練的每個環節、是否具備單一 GPU 節點的算力、以及目標是教學研究還是生產部署。若答案偏向學習與實驗,nanochat 是門檻最低的選擇之一;若需求是服務大量使用者或訓練超大模型,仍需轉向更完整的分散式訓練框架。
本文僅作技術與生態層面的整理,實際訓練前建議先依官方文件確認硬體需求、資料集授權與最新版本行為。