
bojieli/ai-agent-book 是一本由開發者李博杰開源的人工智能代理教科書,在 GitHub 累積 50,755 顆星標與 5,694 次複製。該倉庫以 Apache-2.0 授權公開全書正文、配圖與 109 個配套實驗,並提供 15 種語言的 PDF 與 EPUB 版本,曾被列為 GitHub Trending 當日熱門專案之一。
bojieli/ai-agent-book 是李博杰開源的 AI Agent 教科書,星標達 50,755 顆,10 章正文、109 個實驗與 15 種語言譯本全部免費公開。
人工智能代理是近兩年最擁擠的技術賽道,但公開資料呈現兩極:一端是零散的部落格文章與官方文件,另一端是收費課程與封閉教材。一本完整、可引用、又能親手複現的開源教科書,正好填補中間那段落差。
AI Agent 開源教科書是什麼?
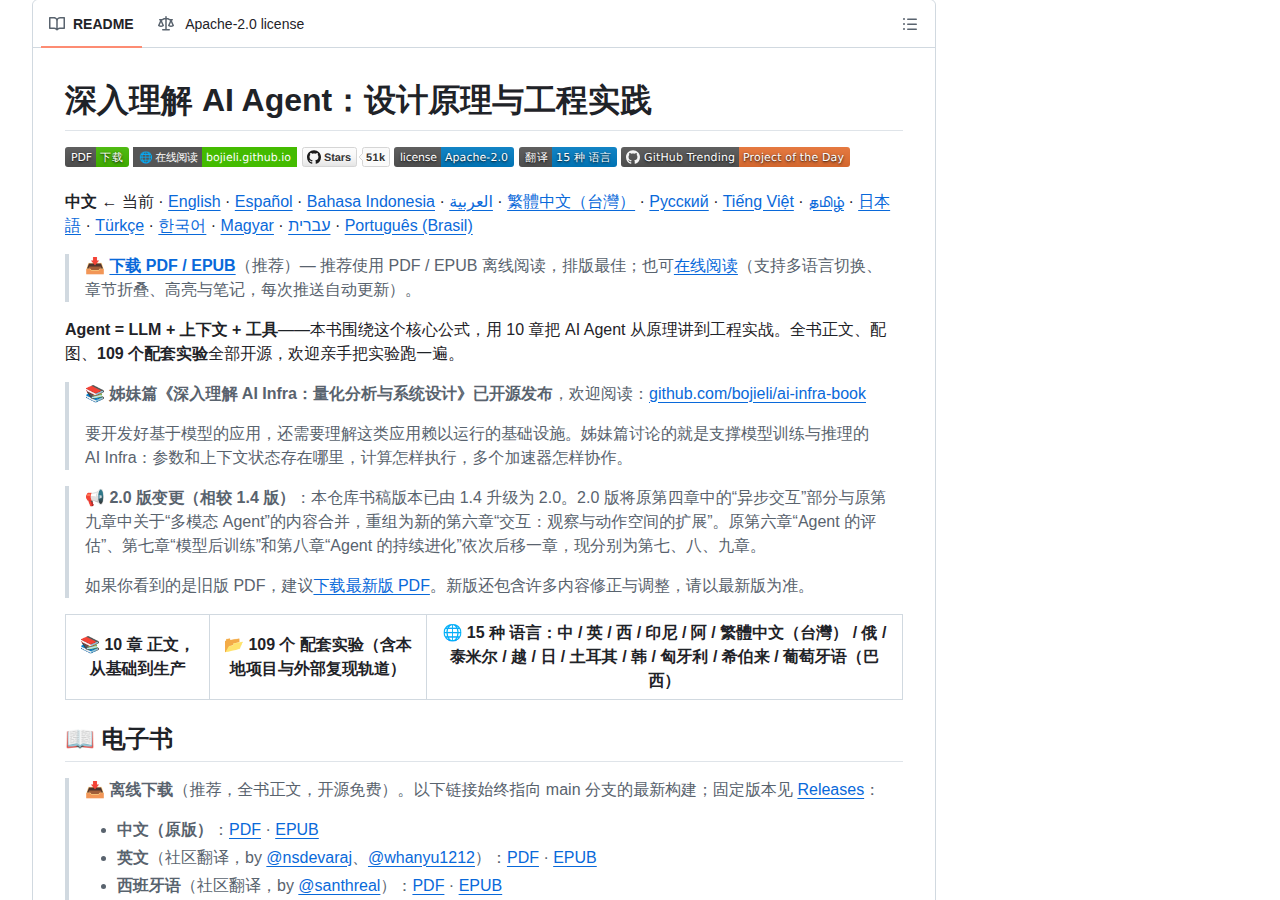
它是一本開源的 AI Agent 工程教材,正文圍繞「Agent = LLM + 上下文 + 工具」展開,共 10 章,涵蓋上下文工程、記憶、工具、評估與多 Agent 協作。
這本書的定位是工程實作導向,而非學術綜述。全書十章由入門概念層層推進:第一章建立代理的基本模型,第二至四章拆解上下文工程、用戶記憶與知識庫、工具設計,第五章進入 Coding Agent 與通用代理的生產級實踐。
後半部轉向工程閉環。第六至九章處理交互擴展、代理評估、模型後訓練與持續進化,第十章則討論多代理協作的群體智能。每一章都對應一批可執行的實驗專案,把書中的設計原則落到具體程式碼。
這本書的作者與背景是什麼?
倉庫由作者李博杰於 2025 年 9 月建立,書稿現為 2.0 版,採用 Apache-2.0 授權,並曾登上 GitHub Trending 當日熱門專案之一。
倉庫建立於 2025 年 9 月 9 日,作者為李博杰,同期另有姊妹篇《深入理解 AI Infra:量化分析與系統設計》開源發布。兩本書的關係是分層的:一本討論代理的設計原理,另一本討論支撐模型訓練與推理的基礎設施。
書稿版本在 2026 年推進至 2.0,主要變動是把原第四章的異步交互與原第九章的多模態代理合併重組為新的第六章,後續章節順延。這類結構調整反映作者把教材當作持續迭代的專案維護,而非一次性定稿。
Apache-2.0 授權是另一個關鍵設定。它允許商業使用、修改與再發布,意味著企業可以直接把書稿與實驗程式碼納入內部培訓,只須保留版權聲明。對於需要自建 AI 能力卻不希望受制於課程授權的團隊,這個條款降低了採用門檻。
這本書的核心框架是什麼?
全書以「Agent = LLM + 上下文 + 工具」為公式,十章由入門、上下文工程、記憶、工具、Coding Agent 推進到評估與多 Agent 協作。
全書圍繞一個等式組織:代理等於模型加上下文加工具。這個框架把討論焦點從模型參數轉移到工程能力,作者的立場很清楚——在模型能力逐漸同質化的環境下,真正的差異來自上下文與工具這一層的設計。
第二章是份量最重的一章,處理上下文工程。內容涵蓋 KV Cache 機制、提示工程、代理技能封裝與上下文壓縮,核心觀點是上下文決定能力上限,而非模型規模。第三章轉向跨會話記憶與外部知識接入,討論用戶記憶、檢索增強生成、結構化索引與知識圖譜的取捨。
第四、五章則處理代理的「雙手」與最具代表性的應用形態。工具章節包含 MCP 協議與感知、執行、協作三類工具的主動發現機制;Coding Agent 章節則把程式碼視為「能創造新工具的工具」,拆解生產級代理需要的完整工程環節。
全書十章分別涵蓋什麼主題?
第一章講代理入門,第二至四章為上下文工程、記憶與知識庫及工具,第五章為 Coding Agent,第六至九章談交互、評估、後訓練與持續進化,第十章是多代理協作。
從章節安排可以看出漸進式的學習曲線。前五章構成從原理到可用代理的主幹,其中工具與 Coding Agent 兩章直接對應實務上最常落地的場景;後五章則處理把原型推進到生產所需的工程環節。
評估一章的內容值得單獨留意。它討論評估環境建置、指標選擇與統計顯著性,並主張以評估結果驅動模型選型。對已經做出原型、卻無法判斷改動是否有實際提升的團隊而言,這一章提供的是可量化的判斷框架。
後訓練與持續進化兩章則觸及模型層面的調整。前者區分監督微調與強化學習的適用時機,討論工具調用能力如何內化;後者主張從運行軌跡中提取學習信號,更新知識、指令、程序與參數。第十章收尾於多代理協作,討論上下文共享與隔離的設計取捨。
109 個配套實驗如何運行?
109 個實驗按章分佈,統一支援 Python 3.11 至 3.13,可用 uv 鎖定環境或 pip 安裝,讀者按章執行即可複現範例,部分實驗需自備模型 API 金鑰。
實驗是這本書與一般教材最大的分野。109 個專案按章節歸檔,共用統一的環境管理方式:倉庫提交了 uv 鎖定檔,讀者以章節為單位同步依賴,把序號替換即可切換環境,未安裝 uv 的環境則改用 pip 從設定檔解析。
部分實驗涉及瀏覽器、CUDA、FFmpeg 與 Playwright 等系統依賴,需依各章說明另外安裝。若要呼叫模型,需在倉庫根目錄或實驗自身目錄配置至少一組供應商金鑰,支援的來源涵蓋國際與中國大陸主流平台。
作者對實驗的態度相當坦白。書中明言配套程式碼全部由程式設計代理依書稿生成,作者本人亦不會逐行閱讀,重點在於理解架構與設計原則,再讓人工智能負責實作與除錯,人類負責最初的設計與最終的驗收。這種分工本身就是書中主張的縮影。
這本書提供哪些語言版本?
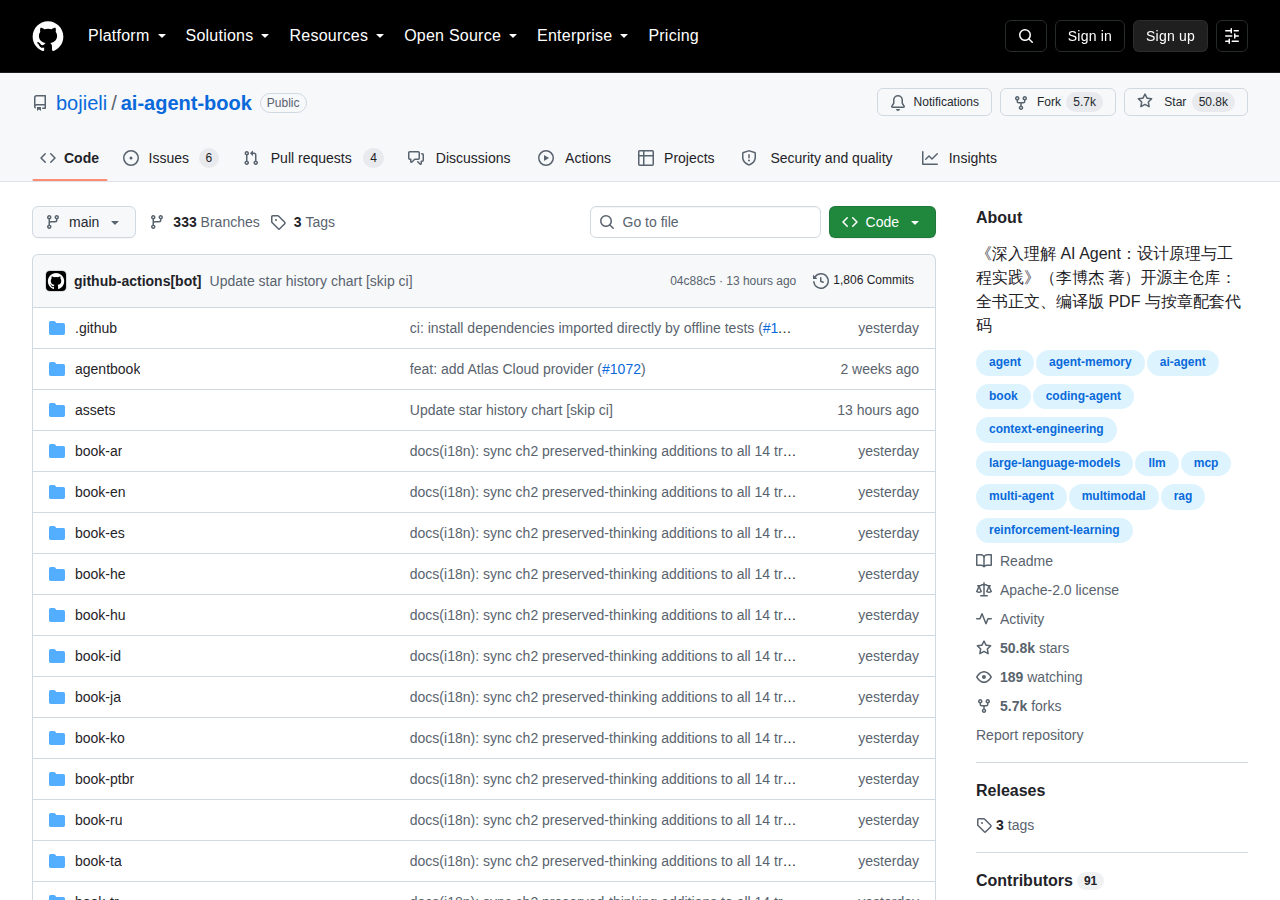
書稿提供 15 種語言的 PDF 與 EPUB,社群累積 91 位貢獻者;近期提交紀錄顯示作者累計 734 次提交,另有約 335 次由 AI 工具協作產生。
除了中文原版,倉庫收錄英文、西班牙文、印尼文、阿拉伯文、繁體中文(台灣)、俄文、泰米爾文、越南文、日文、土耳其文、韓文、匈牙利文、希伯來文與葡萄牙文(巴西)版本,全部提供 PDF 與 EPUB 下載,另設有線上的多語言閱讀版。
翻譯由社群貢獻,倉庫明確標示各譯本可能滯後於中文原版,並以中文目錄為正本,修改正文只需調整中文版。這個治理規則降低了多語言同步的維護成本,也讓翻譯品質的責任邊界保持清楚。
社群參與度可從貢獻者結構觀察。倉庫累積 91 位貢獻者,近三個月的提交紀錄顯示作者本人約 734 次,另有約 335 次由人工智能工具協作產生,其餘來自翻譯與勘誤。這種由作者主導、人工智能輔助、社群補齊的協作模式,與書中討論的多代理協作主題形成有趣的對照。
專案的數據規模如何?
- 50,755Stars
- 5,694Forks
- Apache-2.0License
- Python主要語言
- 2026-09-24最近更新
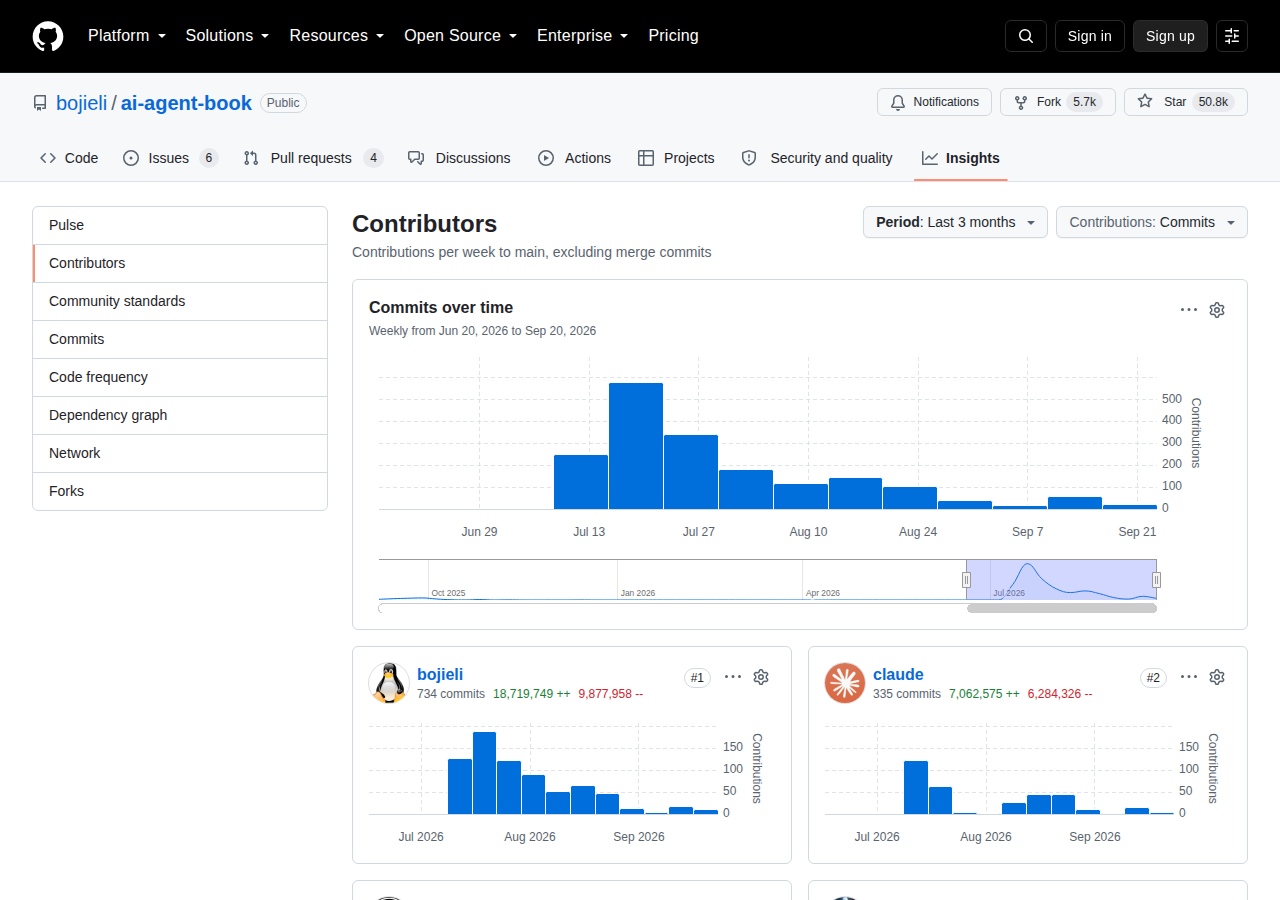
截至 2026 年 9 月 24 日,專案累積 50,755 顆星標、5,694 次複製與 189 位追蹤者,未解決議題 10 項,主要語言為 Python,採 Apache-2.0 授權。
上述數據取自專案的公開統計,時間點為 2026 年 9 月 24 日。倉庫建立至今約一年,星標數突破五萬,複製次數達 5,694 次,追蹤者 189 位,未解決議題維持在 10 項的低水位。
這種議題數量與星標數的比例在大型倉庫中並不常見,反映維護者對議題的處理相當積極。儲存庫在 9 月下旬仍有提交推送,內容涵蓋新章節補充、翻譯同步與閱讀器功能調整,顯示專案處於活躍維護狀態。
從技術堆疊的分布也能看出專案形狀。以程式碼量計,Python 佔絕大多數,其餘為網站建置與書稿排版所需的 JavaScript、TypeScript、TeX 與 Astro 等輔助語言,說明這是一個以程式碼實驗為核心、另附閱讀網站的複合型倉庫。
這本書與其他 AI Agent 教材有什麼差異?
多數 AI Agent 教材停於概念,此書把設計原則與可執行實驗並列,並開放全部書稿與程式碼,讀者能對照正文親自複現,而非只讀抽象架構。
差異體現在三個層面。第一是開放程度,全書正文、配圖、實驗程式碼與編譯用原始檔全部進入版本控制,讀者可以逐章閱讀,也能直接檢視對應實作,而非只拿到投影片與摘要。
第二是工程顆粒度。一般教材傾向講述架構與名詞,此書把討論推進到 KV Cache 前綴變動如何令歷史思考失效、工具調用能力如何透過後訓練內化、評估集如何驅動選型等具體議題。這些內容對已經在做代理產品的團隊更具參考價值。
第三是維護方式。書稿以版本號迭代,並以中文目錄為正本同步多語言譯本,配合活躍的提交節奏,內容會隨技術變化更新。對於變化極快的代理領域,持續維護比一次成書更實際,代價則是讀者需要留意版本差異。
出處連結有哪些?
本文資訊整理自 bojieli/ai-agent-book 的 GitHub 儲存庫、README 與線上閱讀版,內容涵蓋章節架構、實驗清單、多語言譯本與授權條款。
本文內容整理自 bojieli/ai-agent-book 的 GitHub 儲存庫(https://github.com/bojieli/ai-agent-book),包含專案說明文件中的章節架構、實驗清單、電子書下載連結與授權資訊,以及公開的儲存庫統計數據。讀者可前往上述來源查閱完整書稿與各章實驗的執行說明。
總結:這本書適合什麼讀者?
此書適合具備 Python 基礎、想系統理解 AI Agent 設計的開發者,也適合作為團隊內部培訓教材;若只需入門概念,或完全沒有程式經驗,閱讀成本會偏高。
這本書的價值在於把一個快速膨脹、充斥碎片資訊的領域,整理成有主線、可複現、可持續更新的教材。它沒有停留在名詞解釋,而是以「Agent = LLM + 上下文 + 工具」這條公式貫穿十章,並用 109 個實驗把每個設計原則落到可執行的程式碼,再以 Apache-2.0 授權開放全部素材。
它的門檻也相當明確。書中列出的前置知識包括能讀寫中等複雜度的 Python、使用過主流模型產品、熟悉至少一款人工智能輔助編程工具,以及具備命令列、Git 與 API 的基本常識。對完全沒有程式經驗的讀者,這些實驗反而會成為負擔。
對於已經在做代理產品、卻苦於缺乏系統化參考的團隊,這本書提供的是可以對照、可以質疑、也可以直接改寫的底稿。一年內累積超過五萬顆星標,某種程度反映市場對這類開放工程教材的需求,長期而言,這種持續維護的開源形式很可能比一次性出版的紙本教材更貼近技術演進的速度。