
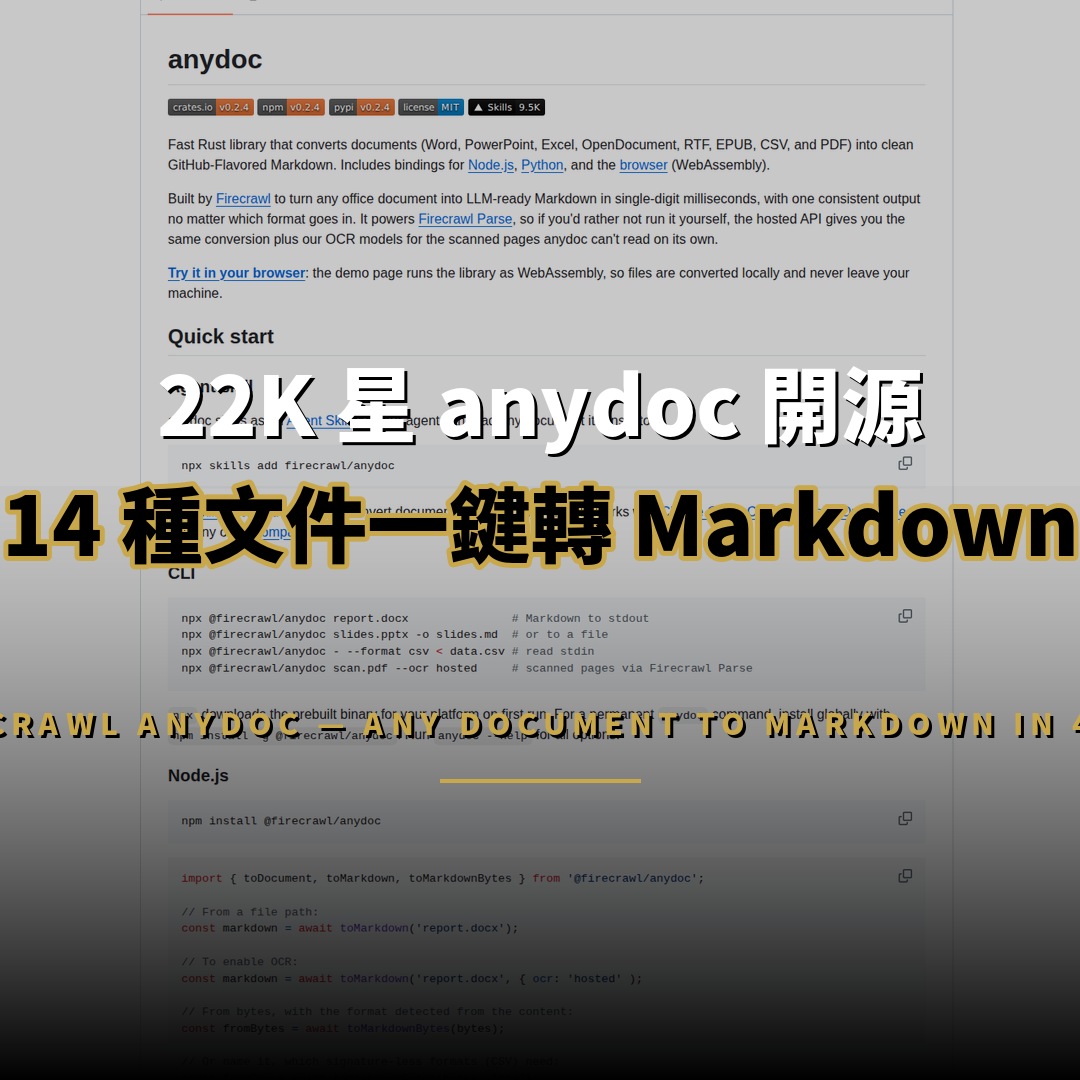
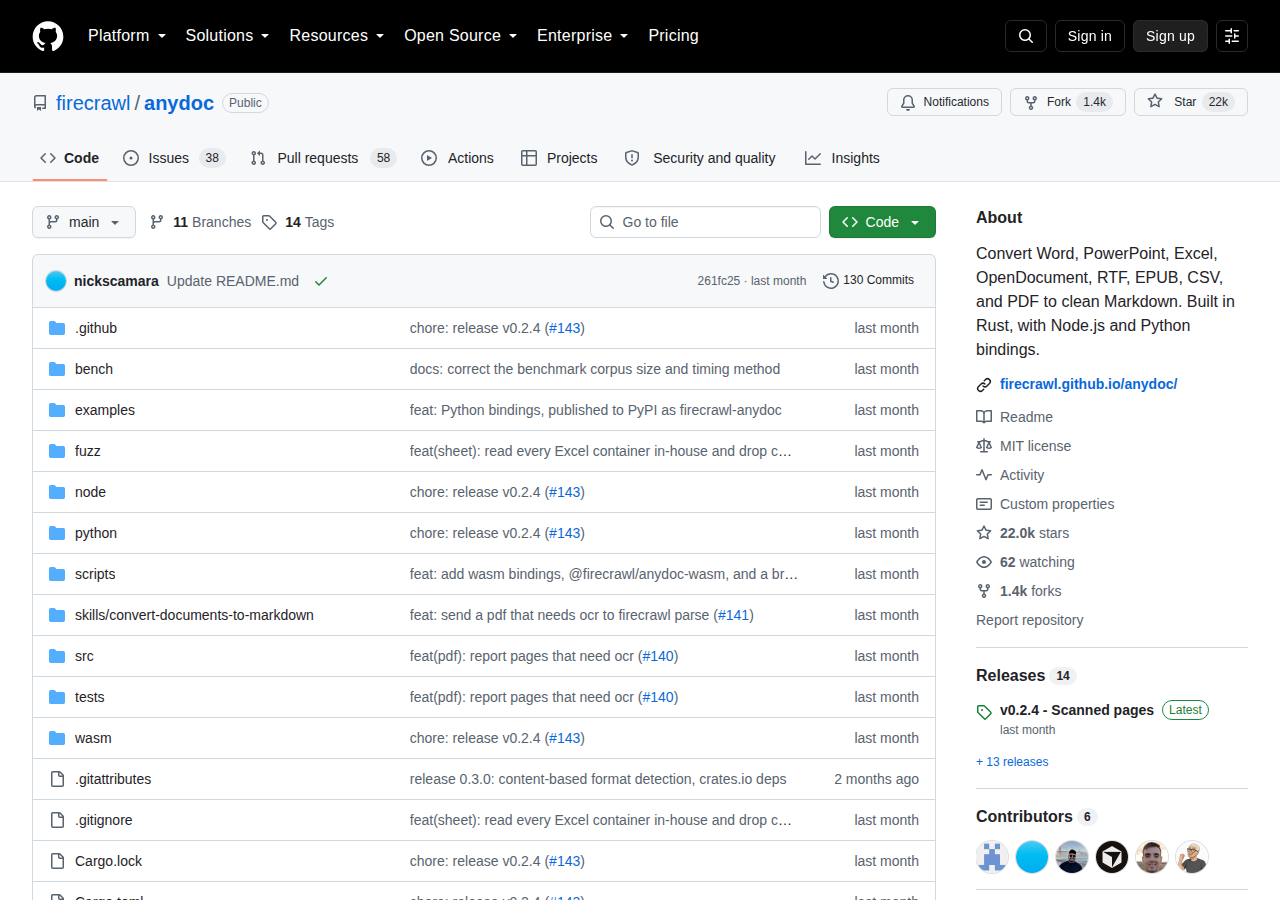
在檢索增強生成與代理工作流程中,最常被低估的環節不是模型,而是文件進得來的方式。firecrawl/anydoc 是 Firecrawl 於 2026 年 8 月開源的 Rust 函式庫,能把 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV 與 PDF 共十四種格式轉成乾淨的 GitHub 風格 Markdown,在 GitHub 累積 22,043 顆星標與 1,377 次複製。
anydoc 是 Firecrawl 開源的 Rust 轉換函式庫,把十四種辦公室文件格式統一輸出為 Markdown,中位轉換時間僅 4.4 毫秒。
多數團隊並不缺少解析工具,缺少的是一致性。當同一份內容以 PowerPoint 進來、以舊版 Word 進來、或是以掃描 PDF 進來時,轉出的 Markdown 往往在表格跳脫、標題錨點與註腳處理上各不相同,後續的清理成本往往超過轉換本身。anydoc 針對的正是這段落差。
anydoc 是什麼?
anydoc 是把辦公室文件轉為 Markdown 的轉換引擎,支援 Word、PowerPoint、Excel、PDF 等八大類格式,輸出可攜且一致。
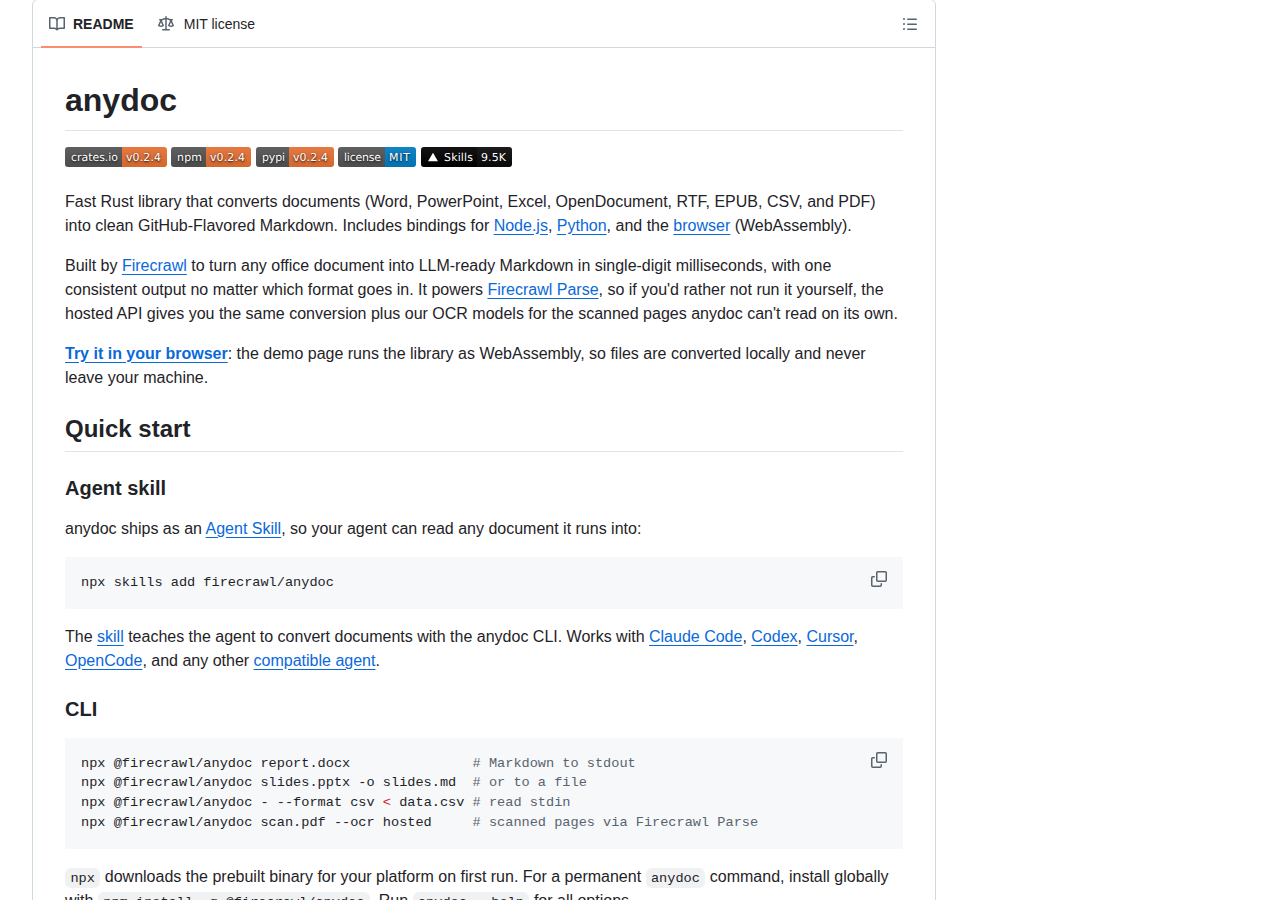
它並非獨立的桌面軟體,而是一個可嵌入的函式庫,同時以命令列工具與代理技能的形式提供。開發者可以在 Node.js 服務中呼叫它處理使用者上傳的檔案,也可以在 Python 資料管線中批次轉換,或直接在瀏覽器端以 WebAssembly 執行,讓檔案不必離開使用者裝置。
輸出的目標格式為 GitHub 風格 Markdown,適用於餵入語言模型、寫入向量資料庫或轉為靜態文件。專案的定位是把轉換這件事標準化,而不是新增另一種需要學習的標記語言。
anydoc 的開發背景與來源是什麼?
anydoc 由 Firecrawl 團隊於 2026 年 8 月開源,採 MIT 授權,主語言為 Rust,同時是 Firecrawl Parse 服務的底層轉換引擎。
專案由 Firecrawl 團隊建立與維護,儲存庫於 2026 年 8 月 3 日公開,採 MIT 授權,主要語言為 Rust。它同時是 Firecrawl Parse 的底層引擎,官方說明指出,若使用者不願自行部署,託管 API 會提供相同的轉換結果,並補上 anydoc 無法處理的掃描頁面光學辨識能力。
除函式庫本身,專案亦以代理技能形式發布,一行安裝指令即可讓代理具備讀取辦公室文件的能力。這種從底層函式庫擴散到代理技能與託管服務的三層布局,反映它被定位為基礎設施而非單一應用。
anydoc 支援哪些文件格式?
anydoc 支援十四種格式,涵蓋 Word、PowerPoint 與 Excel 各系列,以及 OpenDocument、RTF、EPUB、CSV 與 PDF。
覆蓋範圍分為八大類。Word 類包含 doc、docx 與 docm;PowerPoint 類包含 ppt、pps、pot、pptx、pptm、ppsx 與 ppsm;Excel 類包含 xls、xlsx、xlsm 與 xlsb。OpenDocument 涵蓋文字、試算表與簡報三種,另加上 RTF、EPUB、CSV 與 PDF。
值得注意的是格式判斷方式。anydoc 不依賴副檔名,而是讀取檔案內容中的規格標記,包括 PDF 檔頭、RTF 開啟群組、OLE 串流名稱與 ZIP 封裝的 mimetype。這意味著副檔名標錯的檔案仍能正確轉換,對接收使用者上傳的服務而言可減少一類失敗情境。
anydoc 的核心技術架構有什麼特點?
架構採先解析後序列化:各格式解析成共用文件模型,再由單一序列化器輸出,修正只需做一次即可套用全部格式。
架構的核心是共用文件模型。每種格式都有專屬解析器,但解析結果全部收斂到同一個中介表示,內含區塊、行內元素、表格、註腳與資源。最終輸出由單一 Markdown 序列化器負責,因此跳脫規則、表格處理、標題錨點與註腳行為在不同格式之間保持相同。
這個設計的實際意義在於維護成本。官方說明舉例指出,為 docx 修正一次表格跳脫問題,等同同時修好了 rtf、odt 以及其他所有格式的同類問題。相較之下,若每種格式各自輸出,同一個錯誤就必須重複修補多次。
結構保留的完整度亦是重點。輸出涵蓋帶錨點的標題、粗體與斜體、行內程式碼與程式碼區塊、連結與內部交叉參照、巢狀與工作清單、含合併儲存格的表格、區塊引用、註腳與尾註,以及簡報的講者備註。Word 與 PowerPoint 的 OMML、OpenDocument 與 EPUB 的 MathML、以及 RTF 的公式,均轉為 GitHub 風格數學語法。圖片與內嵌物件會以替代文字形式出現在 Markdown 中,原始位元組則保留在文件模型上並標註媒體類型。
anydoc 的效能與基準測試表現如何?
在百份真實文件測試中,anydoc 涵蓋全部十四種格式,中位轉換 4.4 毫秒,綜合得分 81,每種受評格式皆為最高分。
基準測試涵蓋一百份真實世界文件與十四種格式,對照另外六款轉換工具。評分由語言模型擔任盲測裁判,將兩款工具的輸出與原始文件前六頁的渲染圖比對,並以交換順序各評一次以消除位置偏誤,共產生 482 份判定。
速度差距相當明顯。anydoc 的中位轉換時間為 4.4 毫秒,而 libreoffice 為 1,129.5 毫秒、unstructured 為 572.9 毫秒、docling 為 513.6 毫秒,markitdown 與 pandoc 分別為 134.8 與 102.1 毫秒。官方指出,anydoc 是唯一涵蓋全部十四種格式的工具,且在每一種受評格式上都取得最高分。測試環境為 Windows 11、Ryzen 9 9950X3D 與 64GB 記憶體,每個文件採一次暖機轉換計時。
如何快速開始使用 anydoc?
命令列可用 npx @firecrawl/anydoc;另有 Node、Python、Rust 與瀏覽器 WebAssembly 四種綁定可選。
入門門檻不高。命令列形式可直接以 npx 執行並把結果輸出到標準輸出或指定檔案,首次執行時會下載對應平台的前置編譯二進位檔。Node.js 端安裝後提供三個主要函式,分別對應依路徑轉換、依位元組轉換與取得文件模型;Python 端則以單一 to_markdown 函式搭配關鍵字參數處理。
各綁定在並行行為上另有設計。Node.js 的轉換執行於 libuv 執行緒池,不會阻塞事件迴圈;Python 綁定會釋放全域解譯器鎖,讓其他執行緒持續運作。TypeScript 型別定義與 Python 型別存根均隨套件附帶。若只需試用,官方提供以 WebAssembly 執行的線上示範頁,檔案在使用者本機完成轉換。
掃描版 PDF 要如何處理?
anydoc 只讀含文字層的 PDF,掃描頁會回報 NeedsOcr;可啟用託管辨識,送往 Firecrawl Parse 取回相同 Markdown。
架構刻意把光學辨識排除在本地流程之外。純文字 PDF 透過內建的解析元件在本機完成轉換,不需要任何外部服務;但若 PDF 只含掃描影像,轉換會以 NeedsOcr 失敗並列出受影響頁面。這是明確的取捨,換取本地路徑的零網路呼叫與可預期效能。
需要辨識時可逐項啟用。命令列加上參數、Node 傳入選項、Python 使用關鍵字參數即可,未設定金鑰時仍可使用但額度較低。官方強調只有需要辨識的文件會離開本機,且因 Parse 不支援頁面挑選,整份文件都會送出。若 Parse 無法轉換,Node 會以特定錯誤碼拒絕,Python 則拋出對應例外。Rust 套件不提供此選項,也不會發出任何網路請求。
anydoc 的專案數據規模如何?
- 22,043Stars
- 1,377Forks
- MIT授權
- Rust主要語言
- 2026-08-28最近推送
截至 2026 年 9 月,專案累積 22,043 顆星標、1,377 次複製與 62 位追蹤者,未解決議題 96 項,採 MIT 授權。
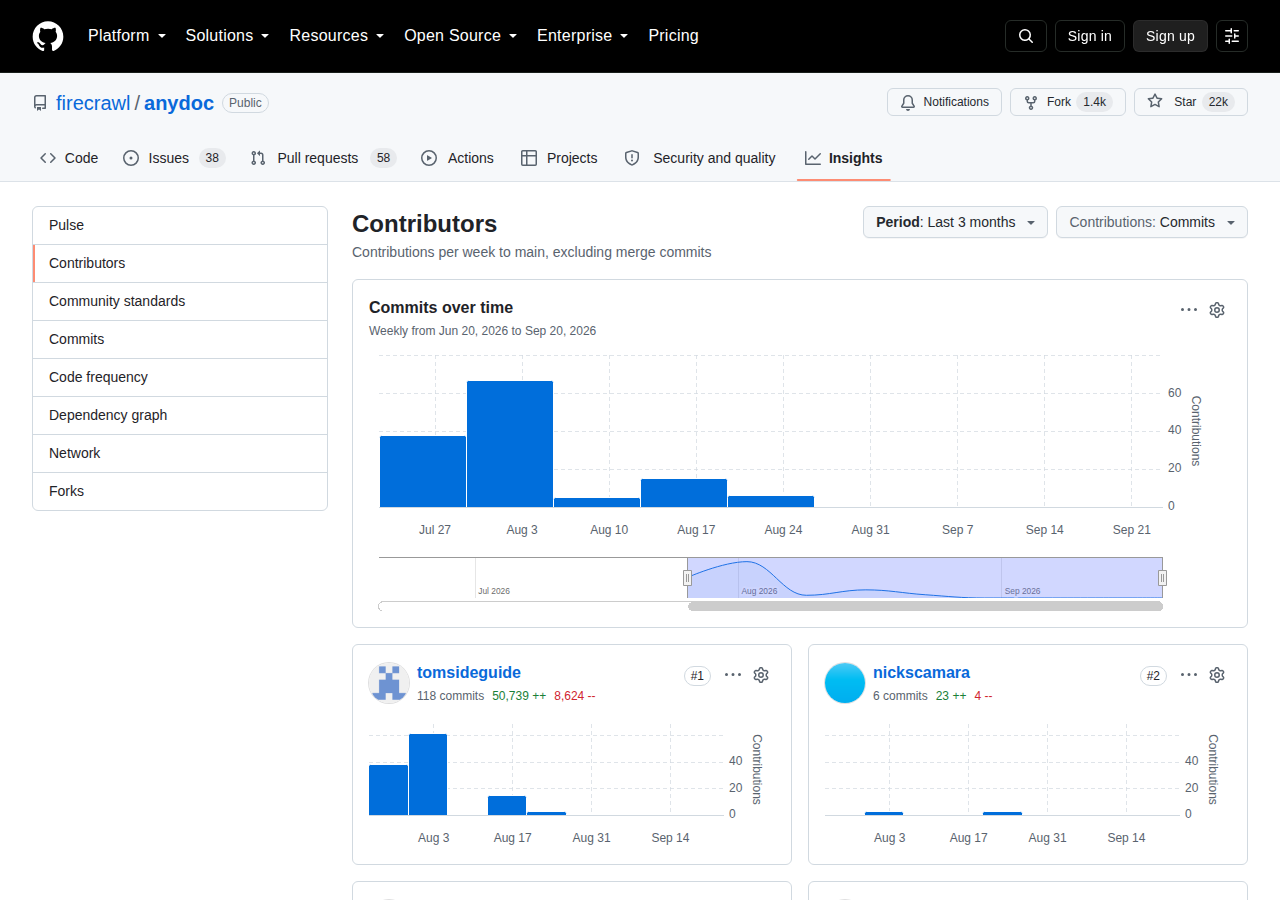
上述數據取自專案公開統計,時間點為 2026 年 9 月 25 日。儲存庫於 2026 年 8 月 3 日建立,約七週內累積逾兩萬顆星標,複製次數 1,377 次,追蹤者 62 位,未解決議題 96 項,貢獻者共 5 位。
版本節奏在八月相當密集。最近釋出為 v0.2.4,時間為 2026 年 8 月 27 日;同月稍早另有 v0.2.0 至 v0.2.3 連續四個版本,反映函式庫仍在快速迭代階段。
專案在八月先後推出四個次要版本,最近一次為 v0.2.4,顯示維護節奏穩定。發布流程由單一工作流程檔同步產出 crate、npm 套件與 PyPI 輪子檔,版本號在三處設定檔中一併更新,這種一次發行、多生態同步的做法,與其同時對外提供三種語言綁定的策略一致。
anydoc 在生態系統中的定位是什麼?
anydoc 位於文件預處理層,對照 pandoc、libreoffice、unstructured 與 docling 等工具,以全格式覆蓋與毫秒級速度區隔。
同類工具的取捨各不相同。pandoc 以格式轉換廣度見長,但對 Office 二進位格式的支援有限;libreoffice 依賴完整辦公室套件,能力全面但啟動成本高;unstructured 與 docling 偏向以模型輔助的內容理解,解析品質較好但涵蓋格式較少;mammoth 專注於 docx,輸出乾淨但範圍狹窄。
anydoc 的選擇是把範圍放在十四種格式的完整覆蓋,並以共用模型確保輸出的一致性。這使它在「什麼都收」的管線中具備優勢,尤其是需要批次處理使用者上傳文件的服務。相對地,若需求是深度版面理解或複雜表格結構還原,模型輔助類工具仍有其位置。官方對適用場景的說明亦相當明確:最適合接收混合格式辦公室文件、且需要單一一致輸出的管線。
出處連結有哪些?
本文資訊整理自 firecrawl/anydoc 的 GitHub 儲存庫與官方說明文件,涵蓋支援格式、架構、基準測試與統計數據。
本文內容整理自 firecrawl/anydoc 的 GitHub 儲存庫(https://github.com/firecrawl/anydoc),包含專案說明文件中的支援格式清單、共用文件模型的架構說明、基準測試的方法與逐格式結果、各語言綁定的安裝方式、代理技能的用法,以及公開的儲存庫統計數據與版本紀錄。讀者可前往上述來源查閱完整內容與最新版本資訊。
總結:anydoc 適合什麼樣的團隊?
anydoc 適合需要接收多種辦公室格式、並要求輸出格式一致的資料管線與代理工作流程;若需深度版面理解或本機掃描辨識,則須另作評估。
anydoc 的價值在於把一件雜事標準化。十四種格式收斂到同一套文件模型與序列化器,讓表格跳脫、標題錨點與註腳處理在各格式間保持一致,也讓維護成本集中在一處。4.4 毫秒的中位轉換時間與全格式覆蓋,使它在「什麼都收」的批次場景中具備明顯優勢。
限制同樣清楚。掃描版 PDF 需要外部託管服務,Rust 套件不做網路請求,深度版面理解並非其目標。對於正在建構文件問答、知識庫匯入或代理工具鏈的團隊而言,這是一個值得納入評估的預處理層選項。