
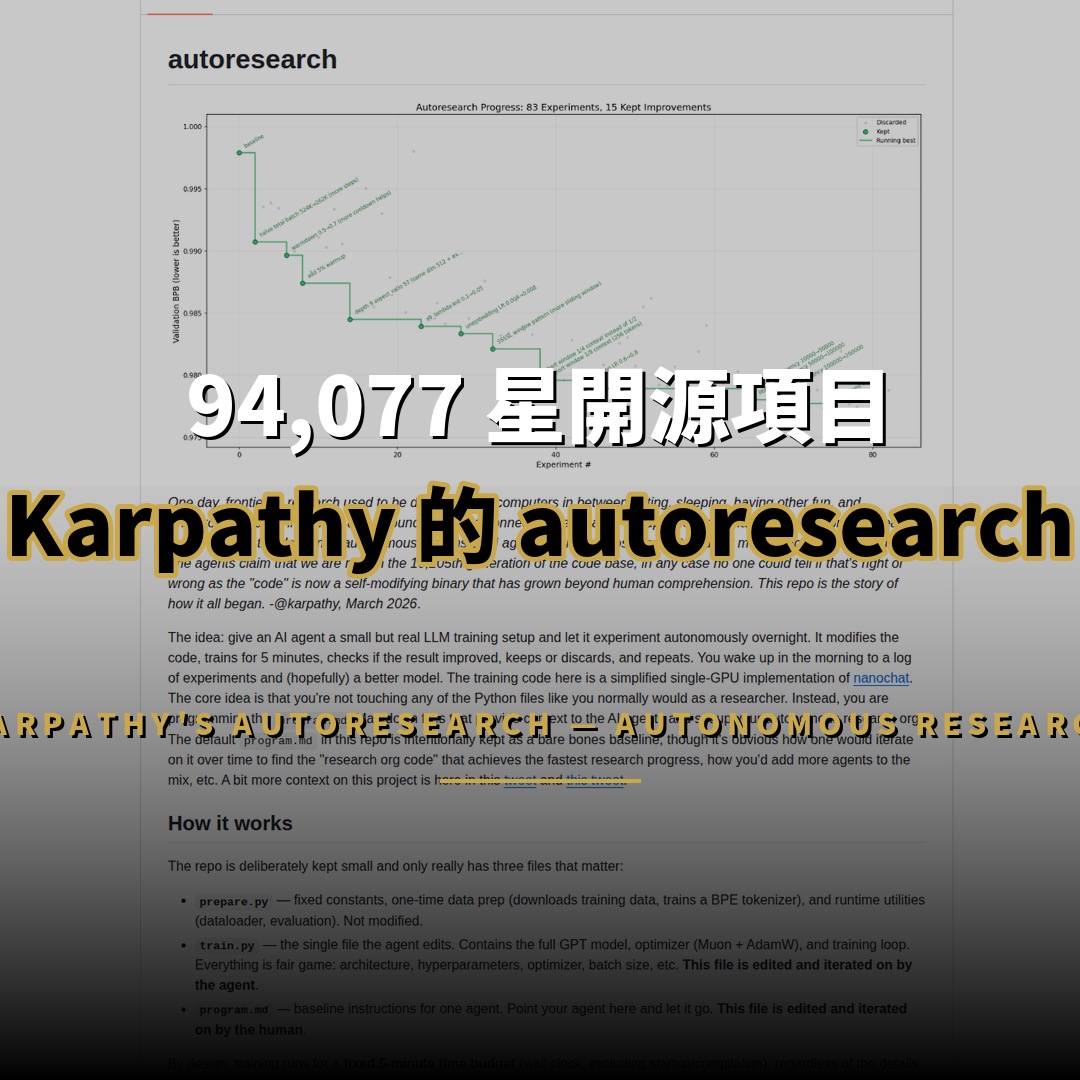
AutoResearch 是 AI 領域代表人物 Andrej Karpathy 於 2026 年 3 月推出的開源研究實驗框架,目前在 GitHub 上累積超過 9.4 萬顆星標。該項目讓 AI 代理在夜間自主修改訓練程式碼、執行固定時間的模型訓練、評估結果並保留有效改進,使人類研究者只需撰寫 Markdown 格式的指令檔案,即可啟動一個自動運行的語言模型研究組織。
AutoResearch 是什麼?
AutoResearch 是 Karpathy 推出的開源實驗框架,讓 AI 代理自主修改單 GPU 語言模型訓練程式碼、執行五分鐘固定預算的訓練並以 val_bpb 指標評估結果,反覆迭代直到找到更優模型。人類只需編輯 program.md 指令檔,即可指揮整個自動化研究流程。
AutoResearch 的核心構想來自一段帶有科幻色彩的敘事:Karpathy 在 2026 年 3 月的說明中,將這個項目描述為「自主 AI 代理群研究時代的起點」。具體而言,該框架將一個真實但簡化的語言模型訓練環境交給 AI 代理,讓它在夜間自主實驗:修改程式碼、訓練五分鐘、檢查結果是否改善、決定保留或捨棄,然後重複這個循環。使用者隔天醒來時,會得到一份完整的實驗記錄,以及一個(期望中)更好的模型。
這個項目的訓練程式碼是 Karpathy 先前 nanochat 專案的單 GPU 簡化實作。設計哲學上,AutoResearch 刻意反轉了傳統研究流程:研究者不再直接編輯 Python 檔案,而是透過編輯 program.md 這類 Markdown 指令檔,為 AI 代理提供上下文並設定「自主研究組織」的運作方式。官方保留的 baseline 版本刻意維持極簡,讓使用者可以自行迭代出更有效率的「研究組織程式碼」。
AutoResearch 的運作機制是什麼?
AutoResearch 僅由三個關鍵檔案構成:prepare.py 負責資料準備與工具函式、train.py 是代理唯一可編輯的訓練程式檔、program.md 則是人類撰寫的代理指令。訓練以五分鐘固定時間預算運行,以 val_bpb(驗證集每位元組位元數)作為唯一評估指標,每小時可執行約十二個實驗。
專案刻意保持極簡,整份程式碼庫只有三個真正重要的檔案。prepare.py 包含固定常數、一次性資料準備(下載訓練資料與訓練 BPE tokenizer)以及執行期工具函式,這個檔案不建議修改。train.py 是代理唯一會編輯的檔案,內含完整的 GPT 模型、最佳化器(Muon 搭配 AdamW)與訓練迴圈,架構、超參數、批次大小等全部開放給代理調整。program.md 則是人類與代理之間的介面,提供 baseline 指令,指向這個檔案並啟動代理即可開始實驗。
時間預算是整個設計的關鍵約束。無論運算平台為何,每次訓練都固定執行五分鐘的牆上時鐘時間(不含啟動與編譯),因此每小時約可完成十二次實驗,一個夜晚約可累積一百次實驗。固定時間預算帶來兩項優勢:其一,無論代理改變模型大小、批次大小或架構,實驗結果都具備直接可比性;其二,AutoResearch 會在該時間預算內為使用者的平台尋找最適模型。代價是不同運算平台之間的結果無法相互比較。評估指標採用 val_bpb(驗證集每位元組位元數),數值越低越好,且與詞彙表大小無關,因此架構變更可以公平比較。
AutoResearch 的技術設計亮點有哪些?
AutoResearch 的技術亮點集中在三點:單一檔案修改範圍讓差異審查可控、固定時間預算讓實驗可比較、零外部依賴的封閉設計讓部署門檻極低。整套系統僅需 PyTorch 與少量套件,不需要分散式訓練或複雜設定,單一 GPU、單一檔案、單一指標即可運作。
第一項設計亮點是「單一檔案修改範圍」。代理只能編輯 train.py,這將改動範圍限制在可審查的規模,每次實驗的差異都能被清楚檢視,避免代理在複雜程式庫中做出難以追蹤的大規模變更。這種約束同時降低了實驗失控的風險,讓自動化研究保持可解釋性。
第二項亮點是「固定時間預算」。無論代理如何調整模型複雜度,每次實驗都在五分鐘內完成,使得實驗結果在相同平台上具備橫向可比性。這項設計解決了自動化研究中最棘手的問題之一:如何在代理自主探索的過程中,維持評估的公平性與一致性。
第三項亮點是「自包含的封閉設計」。除了 PyTorch 與少量套件外沒有外部依賴,不需要分散式訓練,也不需要複雜的設定檔。目前程式碼要求單一 NVIDIA GPU(官方以 H100 測試),Karpathy 亦明確表示短期內不會自行支援 CPU、MPS 等平台,而是透過 notable forks 清單,推薦社群針對 MacOS、Windows 與 AMD 平台的改進版本。
AutoResearch 的設計選擇與限制有哪些?
AutoResearch 的設計選擇包括固定五分鐘訓練預算、單一可編輯檔案與 val_bpb 單一指標,這些約束讓實驗可比較且易於審查,但同時意味著不同平台的結果無法直接比較。目前僅支援單一 NVIDIA GPU,較小運算設備需透過社群 fork 或調整超參數才能運行。
固定時間預算的設計同時帶來兩面性。優點方面,實驗無論平台差異皆可在同一環境下比較,且框架會在給定預算內找出該平台的最適模型;缺點方面,使用者的實驗結果無法與其他運算平台上的結果對照,限制了跨環境的經驗參考價值。Karpathy 在 README 中明確記錄了這項取捨,顯示其對設計限制的透明態度。
對於沒有 H100 等級設備的使用者,官方也提供了具體的調參指引。建議改用熵值較低的資料集(例如 TinyStories),將 vocab_size 從 8192 下調至 4096、2048 甚至更低的位元組級 tokenizer,降低 MAX_SEQ_LEN 並相應調整 DEVICE_BATCH_SIZE,減少 EVAL_TOKENS 與 TOTAL_BATCH_SIZE,同時將模型複雜度主旋鈕 DEPTH 從預設 8 下調至 4,並將 WINDOW_PATTERN 改為單純的 “L” 模式。這些指引讓社群能在 Macbook 等較小設備上重現類似的自動化研究流程。
AutoResearch 的生態與社群反響如何?
AutoResearch 發布後迅速獲得社群關注,GitHub 星標突破 9.4 萬、分支超過 1.3 萬。圍繞該項目已形成跨平台 fork 生態,包括 MacOS(miolini、trevin-creator)、Windows(jsegov)與 AMD(andyluo7)版本,顯示開發者對自主 AI 研究範式的濃厚興趣。
作為 AI 領域最具影響力的開發者之一,Karpathy 的每個項目都受到高度關注,AutoResearch 也不例外。項目發布後數月內即累積超過 9.4 萬顆星標與 1.3 萬次分支,並快速衍生出針對不同平台的社群版本:miolini 的 autoresearch-macos、trevin-creator 的 autoresearch-mlx 專注 MacOS 與 Apple Silicon,jsegov 的 autoresearch-win-rtx 服務 Windows 用戶,andyluo7 的 autoresearch 則針對 AMD 平台進行適配。這些 fork 生態反映了社群對該範式的認可,也補足了官方僅支援單一 NVIDIA GPU 的限制。
更深層的意義在於,AutoResearch 將「人類撰寫指令、代理自主執行研究循環」的工作模式具體化為可複製的開源專案。使用者可以基於 baseline 的 program.md 自行迭代,加入更多代理、調整研究組織結構,探索如何讓自主研究進展更快。這種將研究流程「程式化」的思路,被社群視為 AI 自主研究發展路徑上一個重要的可執行雛形。
AutoResearch 的關鍵數據表現如何?
AutoResearch 在 GitHub 擁有超過 9.4 萬星標、1.3 萬分支,主要語言為 Python,採用 MIT 授權,於 2026 年 3 月創建,近期持續更新。項目以極簡架構(三個核心檔案)實現自主研究循環,成為 AI 代理研究領域的高關注度開源項目。
出處連結有哪些?
本文資訊來源為 Andrej Karpathy 的 AutoResearch GitHub 儲存庫(karpathy/autoresearch),該儲存庫提供完整原始碼、快速入門指引與設計選擇說明。讀者可前往 GitHub 檢視原始碼與社群 fork 版本。
- 原始專案:[karpathy/autoresearch](