
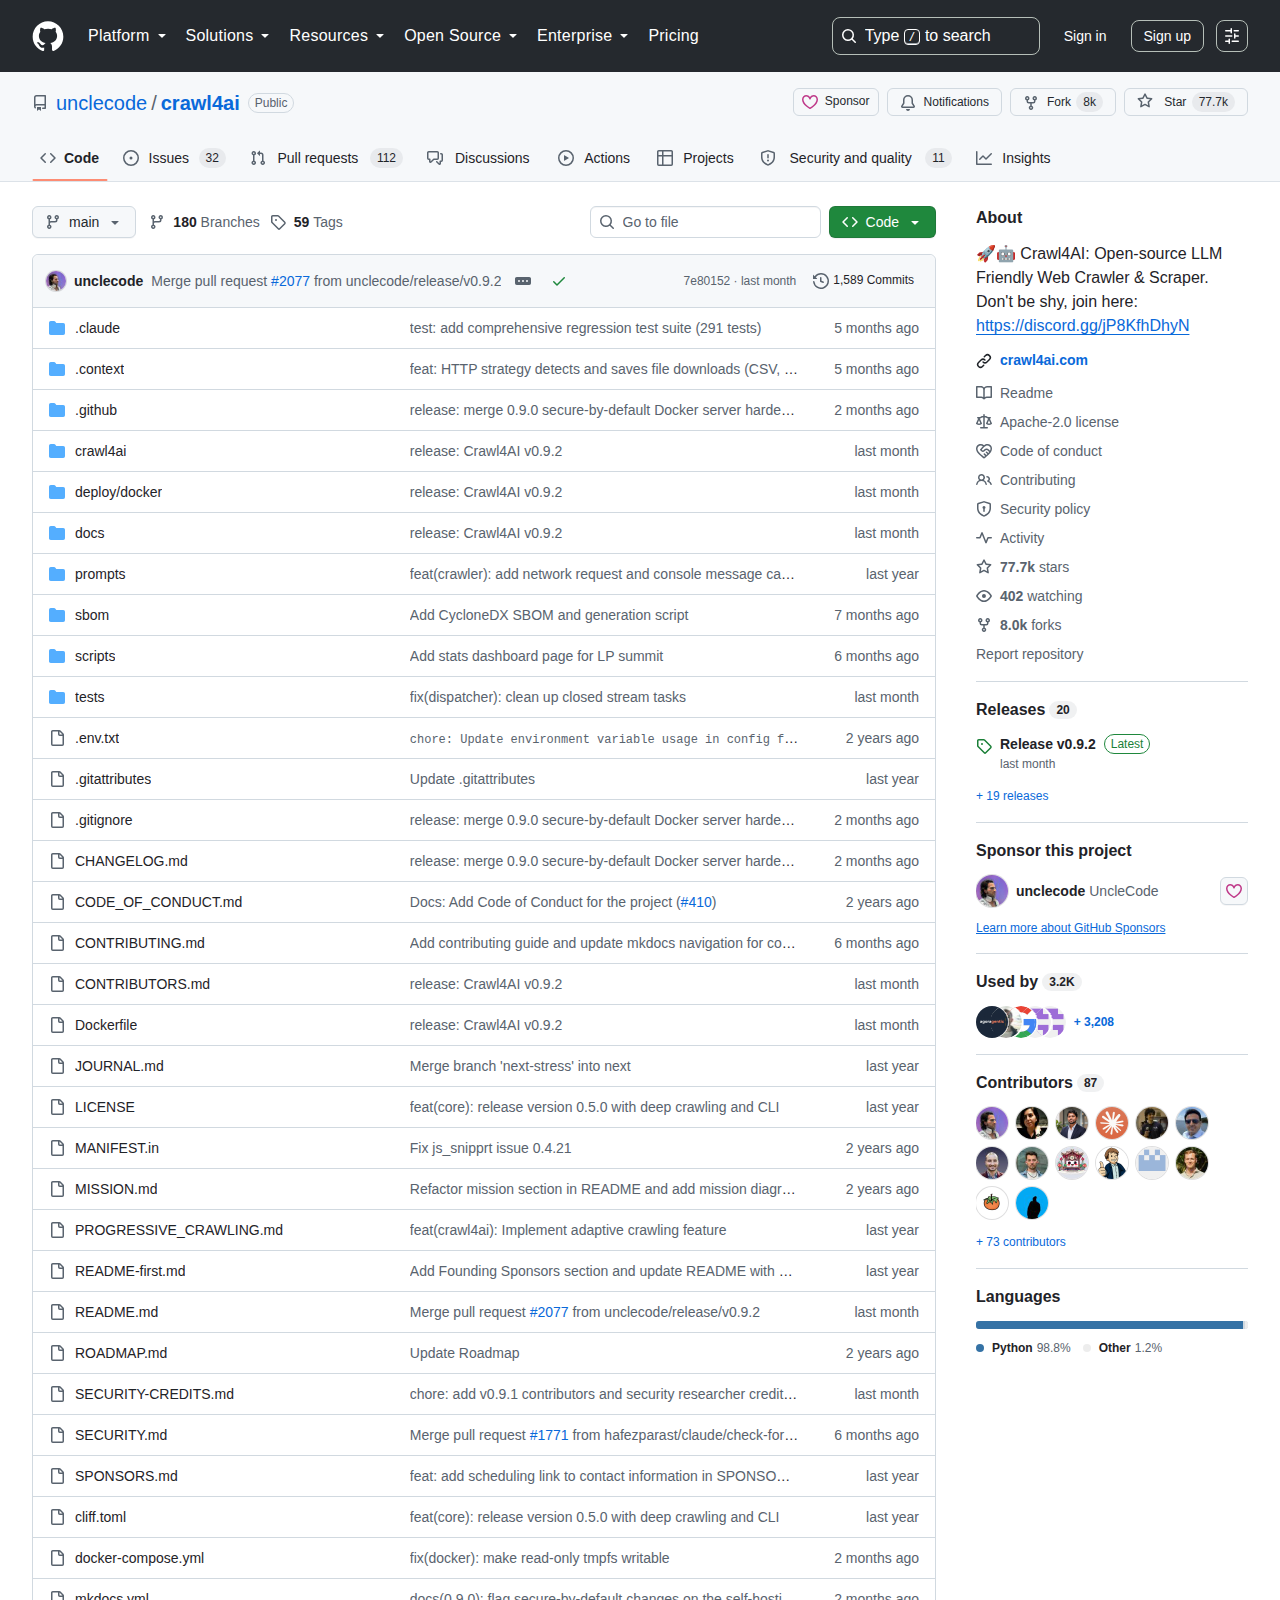
Crawl4AI 是 GitHub 上星標超過 77,000 顆的開源 LLM 友善網頁爬蟲(Web Crawler),定位為「將網頁轉換為乾淨、可直接供大型語言模型使用的 Markdown」,專為 RAG(檢索增強生成)、AI 代理與資料管線設計。該項目以 Python 開發,採用 Apache 2.0 授權,自 2024 年 5 月發布以來迅速成為 GitHub 上星標數最高的開源爬蟲工具,目前約有 8,000 次復刻與 87 位貢獻者,是 2026 年開源 AI 資料生態中不可忽視的基礎設施項目。
Crawl4AI 是開源 LLM 友善網頁爬蟲,GitHub 星標逾 7.7 萬,可將網頁轉換為乾淨、結構化的 Markdown,供 RAG 與 AI 代理使用;採用 Python 與 Apache 2.0 授權,支援 Docker 部署。
Crawl4AI 是什麼?
Crawl4AI 是一個開源的 LLM 友善網頁爬蟲與抓取工具,由開發者 unclecode 於 2023 年建立、2024 年 5 月在 GitHub 正式發布。項目誕生的契機來自創辦人的親身經歷:他在研究工作中需要將網頁轉換為 Markdown 格式,市面上的「開源」方案卻要求註冊帳號、取得 API token 並支付費用,且輸出品質仍不理想;於是他以數日時間自行建立 Crawl4AI,並以開源形式發布,隨即在開發者社群中迅速擴散,成為 GitHub 上最受歡迎的爬蟲項目。
Crawl4AI 由開發者 unclecode 建立,於 2024 年 5 月發布,起因是市面爬蟲工具需付費且品質欠佳;項目以開源形式發布後迅速成為 GitHub 星標最多的爬蟲工具。
該項目的核心價值在於「LLM Ready」輸出:它不只抓取原始 HTML,而是將網頁內容轉換為結構化的乾淨 Markdown,包含標題、表格、程式碼區塊與引用提示,讓 AI 模型可以直接閱讀、理解與引用。此設計大幅降低 RAG 管線與 AI 代理的資料前處理成本,亦是其與傳統爬蟲工具最大的差異所在。
Crawl4AI 的核心價值是輸出「LLM Ready」的結構化 Markdown,保留標題、表格、程式碼與引用結構,讓 AI 模型可直接閱讀,降低 RAG 管線的資料前處理成本。
Crawl4AI 的核心功能有哪些?
Crawl4AI 的功能體系圍繞「高品質內容轉換」與「可控抓取」兩大主軸展開。在內容轉換方面,它提供 Clean Markdown 與 Fit Markdown 兩種模式:前者生成格式精確的完整 Markdown,後者則以啟發式演算法過濾導航列、廣告等雜訊,產出最適合 AI 處理的精簡版本;同時採用 BM25 演算法進行核心資訊提取,並可將頁面連結轉換為編號參考清單,方便 AI 引用出處。
Crawl4AI 提供 Clean 與 Fit 兩種 Markdown 模式,以 BM25 演算法過濾雜訊並保留核心資訊,可將頁面連結轉為編號參考清單,輸出最適合 AI 處理的結構化內容。
在結構化資料抽取方面,該工具支援 LLM 驅動的抽取功能,相容所有主流開源與商用大型語言模型,並提供主題式、正則與句子層級等多種分塊策略,配合餘弦相似度進行語意檢索,可將網頁中的重複性資料(例如產品價格、商品列表)抽取為結構化 JSON。此外,CSS 選擇器與 XPath 抽取提供了不需 LLM 的快速路徑,適合對效能敏感的大規模抓取場景。
Crawl4AI 支援 LLM 驅動的結構化資料抽取,相容主流開源與商用模型,提供多種分塊策略與餘弦相似度檢索,亦可透過 CSS/XPath 快速抽取重複性資料為 JSON。
Crawl4AI 的技術架構有何特點?
Crawl4AI 的技術架構以非同步瀏覽器池(Async Browser Pool)為核心,內建快取機制並減少不必要的網路請求,實現「實際使用上快速」的抓取體驗。它基於 Playwright 建構,相容 Chromium、Firefox 與 WebKit 三種瀏覽器引擎,並支援動態視窗尺寸調整,確保頁面完整渲染;對於需要登入或處理動態內容的網站,其 Session 管理可保存瀏覽器狀態供多步驟抓取重複使用。
Crawl4AI 以非同步瀏覽器池為核心,基於 Playwright 建構,相容 Chromium、Firefox 與 WebKit,具備快取、Session 管理與動態視窗調整,確保頁面完整渲染與高效抓取。
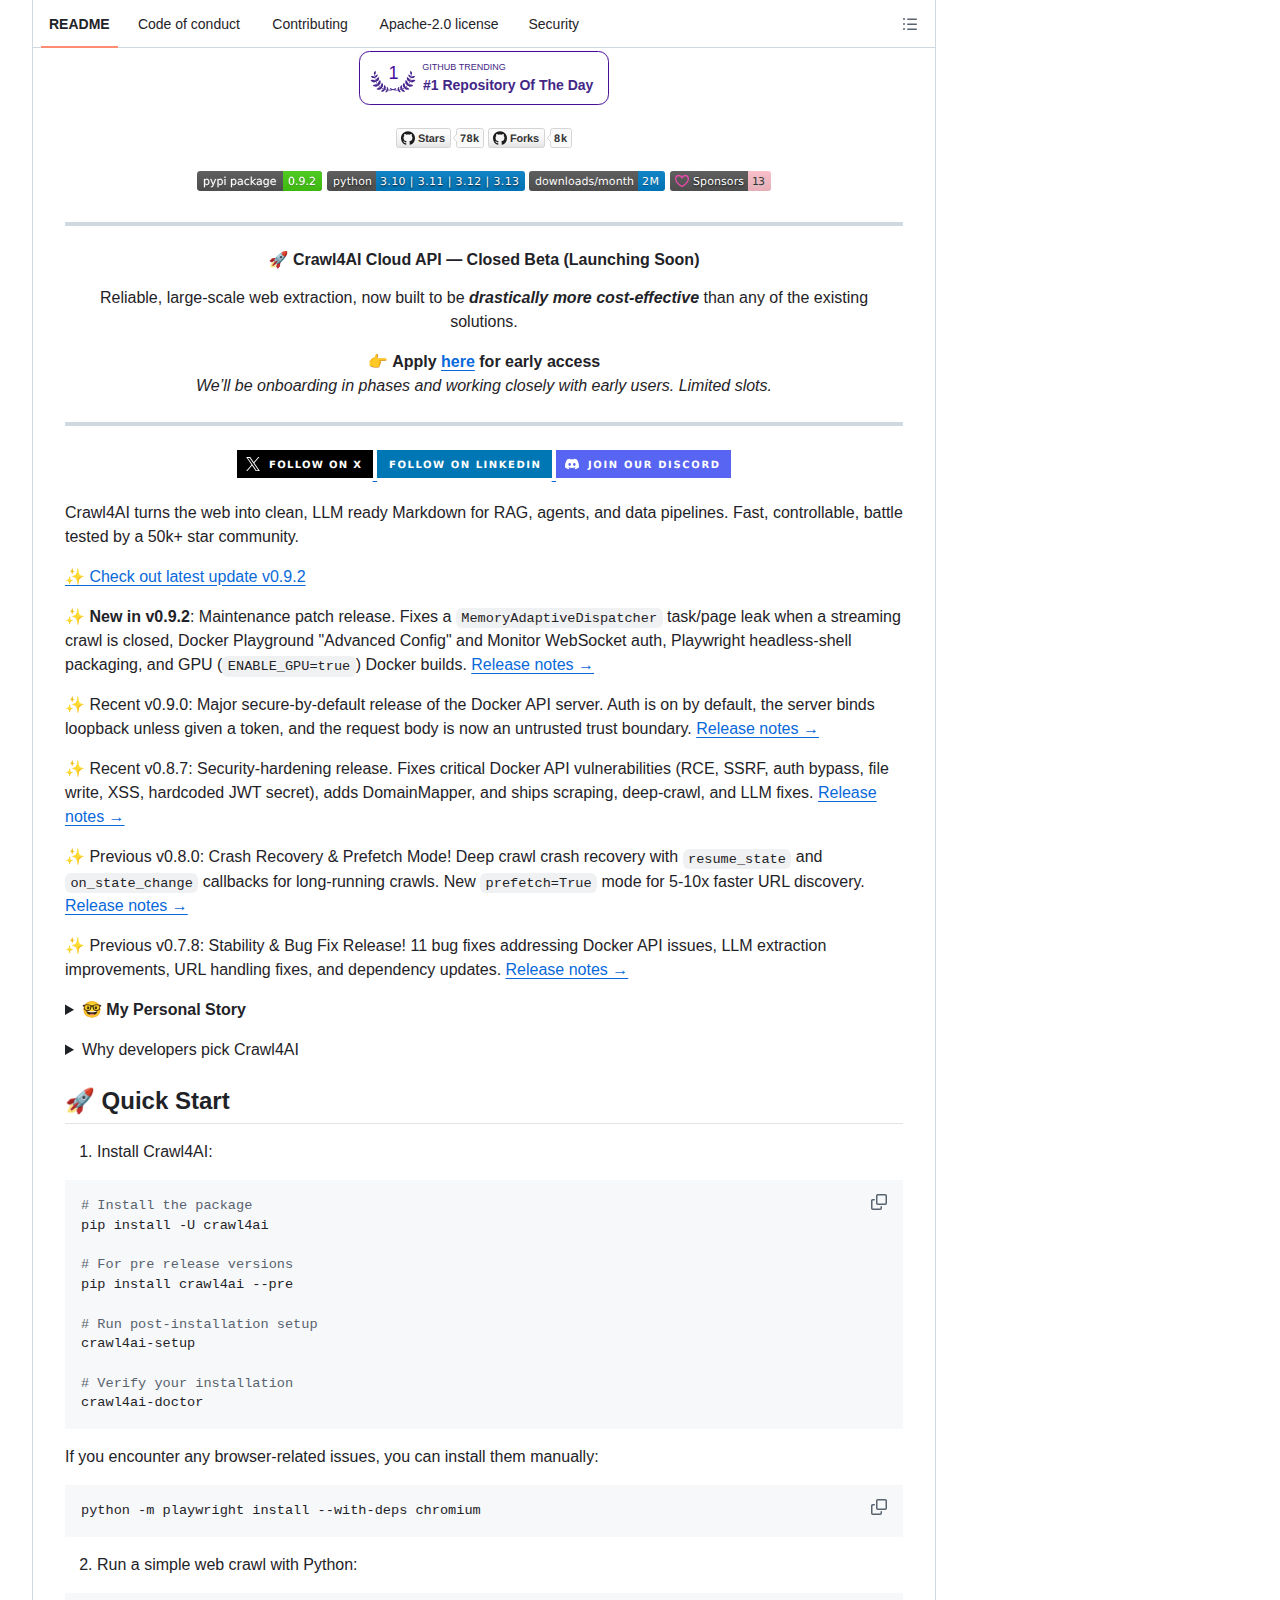
安全性與部署彈性是近期版本的重點。最新 v0.9.2 修復了串流抓取時的記憶體洩漏問題;v0.9.0 將 Docker API 伺服器改為「預設安全」架構,預設開啟認證、僅綁定回環位址,並將請求主體視為不可信邊界;v0.8.7 則修復了包含 RCE、SSRF、認證繞過與檔案寫入在內的多項 Docker API 嚴重漏洞。這些更新反映項目在快速迭代之餘,對企業級部署安全的高度重視。
近期版本聚焦安全與穩定:v0.9.2 修復記憶體洩漏,v0.9.0 將 Docker API 改為預設安全架構,v0.8.7 修復 RCE、SSRF 等多項嚴重漏洞,反映項目對企業部署安全的重視。
如何快速開始使用 Crawl4AI?
Crawl4AI 的安裝流程設計得相當直接,開發者可透過 pip 一鍵安裝,再執行 crawl4ai-setup 完成瀏覽器環境初始化,並以 crawl4ai-doctor 驗證安裝狀態;若遇到瀏覽器相關問題,可手動執行 Playwright 安裝指令補齊 Chromium 環境。安裝完成後,僅需數行程式碼即可完成首次抓取:建立 AsyncWebCrawler 實例,呼叫 arun 方法傳入目標網址,即可取得網頁的 Markdown 輸出。
安裝 Crawl4AI 只需執行 pip install 與 crawl4ai-setup,再用數行 Python 程式碼建立 AsyncWebCrawler 並呼叫 arun 方法,即可取得目標網頁的 Markdown 輸出。
對於偏好指令列操作的開發者,Crawl4AI 亦提供 crwl 命令列介面,支援基本抓取、以 BFS 策略進行的深度爬取(deep crawl),以及搭配特定問題的 LLM 抽取功能。企業用戶則可選擇 Docker 部署方案,官方提供的容器映像內建 FastAPI 伺服器、即時監控儀表板、瀏覽器池預熱機制與 MCP 整合,可直接連接 Claude Code 等 AI 工具,並支援 AMD64 與 ARM64 雙架構。
Crawl4AI 提供 crwl 命令列介面支援深度爬取與 LLM 抽取,企業可選 Docker 部署,內建 FastAPI、監控儀表板與 MCP 整合,支援 AMD64 與 ARM64 雙架構。
Crawl4AI 與其他爬蟲工具相比有何優勢?
相較於 Firecrawl 等以雲端 API 為主要收費模式的商業爬蟲服務,Crawl4AI 的最大差異在於「完全開源、無 API 金鑰門檻」:開發者可免費下載、自架部署並完整掌控資料管線,不存在速率限制與供應商綁定的問題。項目官方明確指出,其理念是先以開源解決「可用性」(任何人都能使用),再以雲端平台解決「可負擔性」(大規模抓取不必昂貴)。
相較 Firecrawl 等雲端收費服務,Crawl4AI 完全開源、無 API 金鑰門檻,可自架部署並完整掌控資料管線,無速率限制與供應商綁定問題。
在功能層面,Crawl4AI 的「自帶瀏覽器」(Bring Your Own Browser)模式允許用戶使用自己的瀏覽器實例,有效規避反爬蟲偵測;Stealth Mode 則透過模擬真實用戶行為降低被封鎖風險。其針對 LLM 輸出最佳化的設計,包括 Fit Markdown、引用清單與語意分塊,在同類工具中屬於較為完整的實現,因而成為 RAG 與 AI 代理開發者的熱門選擇。
Crawl4AI 提供自帶瀏覽器模式與 Stealth Mode 規避反爬蟲偵測,其 Fit Markdown、引用清單與語意分塊等 LLM 最佳化設計,在同類工具中較為完整。
Crawl4AI 的商業化路徑是什麼?
Crawl4AI 採取「開源核心+雲端服務」的雙軌商業化模式。開源部分維持 Apache 2.0 授權免費提供,雲端部分則推出 Crawl4AI Cloud API,主打「比現有解決方案大幅更具成本效益」的大規模網頁抽取服務,目前處於封閉測試階段,以分階段方式邀請早期用戶加入。此模式既保留開源社群的影響力,又為可持續發展提供商業支撐。
Crawl4AI 採取開源核心與雲端服務雙軌模式,開源部分以 Apache 2.0 免費提供,雲端 API 主打低成本大規模抽取,目前處封閉測試階段。
此外,項目設有分層贊助計畫,從每月 5 美元的 Believer 級別到 2,000 美元的 Data Infrastructure Partner 級別,提供早期功能使用權與技術支援等對應權益,並為首批 50 家創始贊助商提供永久曝光機會。此舉反映項目在商業化初期即重視與深度用戶建立長期合作關係,而非單純追求短期營收。
Crawl4AI 設有每月 5 至 2,000 美元的分層贊助計畫,提供早期功能與技術支援,並為首批 50 家創始贊助商提供永久曝光,重視長期合作關係。
出處連結有哪些?
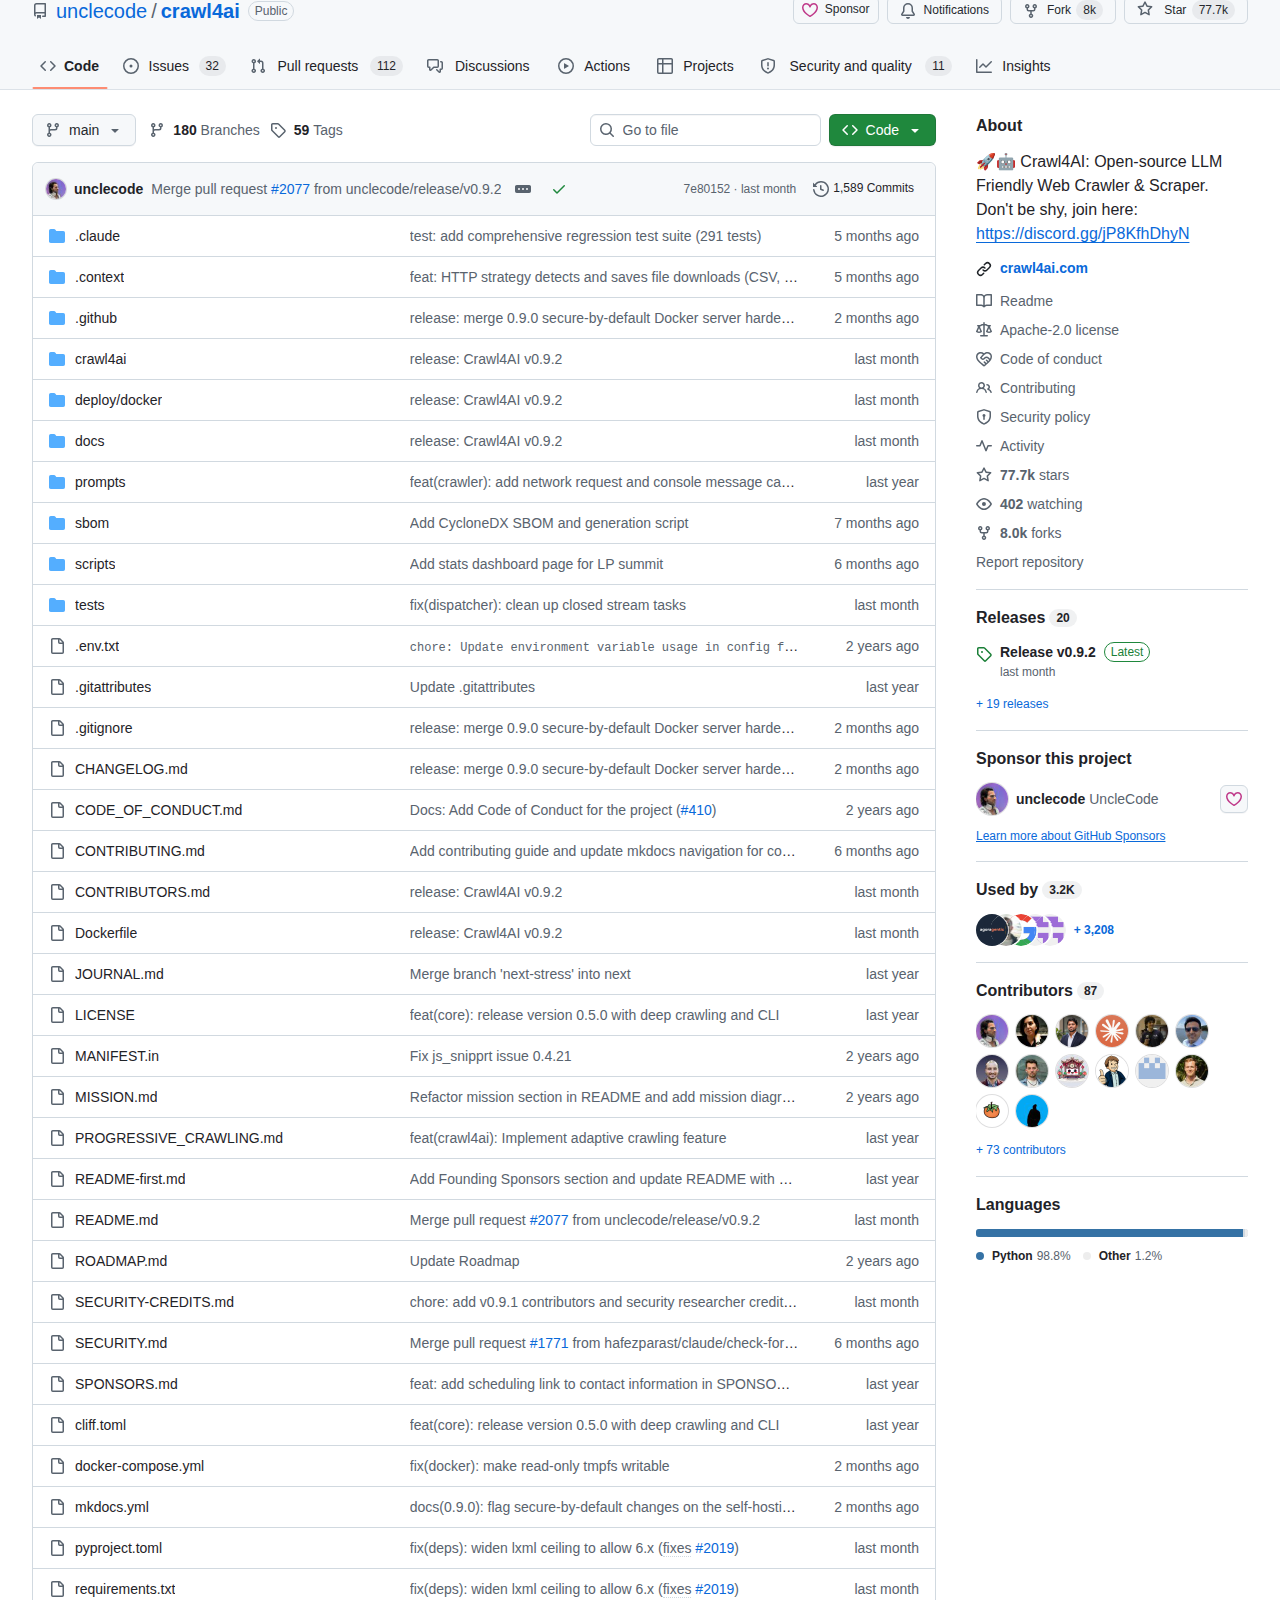
本文資料來源為 Crawl4AI 官方 GitHub 儲存庫,包含項目簡介、功能文件、版本更新紀錄與安裝指引。讀者可前往原始儲存庫查閱最新版本資訊與完整文件:Crawl4AI GitHub Repository。項目另有官方文件網站(docs.crawl4ai.com)、Discord 社群與 X(Twitter)帳號,供開發者取得教學資源與技術支援。
本文資料來源為 Crawl4AI 官方 GitHub 儲存庫,內含功能文件、版本更新與安裝指引;讀者可透過官方文件網站、Discord 社群與 X 帳號取得教學與支援。
常見問題有哪些?
常見問題有哪些?
**Crawl4AI 需要付費嗎?** 不需要。Crawl4AI 以 Apache 2.0 授權完全開源發布,可免費下載、自架部署並用於商業專案;雲端版 Crawl4AI Cloud API 屬額外付費服務,目前處於封閉測試階段。 **Crawl4AI 與 Firecrawl 有何不同?** Crawl4AI 是完全開源、可自架的方案,無 API 金鑰與速率限制;Firecrawl 則以雲端 API 服務為主要模式。兩者皆輸出 LLM 友善格式,但部署與商業模式不同。 **Crawl4AI 支援哪些瀏覽器?** 基於 Playwright 建構,相容 Chromium、Firefox 與 WebKit 三種瀏覽器引擎,並支援用戶自帶瀏覽器(Bring Your Own Browser)模式。 **Crawl4AI 可以抽取結構化資料嗎?** 可以。它支援 LLM 驅動的結構化抽取,將重複性資料轉為 JSON;亦提供 CSS 選擇器與 XPath 抽取的快速路徑。 **Crawl4AI 適合企業部署嗎?** 適合。官方提供最佳化的 Docker 映像,內建 FastAPI 伺服器、JWT 認證、監控儀表板與 MCP 整合,並支援 AMD64 與 ARM64 架構。 **安裝 Crawl4AI 需要哪些前置條件?** 需要 Python 環境與 Playwright 瀏覽器;執行 `crawl4ai-setup` 會自動安裝 Playwright,亦可手動執行 `python -m playwright install chromium` 補齊。總結:Crawl4AI 的前景如何?
Crawl4AI 以「為 LLM 而生」的明確定位切入網頁爬蟲市場,透過乾淨的 Markdown 輸出、LLM 驅動抽取與完善的 Docker 部署方案,在短短兩年內累積逾 7.7 萬星標,成為開源爬蟲領域的領先項目。其開源核心與雲端服務並行的商業模式,配合持續強化安全性與穩定性的版本迭代,顯示項目正從社群驅動的熱門工具,逐步走向可支撐企業級 RAG 與 AI 代理基礎設施的成熟平台。
Crawl4AI 以 LLM 友善定位累積逾 7.7 萬星標,成為開源爬蟲領先項目;開源與雲端並行模式配合安全強化迭代,正走向企業級 RAG 基礎設施平台。