
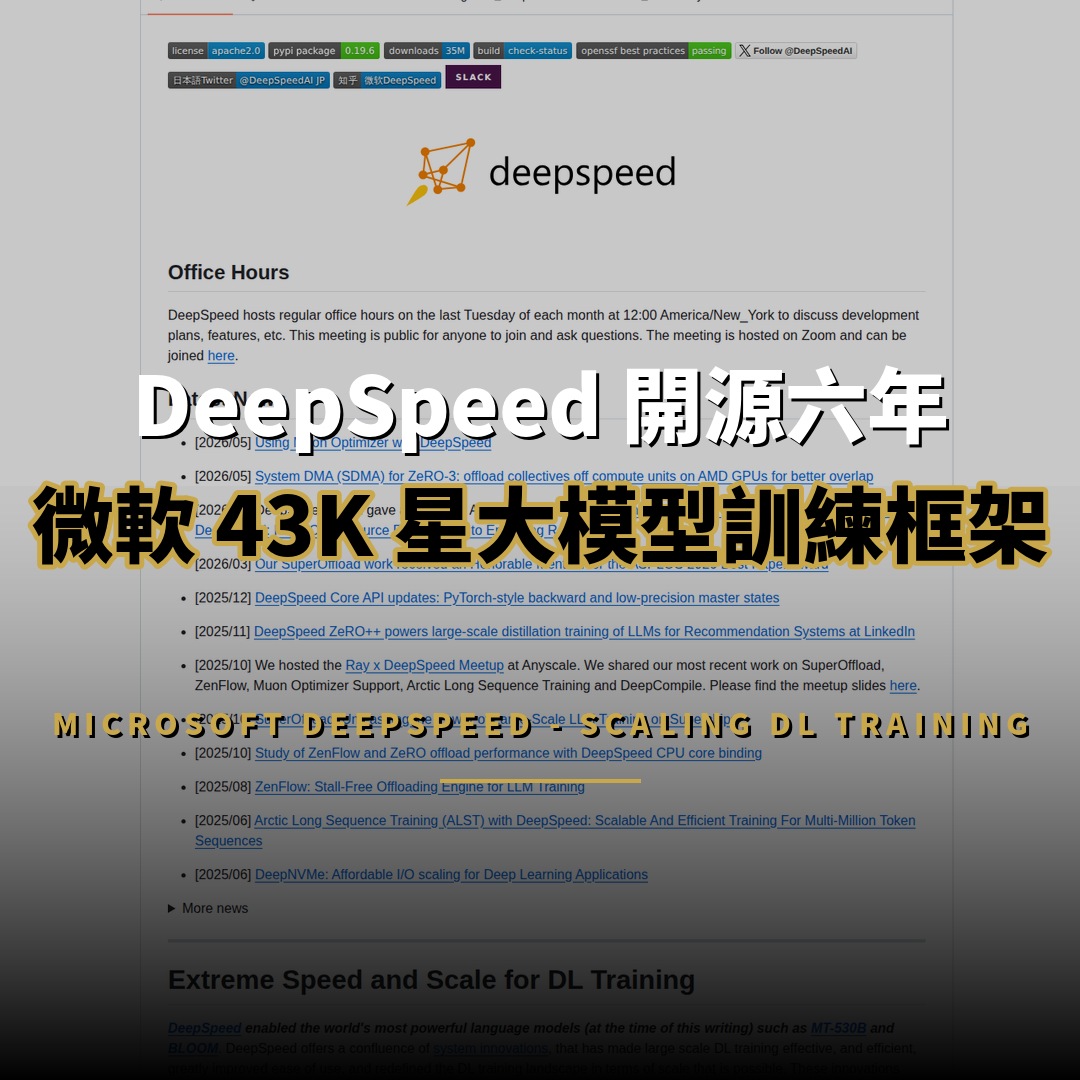
Microsoft DeepSpeed 是微軟研究院主導開發的開源深度學習優化庫,定位於讓分散式訓練與推理「簡單、高效、有效」,截至 2026 年 9 月在 GitHub 累積超過 43,000 顆星標與近 5,000 個複製分支,採用 Apache-2.0 許可證。該項目曾支撐 Megatron-Turing NLG 530B、BLOOM 176B 等世界級大規模語言模型的訓練,是大模型時代最具代表性的系統級基礎設施之一,2026 年仍以每月一次的節奏持續推出新技術。
Microsoft DeepSpeed 是微軟研究院的開源深度學習優化庫,GitHub 逾 43,000 星標,支撐過 MT-530B、BLOOM 176B 等超大模型訓練。
Microsoft DeepSpeed 是什麼?
DeepSpeed 是微軟研究院的開源深度學習優化庫,以 ZeRO 記憶體優化與異構 offload 等技術,讓團隊以有限硬體訓練數百億參數的大模型。
DeepSpeed 誕生於 2020 年 1 月,是微軟「AI at Scale」研究計畫的核心組成部分,由微軟研究院系統團隊主導開發。其最初的目標非常明確:打破深度學習訓練的規模天花板,讓研究者不必仰賴昂貴的專用集群,也能訓練超大規模模型。項目開源後迅速成為 Hugging Face Transformers、PyTorch Lightning 等主流框架的預設訓練加速選項之一。
從定位來看,DeepSpeed 並非一個模型庫,而是一套系統級優化工具。它處理的是分散式訓練底層的記憶體分配、通訊協調、計算排程等問題,開發者只需在既有 PyTorch 程式碼中加入少量配置,即可獲得顯著的規模與效率提升。這種「少改動、大收益」的設計哲學,是其在開源社群獲得廣泛採用的根本原因。
DeepSpeed 有哪些核心技術亮點?
DeepSpeed 的核心技術包括 ZeRO 記憶體優化、ZeRO-Infinity offload、MoE 與 RLHF 管道,以及 SuperOffload 等新優化。
ZeRO(Zero Redundancy Optimizer)是 DeepSpeed 最具代表性的技術,其核心思想是將傳統資料並行中重複存放的模型狀態(優化器狀態、梯度、參數)進行分區,分散到多張 GPU 上,使記憶體使用量隨卡數線性下降。這項技術讓 175B 參數等級的模型訓練首次走入一般研究機構的可行性範圍,並在頂尖學術會議 SC 2020 上發表。後續的 ZeRO-Infinity 更進一步將 offload 擴展至 CPU 與 NVMe,讓單張 GPU 也能訓練超過百億參數的模型,被視為「打破 GPU 記憶體壁」的關鍵突破。
在模型架構支援方面,DeepSpeed-MoE 針對混合專家(Mixture of Experts)模型提供專屬的訓練與推理優化,DeepSpeed-Chat 則將 RLHF 訓練管道完整開源,讓開發者能以較低門檻訓練類 ChatGPT 模型。2025 年推出的 ZenFlow 以非同步更新機制消除 offload 訓練中的停滯問題,2026 年發表的 SuperOffload 則針對超級晶片(Superchip)架構優化大規模訓練,該論文獲得 ASPLOS 2026 最佳論文榮譽獎。此外,項目亦持續跟進優化器生態,於 2026 年 5 月加入 Muon 優化器支援。

DeepSpeed 如何降低大模型訓練成本?
DeepSpeed 以 ZeRO 將模型狀態分區至多張 GPU,配合 CPU 與 NVMe offload 突破單卡記憶體限制,ZeRO++ 更把訓練通訊量縮減約四分之一。
成本控制是 DeepSpeed 貫穿始終的設計主軸。傳統資料並行訓練的最大浪費在於每一張 GPU 都複製完整的模型狀態,導致記憶體大量重複佔用;ZeRO 透過分區策略消除這份冗餘,使同樣的硬體規模可以訓練顯著更大的模型。對於資源有限的研究團隊,這意味著不需購入高階 GPU,也能參與百億參數等級的模型訓練。
ZeRO++ 則從通訊層面進一步壓縮成本。該技術針對跨節點(cross-node)資料並行中的梯度同步瓶頸,結合量化與分層通訊策略,將通訊量減少約四倍,同時維持收斂速度。根據微軟發表的實測,這項優化在大規模訓練中可以帶來可觀的端到端加速,尤其對網路頻寬受限的訓練環境效益明顯。2025 年 11 月,LinkedIn 更公開採用 ZeRO++ 完成推薦系統大模型的蒸餾訓練,印證其商業化價值。
DeepSpeed 的生態系統與採用情況如何?
DeepSpeed 曾支撐 MT-530B、BLOOM 176B 等旗艦模型,整合主流訓練框架,並支援 NVIDIA、AMD、Intel 與華為昇騰等硬體。
DeepSpeed 的採用紀錄橫跨產業界與學術界。在模型層面,微軟自家的 Megatron-Turing NLG 530B 以其為核心訓練框架;AI21 Labs 的 Jurassic-1(178B)、BigScience 的 BLOOM(176B)、智譜 AI 的 GLM(130B)等知名開源模型亦皆在 DeepSpeed 支撐下完成訓練。這份名單涵蓋不同組織、不同規模的模型,反映其作為通用訓練基礎設施的成熟度。
在框架生態上,DeepSpeed 與 Hugging Face Transformers、Accelerate、PyTorch Lightning、MosaicML 等主流訓練框架皆完成深度整合,開發者可以透過既有工作流程直接啟用 DeepSpeed 加速。硬體層面,項目除 NVIDIA 與 AMD GPU 外,亦獲得 Intel Gaudi、Intel XPU、華為昇騰 NPU 等加速器的貢獻支援,並由 Modal 等公司贊助 GPU 資源進行持續整合測試,形成跨廠商、跨架構的開放生態。
DeepSpeed 的數據表現如何?
截至 2026 年 9 月,DeepSpeed 在 GitHub 獲 43,065 星標與 4,962 複製分支,採用 Apache-2.0 許可證,主要語言為 Python。
以星標數而言,DeepSpeed 是 GitHub 上規模最大的深度學習系統優化專案之一,43,000 顆星標反映其在大模型開發社群中的高知名度。項目自 2020 年建立以來維持長期的活躍開發,2026 年 9 月 6 日仍有多個提交合入主分支,顯示微軟團隊並未因技術成熟而放緩投入,反而持續往超級晶片訓練、長序列訓練與編譯器優化等新方向推進。

如何快速開始使用 DeepSpeed?
安裝 DeepSpeed 只需先備妥 PyTorch 2.0 以上版本,再執行 pip install deepspeed,並以 ds_report 檢查環境相容性,即可開始使用。
DeepSpeed 的入門流程設計得相當直接。使用者首先需要安裝 PyTorch(建議 2.0 以上版本),接著透過 pip 安裝 DeepSpeed 套件,安裝完成後執行 ds_report 指令即可檢視當前環境支援的優化算子(ops)。預設情況下,DeepSpeed 的 C++ 與 CUDA 擴充會以即時編譯(JIT)方式在建置時動態連結,省去繁瑣的手動編譯步驟。
對於一般訓練任務,開發者只需在訓練腳本中引入 DeepSpeed 引擎,並以 JSON 格式定義優化配置,即可啟用對應的記憶體優化策略。Windows 使用者亦可透過官方提供的 build_win.bat 腳本構建安裝包,多數功能在 Windows 環境皆可使用。完整的配置說明、教學與 API 文件集中於 deepspeed.ai 官方網站,方便開發者按需查閱。
出處連結有哪些?
本文資訊整理自 deepspeedai/DeepSpeed 的 GitHub 儲存庫,含官方 README、技術論文與更新紀要,讀者可前往查閱原始碼與文件。
本文內容整理自 deepspeedai/DeepSpeed 儲存庫的官方 README、技術部落格與發表於 SC、ICML、ASPLOS 等會議的學術論文。該儲存庫提供完整的原始碼、安裝文件、教學與版本紀錄,讀者可於 GitHub 上直接查閱:https://github.com/deepspeedai/DeepSpeed

總結:DeepSpeed 適合什麼團隊?
DeepSpeed 適合訓練或部署大規模模型的團隊,尤為研究機構與企業 AI 部門;Apache-2.0 授權亦降低商用門檻。
綜合評估,DeepSpeed 最適合三類團隊。其一是計畫訓練百億參數以上模型的學術研究機構,ZeRO 系列技術能顯著降低硬體門檻;其二是企業 AI 部門,需要可靠的分散式訓練基礎設施支撐產品級模型,Apache-2.0 許可證允許商業應用與二次開發;其三則是倚賴 Hugging Face 生態的開發者,可透過成熟的框架整合以極低成本獲得規模擴展能力。
展望未來,DeepSpeed 的發展方向已明顯向超級晶片、長序列訓練與編譯器優化延伸,Arctic Long Sequence Training 支援百萬級 token 序列,DeepNVMe 則解決 I/O 瓶頸,顯示微軟正將該框架從「訓練加速器」升級為覆蓋訓練全生命週期的系統平台。對於關注大模型基礎設施演進的讀者,DeepSpeed 是值得持續追蹤的指標性開源項目。