
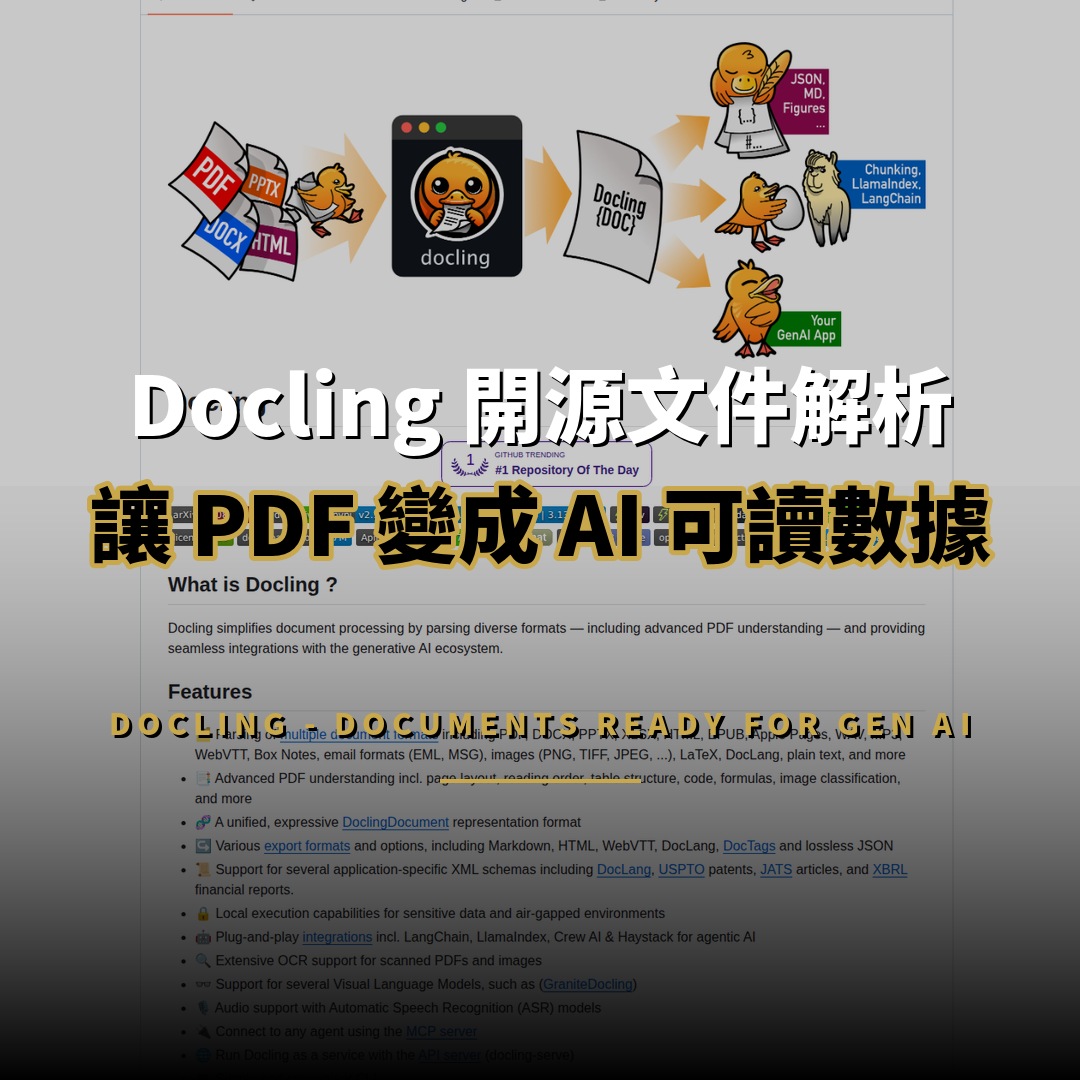
Docling 是一套由 IBM 發起、現由 LF AI & Data 基金會託管的開源文件解析工具,目前於 GitHub 擁有 66,197 星標與 4,758 次複製,定位是「讓文件為生成式 AI 做好準備」(Get your documents ready for gen AI)。該項目可將 PDF、DOCX、PPTX、XLSX、HTML、EPUB 乃至掃描影像等多元格式,轉換為 AI 模型可直接讀取的結構化 Markdown 與 JSON,並已成為檢索增強生成(RAG)應用中常見的文件前處理層。
Docling 是 IBM 發起的開源文件解析工具,GitHub 星標 66,197,可將 PDF 等多種格式轉換為 AI 可讀的結構化 Markdown 與 JSON。
Docling 是什麼?為何被稱為文件 AI 化的關鍵工具?
Docling 是文件解析與 AI 之間的橋樑,將版式複雜的 PDF、掃描文件轉成保留版面、表格與閱讀順序的結構化數據,解決生成式 AI 無法直接理解原始文件的痛點。
Docling 的核心定位,是填補「原始文件」與「生成式 AI」之間的理解鴻溝。大型語言模型無法直接讀懂 PDF 內部的多欄排版、表格結構、公式與掃描影像,若未經處理便將文件送入模型,往往會得到語意破碎、表格錯亂的內容,導致 RAG 系統檢索品質低落。Docling 的角色,就是將這些非結構化文件解析為保留語意與版面資訊的結構化表示,讓後續的切塊、嵌入與檢索流程建立在乾淨的數據基礎上。
該項目起源於 IBM Research 的 Deep Search 團隊,技術報告於 2024 年 8 月以 arXiv 論文形式公開(編號 2408.09869),並於 2025 年正式捐贈給 LF AI & Data 基金會,成為中立的開源治理項目。其發展軌跡反映一個重要趨勢:當各家廠商競逐模型能力時,文件理解這類「數據工程」問題,正逐漸成為決定 AI 應用落地品質的關鍵環節。
Docling 有哪些核心功能與技術亮點?
Docling 支援逾二十種格式,具備版面分析、閱讀順序重建、表格辨識與 OCR,並可導出 Markdown、HTML 與無損 JSON。
第一個亮點是極廣的格式覆蓋範圍。Docling 除了支援 PDF、DOCX、PPTX、XLSX、HTML 與 EPUB 等常見格式,亦涵蓋 Apple Pages、LaTeX、純文字與 Markdown 超集(QMD、RMD),甚至加入電子郵件(EML、MSG)、ODF 文件與 XBRL 財務報告格式。2026 年新增的影片解析功能,可從 MP4、AVI、MOV、MKV 與 WebM 中抽取語音轉錄稿與代表性關鍵幀,將多媒體內容一併納入可檢索範圍。
第二個亮點是先進的 PDF 理解能力。Docling 對 PDF 的版面分析涵蓋頁面配置、閱讀順序、表格結構、程式碼、公式與影像分類,能正確還原多欄文件與巢狀表格的原始結構,這是多數簡單文字抽取工具無法做到的。對掃描文件與圖片,Docling 提供完整的 OCR 支援,並可透過視覺語言模型(VLM)進一步強化理解,官方推薦的 GraniteDocling 模型即針對文件理解任務進行特化。

第三個亮點是統一的文件表示與多樣化導出。Docling 以自訂的 DoclingDocument 作為內部統一格式,任何來源文件都會被標準化為同一種結構化模型,再依需求導出為 Markdown、HTML、無損 JSON 或 DocTags 等格式,並支援 DocLang、USPTO 專利、JATS 學術論文與 XBRL 財務報告等領域特定 XML Schema,讓文件數據可直接流入下游專業系統。
Docling 如何將 PDF 轉換為 AI 可讀的 Markdown?
Docling 提供 CLI 與 Python API,一行指令即可將 PDF 轉為 Markdown,亦可使用 DocumentConverter 細緻控制轉換流程。
Docling 的入門門檻設計得非常低。使用者只需以 pip 安裝套件,便能透過 CLI 執行轉換,例如 docling 加上一個文件 URL 或本機路徑,程式便會在目前目錄生成對應的 Markdown 檔案,內容包含標題層級、表格與版面結構。需要更細緻控制的使用者,可改用 Python API,以 DocumentConverter 物件載入文件,一行程式碼完成轉換,再呼叫 export_to_markdown 等方法取得結構化輸出。
對進階應用而言,Docling 提供多種整合途徑。開發者可透過 LangChain、LlamaIndex、Crew AI 與 Haystack 等框架的原生整合,直接將 Docling 作為 RAG 管線的文件載入器;亦可啟動內建的 MCP(Model Context Protocol)伺服器,讓 Claude 等 AI Agent 以標準化協定呼叫文件解析能力。需要服務化部署的團隊,則可使用 docling-serve API 伺服器,或部署於 Apify 等雲端平台,以 HTTP 介面提供文件轉換服務。
Docling 的授權模式與開源生態如何?
Docling 採用 MIT 授權,屬寬鬆開源許可,由 LF AI & Data 基金會託管,IBM Research 主導開發,社群與企業均可自由採用與商用。
Docling 採用 MIT 授權,是開源授權中最寬鬆的一類,允許使用者自由修改、散布與商業使用,毋須公開衍生程式碼,這對企業導入而言大幅降低了法律障礙。項目由 LF AI & Data 基金會治理,該基金會旗下亦託管著众多知名 AI 開源項目,中立的治理架構有助於吸引跨公司貢獻者參與,避免單一廠商主導的風險。
從生態動能觀察,Docling 的開發節奏相當活躍。儲存庫截至 2026 年 9 月累計超過 4,700 次複製,最新提交與版本發布均維持高頻率,官方 Discord 社群與 GitHub Discussions 持續有討論;其每月 PyPI 下載量亦反映實際採用規模。IBM 同時釋出 GraniteDocling 系列視覺語言模型,並與 Hugging Face 生態深度整合,顯示該項目背後具備企業級資源持續投入。
Docling 的市場定位與競爭優勢是什麼?
- 66,197Stars
- 4,758Forks
- MITLicense
- Python主要語言
- 2026-09-09最近更新
截至 2026 年 9 月,Docling 累計 66,197 星標與 4,758 次複製,採用 MIT 授權,以 Python 撰寫,由 LF AI & Data 基金會託管。
在文件解析賽道,Docling 面對的主要競爭者包括 Unstructured、PyMuPDF、markitdown 等工具。相較於 PyMuPDF 等偏底層的 PDF 操作庫,Docling 提供的是完整的上層文件理解管線,涵蓋版面分析、OCR 與多格式轉換;相較於 Unstructured 等商業化較深的服務,Docling 以 MIT 授權開放全部功能,並將 VLM 支援與領域 Schema 整合納入開源版本,對自架團隊更具吸引力。
Docling 的差異化優勢體現在三個層面。其一是格式覆蓋的廣度,從電子郵件、試算表到影片音訊皆可處理,超越多數僅聚焦 PDF 的競品;其二是與 AI 生態的整合深度,MCP 伺服器、LangChain 與 LlamaIndex 原生支援讓它可直接嵌入 Agent 工作流程;其三則是 IBM 與 LF AI & Data 的治理背書,對企業採用決策而言是重要的信賴訊號。在 RAG 與企業知識庫應用持續擴張的背景下,文件解析層已成為 AI 基礎設施的重要組成。

出處連結有哪些?
本文資訊來自 docling-project/docling 的 GitHub 儲存庫、官方文件與 arXiv 技術報告,可查閱原始碼、授權條款與使用指南。
本文內容整理自 docling-project/docling 的 GitHub 儲存庫(https://github.com/docling-project/docling)、官方文件網站(https://docling-project.github.io/docling/)與 arXiv 技術報告(https://arxiv.org/abs/2408.09869),讀者可前往上述來源查閱完整原始碼、MIT 授權全文、支援格式清單與整合說明。

總結:Docling 適合什麼團隊使用?
Docling 適合建構 RAG 與知識庫應用的開發團隊、需要批量處理企業文件的組織、重視資料自主權的自架用戶,以及研究文件理解技術的學者。
綜合而言,Docling 的價值在於將「文件理解」這個繁瑣的數據工程問題,轉化為一行指令即可完成的可重複流程。對開發 RAG 應用的團隊而言,以 Docling 作為文件載入層,可顯著提升檢索內容的結構完整性;對銀行、法律與醫療等大量處理掃描文件的產業而言,其 OCR 與版面分析能力可取代人工整理;對重視資料隱私的組織而言,完全本地執行的特性讓敏感文件毋須離開企業環境。作為文件解析領域星標數最高的開源項目之一,Docling 以 MIT 授權、基金會治理與持續的版本迭代,正逐步成為 AI 文件前處理層的事實標準。