
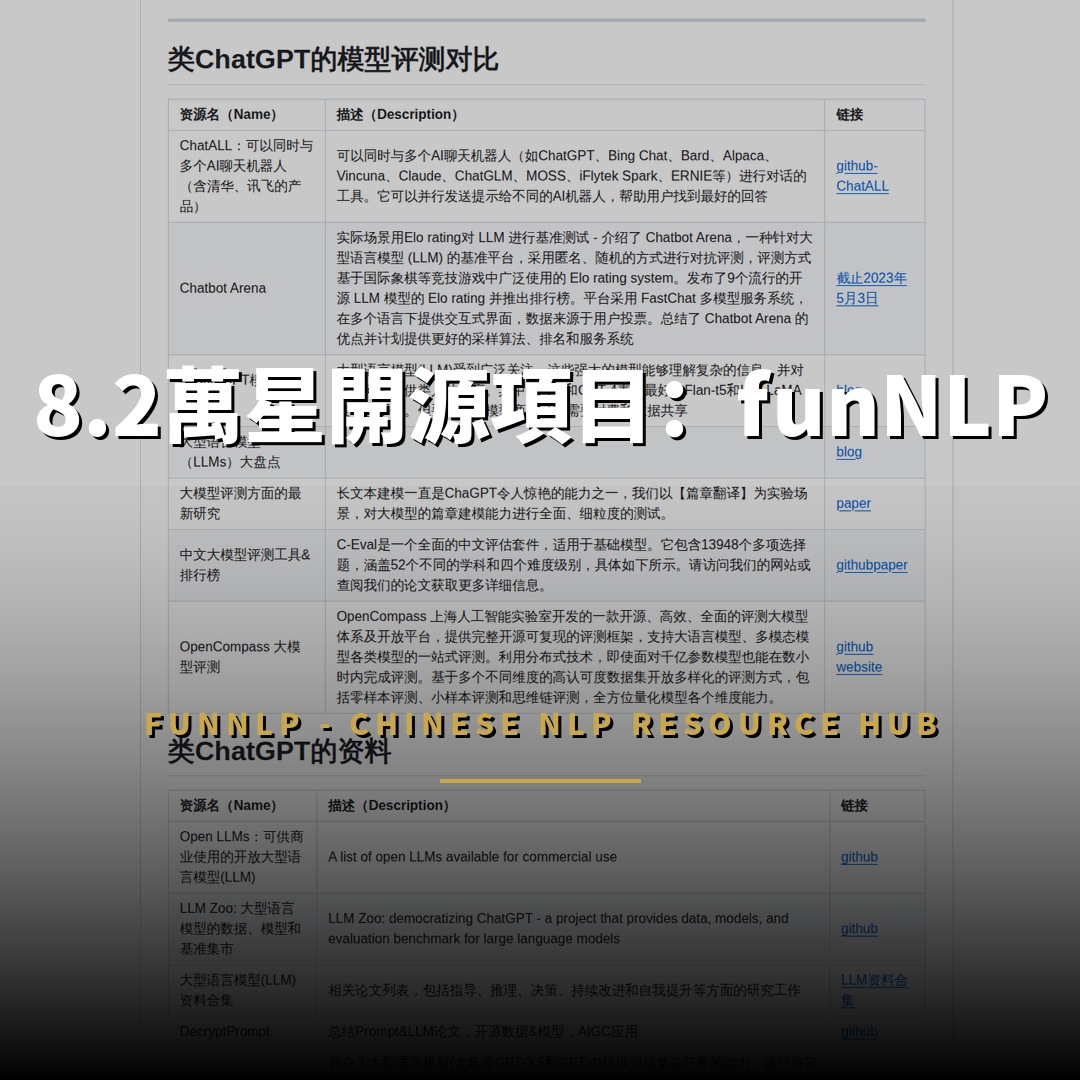
funNLP 是 GitHub 上星標數最高的中文自然語言處理資源庫之一,目前擁有超過 8.2 萬顆星標與 1.5 萬次分支,由開發者 fighting41love 於 2018 年 8 月建立並長期維護,被社群稱為「NLP 民工的樂園」。該項目以「幾乎最全的中文 NLP 資源庫」為定位,系統性收錄語料庫、詞法工具、預訓練語言模型、知識圖譜、文本生成與行業應用等數百項工具與數據集,是中文自然語言處理領域最具指標性的開源資源彙整項目。
funNLP 是什麼?
funNLP 是一個以中文自然語言處理為核心的開源資源彙整庫,由開發者 fighting41love 於 2018 年建立,GitHub 星標超過 8.2 萬。它系統性收錄語料庫、詞法工具、預訓練模型、知識圖譜、文本生成工具與金融、醫療、法律等行業資源,被社群稱為「NLP 民工的樂園」。
funNLP 的建立源於項目維護者在入門自然語言處理過程中大量使用 GitHub 上的開源套件,進而萌生整理分享的念頭。與一般單一功能的工具庫不同,funNLP 本質上是一座持續擴充的資源索引,將散落在數百個獨立倉庫中的中文 NLP 工具、數據集、課程與競賽方案彙整為結構化清單,並以長期不定時更新的方式追蹤產業前沿動態。
該項目的目錄設計具有清晰的知識分類邏輯,涵蓋語料庫、詞庫及詞法工具、預訓練語言模型、資訊抽取、知識圖譜、文本生成、文本摘要、智能問答、文本糾錯、文檔處理、表格處理、文本匹配、數據增強、文本檢索、閱讀理解、情感分析、語音處理、事件抽取、機器翻譯、文本聚類與文本分類等數十個子類別,幾乎覆蓋自然語言處理全技術棧。
funNLP 的核心價值與資源亮點有哪些?
funNLP 的核心價值在於「一站式彙整」與「分類體系化」。它收錄數百項中文語料庫與工具,涵蓋預訓練模型、知識圖譜、文本生成、語音處理與行業應用,並持續追蹤類 ChatGPT 開源模型的評測對比與框架動態,讓開發者免於在數百個倉庫之間反覆搜尋。
funNLP 的第一項亮點是語料庫資源的廣度。項目收錄中文聊天語料、百度問答數據集、微信公眾號語料、人民日報語料處理工具、中文謠言數據、虛假新聞數據集、任務型對話英文數據集與 Common Voice 語音識別數據集等,並涵蓋詞向量、分詞語料、中文縮寫庫、拆字詞典與各行業詞庫,為模型訓練與實驗提供了即取即用的數據基礎。
第二項亮點是工具鏈的完整性。從 jieba 加速版、哈工大 LTP、SpaCy 中文模型、cnocr 中文 OCR,到文本自動摘要、關鍵詞抽取、情感分析、命名實體識別與關係抽取工具,項目幾乎涵蓋中文 NLP 每個環節的成熟解決方案,並收錄了 FastChat、Transformers 等主流框架的資源指引,使開發者能夠在單一入口完成工具選型。
第三項亮點是對產業前沿的持續追蹤。README 開篇即以「類 ChatGPT 的模型評測對比」為首個章節,彙整 Chatbot Arena、C-Eval、OpenCompass 等大模型評測平台與中文大模型開源框架資源,反映項目維護者對生成式 AI 浪潮的敏銳捕捉,也讓這個歷史悠久的資源庫持續保持新聞價值。
funNLP 涵蓋哪些分類與行業應用?
funNLP 涵蓋數十個分類,從基礎的語料庫、詞法工具、預訓練模型,到知識圖譜、文本生成與智能問答,並延伸出金融、醫療、法律等行業專屬資源,以及課程報告、競賽方案與面試資料,兼具學習路徑與實戰工具雙重功能。
在基礎技術層面,funNLP 收錄了清華大學 XLORE 中英文跨語言百科知識圖譜、大規模中文知識圖譜數據、基於知識圖譜的問答系統與事件三元組抽取等資源,並涵蓋基於 BERT 的命名實體識別、中文全詞覆蓋 BERT、海量中文預訓練 ALBERT 模型與中文 GPT-2 訓練代碼,完整呈現預訓練語言模型時代的技術演進脈絡。
在行業應用層面,項目設有金融 NLP、醫療 NLP 與法律 NLP 專區,收錄金融投資數據提取工具、中文醫療對話數據、醫療知識圖譜問答系統、法律文本分析 pipeline 與罪名法務名詞分類模型等資源,反映自然語言處理技術在垂直行業的落地路徑。此外,項目亦收錄變量命名神器、汪峰歌詞生成器、自動對聯系統等趣味工具,展現技術社群的人文趣味。
在學習資源層面,funNLP 彙整了 Stanford CS224n 深度學習自然語言處理課程、清華大學人工智能技術系列報告、各大公司技術分享 PDF 與 PPT、NLP 競賽 TOP 方案復盤及面試知識點整理,形成從理論學習到求職準備的完整閉環,對中文 NLP 學習者具有獨特的參考價值。
funNLP 與其他資源庫有何不同?
funNLP 的差異化在於「中文語境深耕」與「歷史累積厚度」。相較於以英文資源為主的 awesome 清單,funNLP 聚焦中文語料、中文模型與中文行業應用,並自 2018 年起持續更新八年,累積數百項資源,形成其他同類項目難以短期複製的內容厚度。
在開源資源彙整領域,英文世界已有大量 high-quality 的 awesome 系列清單,但它們多數以英文工具與英文數據集為主,中文資源往往零散分佈且缺乏系統整理。funNLP 的出現填補了這一缺口,它以中文為第一優先,系統性收錄中文語料庫、中文預訓練模型與中文行業應用,成為中文 NLP 開發者最直接的資源入口。
該項目的另一項差異化優勢在於持續時間。自 2018 年建立以來,funNLP 已維持近八年的長期更新,橫跨傳統機器學習、深度學習與大型語言模型三個技術時代,其內容演進本身即是一部中文 NLP 發展簡史。這種歷史累積使項目具備同類新興清單難以比擬的內容深度與社群信任度。
funNLP 值得一試嗎?
對於中文 NLP 學習者與開發者,funNLP 非常值得一試。它提供從語料、工具到行業應用的完整資源地圖,可大幅縮短工具選型與數據蒐集時間。對於已有明確技術棧的團隊,則可作為資源補充與前沿追蹤的參考入口。
對於剛接觸中文自然語言處理的學習者,funNLP 是一座具備清晰分類體系的資源地圖,可以幫助快速理解整個領域的技術版圖,避免在數百個倉庫之間迷失方向。項目收錄的課程資料、競賽方案與面試知識點,更讓學習者能夠在理論與實戰之間建立連結。
對於已有開發經驗的工程師與研究團隊,funNLP 則提供高效的資源檢索價值。無論是尋找特定領域的語料數據、比對不同工具的適用場景,還是追蹤類 ChatGPT 開源模型的最新動態,都能在單一入口完成。項目本身以 Markdown 清單形式維護,結構清晰,適合按需查閱。
funNLP 的關鍵數據表現如何?
funNLP 目前擁有超過 8.2 萬顆星標與 1.5 萬次分支,主要開發語言為 Python,採用公開倉庫形式長期維護。項目自 2018 年 8 月建立以來持續更新,最近一次活躍更新在 2026 年 8 月,顯示維護者仍保持穩定的內容投入。
從數據面觀察,funNLP 的星標數在中文 NLP 資源類項目中位居前列,8.2 萬顆星標的規模反映其社群影響力已超越一般工具庫,達到產業級資源入口的水準。1.5 萬次的 fork 數量則表明大量開發者以該項目為基礎進行二次整理與延伸,形成活躍的分支生態。項目最近一次更新在 2026 年 8 月,顯示其仍處於活躍維護狀態,並非靜態歷史檔案。
出處連結有哪些?
funNLP 的官方儲存庫位於 GitHub,網址為 https://github.com/fighting41love/funNLP。項目以公開倉庫形式提供,讀者可透過 GitHub 頁面瀏覽完整資源清單、提交建議或參與維護。
本篇文章的資訊來源為 funNLP 的官方 GitHub 儲存庫,讀者可前往 https://github.com/fighting41love/funNLP 瀏覽完整的資源分類清單與最新更新內容。
總結:funNLP 的未來前景如何?
funNLP 作為中文 NLP 最具代表性的資源彙整項目,憑藉八年持續累積與對生成式 AI 浪潮的敏銳追蹤,短期內仍將是中文 NLP 開發者的重要參考入口。其長期價值取決於維護者能否持續跟上大模型時代的資源演化速度。
funNLP 的發展軌跡印證了開源社群中「彙整即創造」的獨特價值。在自然語言處理技術快速迭代的背景下,一個具備清晰分類、持續更新與社群信任的資源入口,其資訊組織價值往往不亞於單一工具本身。項目對類 ChatGPT 開源模型的持續追蹤,也顯示其正積極融入大型語言模型時代的知識體系。
展望未來,funNLP 的挑戰在於如何在資源數量持續膨脹的同時維持品質篩選與分類更新。只要維護者持續投入,這個「NLP 民工的樂園」可望繼續扮演中文自然語言處理社群知識基礎設施的角色,為新一代開發者提供進入這個領域的可靠起點。


