
GPT-SoVITS 是 GitHub 星標超過 60,916 顆的開源語音克隆與文字轉語音(TTS)項目,僅需 5 秒參考音訊即可進行零樣本語音合成,使用 1 分鐘訓練資料即可微調出高相似度的個人聲線,支援中文、英文、日文、韓文與粵語的跨語言合成,MIT 授權免費開放,2024 年 1 月發布至今持續更新,是目前開源社群中門檻最低、活躍度最高的語音克隆工具之一。
GPT-SoVITS 是 GitHub 逾 6 萬星的開源語音克隆工具,5 秒音訊即可零樣本合成,1 分鐘資料即可微調聲線,支援中英日韓粵五種語言,MIT 授權免費使用。
GPT-SoVITS 是什麼?
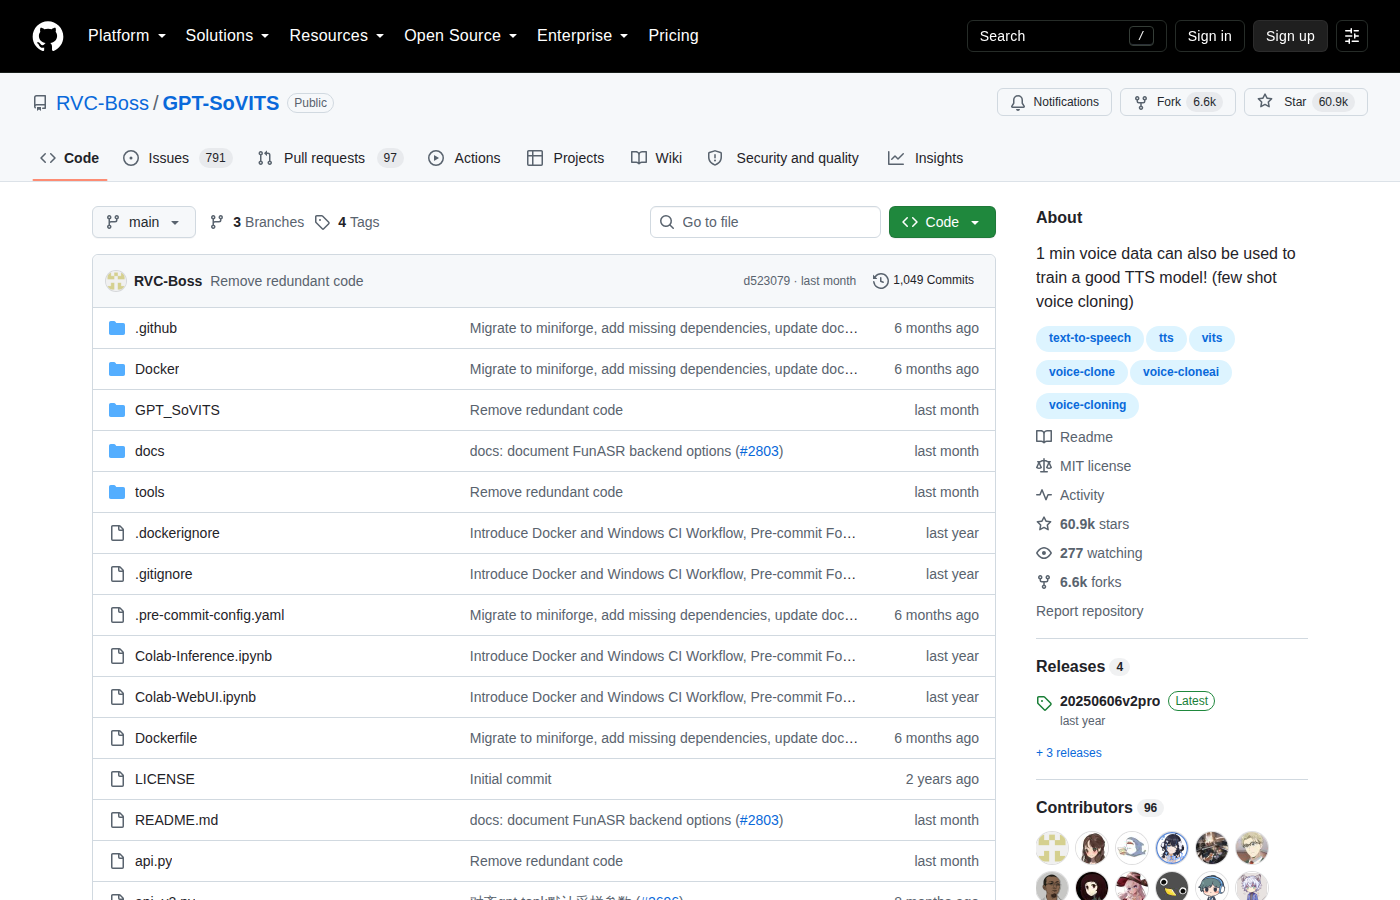
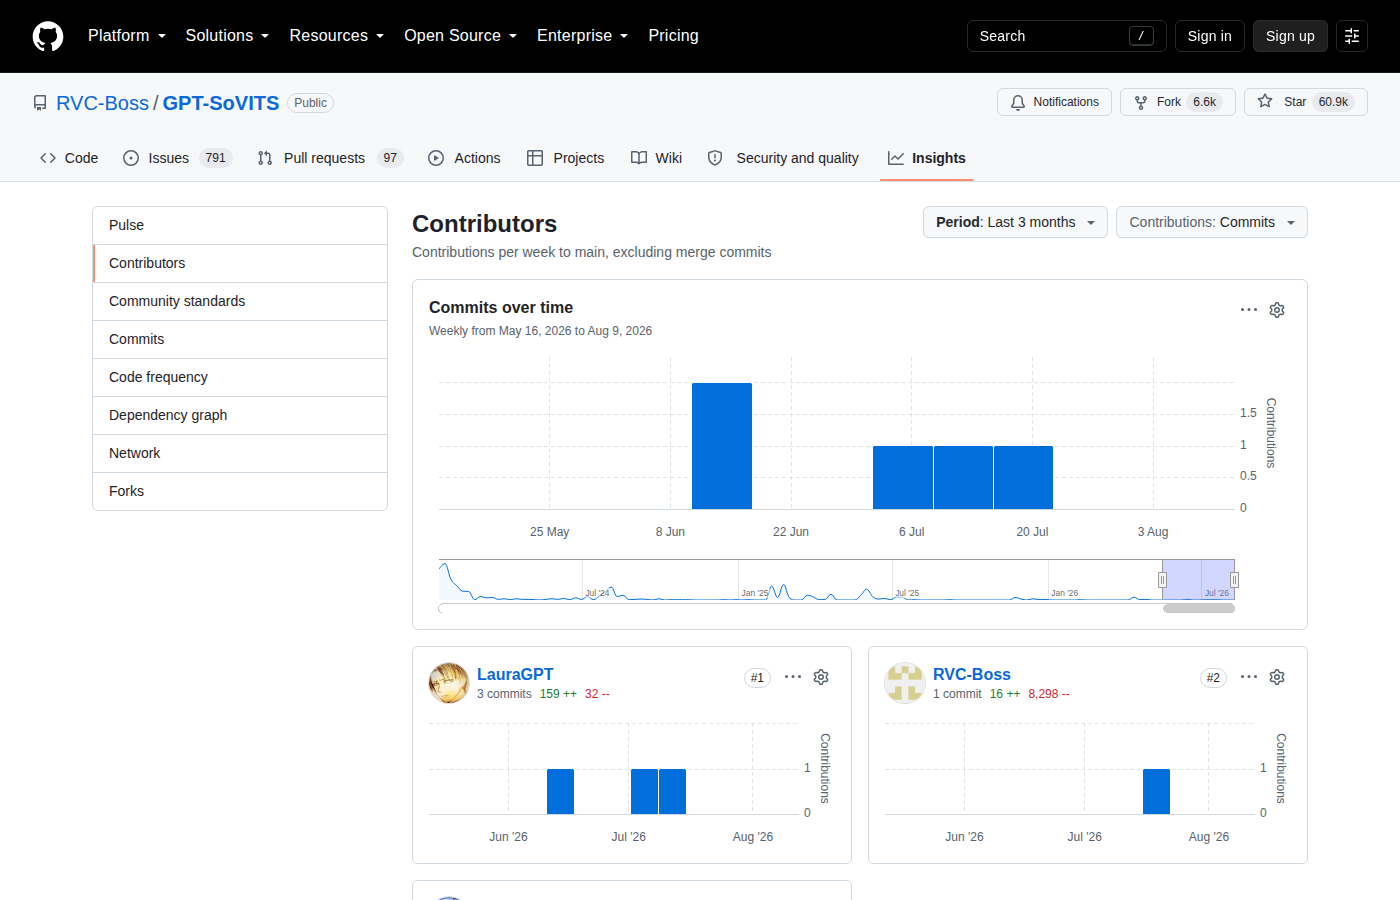
GPT-SoVITS 是由開發者 RVC-Boss 主導的開源語音合成框架,全名為「GPT-SoVITS-WebUI」,定位是一個強大的 Few-shot 語音轉換與文字轉語音網頁介面。項目於 2024 年 1 月 14 日在 GitHub 公開,核心概念來自 SoVITS(Singer-oriented Variational Inference Text-to-Speech)架構,並引入 GPT 風格的自回歸模型強化語音的自然度與相似度。截至 2026 年 8 月,項目已累積超過 6 萬顆星標與 6,600 個 Fork,Issues 討論數超過 790 則,顯示其社群規模與使用廣泛程度。
GPT-SoVITS 是 RVC-Boss 於 2024 年 1 月發布的開源語音克隆框架,結合 SoVITS 架構與 GPT 自回歸模型,提供零樣本與少樣本語音合成能力,社群活躍。
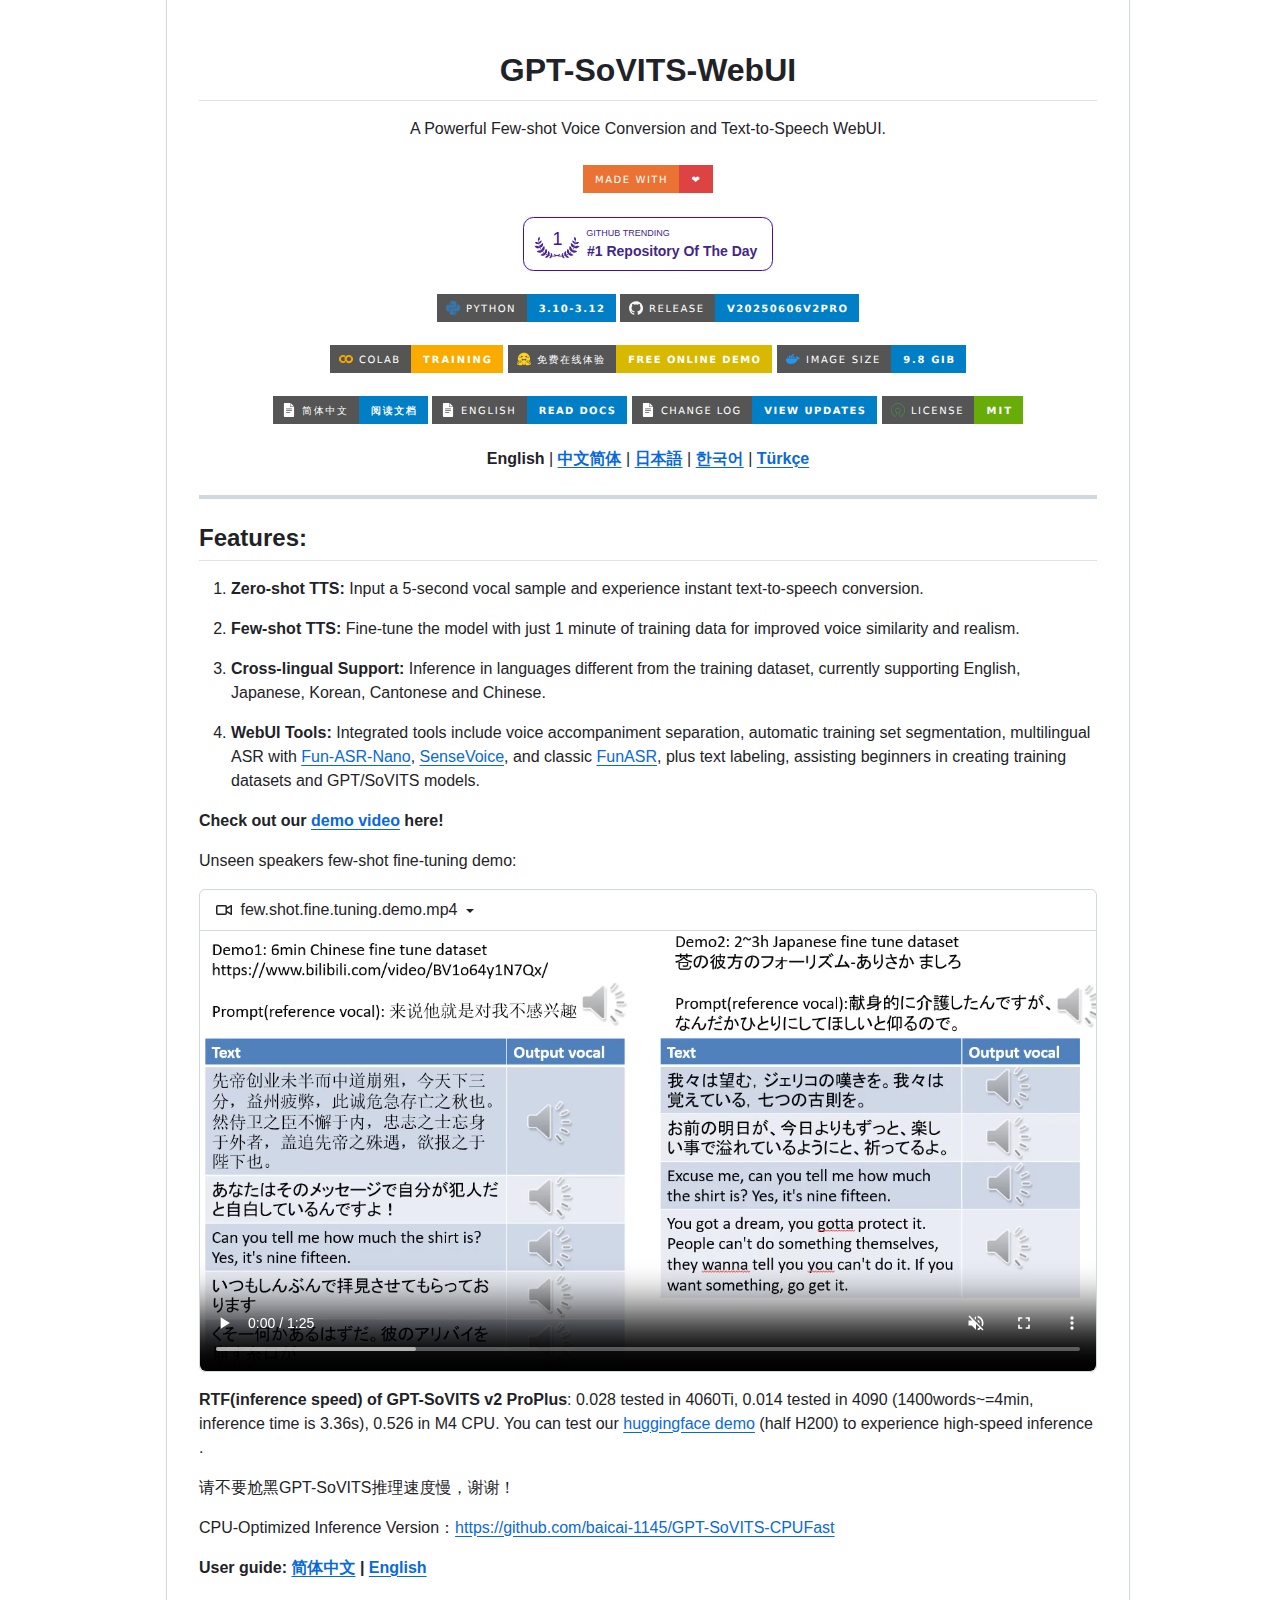
該項目的核心賣點是「極低的資料門檻」:零樣本模式只需輸入 5 秒鐘的參考語音,即可讓模型以該聲線朗讀任意文字;少樣本模式則只需 1 分鐘的訓練資料進行微調,就能顯著提升聲音相似度與真實感。這種設計讓沒有大量錄音素材的一般用戶也能快速建立個人化的語音模型,大幅降低了語音克隆技術的使用門檻,也解釋了其快速累積星標的原因。
項目的核心賣點是低資料門檻:5 秒參考音訊即可零樣本合成,1 分鐘訓練資料即可微調,讓一般用戶不需大量錄音素材也能建立個人化語音模型。
GPT-SoVITS 有哪些核心技術亮點?
GPT-SoVITS 的技術架構融合了多個成熟的研究成果,包括 ar-vits、SoundStorm、VITS、TransferTTS、ContentVec 與 HiFi-GAN 等模型的設計理念。其語音生成流程分為 GPT 模型與 SoVITS 模型兩層:GPT 模型負責將文字序列轉換為語音特徵的離散 token,SoVITS 模型則負責將這些 token 重建為高品質的音訊波形。這種兩階段架構兼顧了文字的語意理解與聲學細節的還原,使合成語音在流暢度與相似度上都有良好表現。
GPT-SoVITS 融合 ar-vits、SoundStorm、VITS 等研究成果,採用 GPT 模型生成語音 token、SoVITS 模型重建波形的兩階段架構,兼顧語意理解與聲學還原。
在 WebUI 工具鏈方面,項目整合了完整的一站式流程:內建人聲與伴奏分離(UVR5)、自動訓練集分割(audio-slicer)、多語言自動語音辨識(ASR,支援 Fun-ASR-Nano、SenseVoice 與經典 FunASR 後端)、文字標註與模型微調介面。用戶只需要提供原始音訊,WebUI 就會自動完成切片、降噪、轉錄與校對等前置作業,讓沒有程式背景的用戶也能完成從資料準備到模型訓練的完整流程。官方同時提供 Colab 訓練筆記本、Docker 映像與 Windows 整合安裝包,大幅降低了環境建置成本。
WebUI 整合人聲分離、音訊切片、多語言 ASR、文字標註與微調介面,自動完成資料前置作業;官方提供 Colab、Docker 與 Windows 整合包,環境建置門檻低。
GPT-SoVITS 如何做到跨語言語音合成?
跨語言合成是 GPT-SoVITS 最具特色的能力之一。模型支援以一種語言的訓練資料,合成另一種語言的語音,目前官方支援中文、英文、日文、韓文與粵語五種語言。這意味著用戶可以用中文語音資料訓練模型,然後讓模型以相同聲線朗讀英文或日文文字,這對多語內容創作者與語言學習場景特別有價值。底層的跨語言能力來自訓練資料中多語言混合的設計,以及前端文字處理對各語言的音素對應支援。
GPT-SoVITS 支援中英日韓粵五種語言的跨語合成,可用單一語言訓練資料生成其他語言的語音,適合多語內容創作與語言學習場景。
值得一提的是,項目對粵語提供了專門支援,由社群成員提供粵語訓練集並指導粵語相關的處理邏輯;韓文與粵語的支援是在 V2 版本新增。這種對亞洲語言的深入支援,使 GPT-SoVITS 在華語與亞洲市場的開發者社群中獲得廣泛關注,也與多數以英文為主的西方開源 TTS 項目形成明顯差異。
項目對粵語提供專門訓練集與處理邏輯,韓文與粵語支援自 V2 版本加入,對亞洲語言的深入支援使其在華語與亞洲社群廣受關注。
GPT-SoVITS 各版本之間有什麼差異?
GPT-SoVITS 自發布以來迭代了多個主要版本,包括 V1、V2、V3、V4 與 V2Pro。V2 版本新增了韓文與粵語支援、優化文字前端,並將預訓練模型從 2,000 小時擴展到 5,000 小時,同時改善了低品質參考音訊的合成品質;V3 版本進一步提升了音色相似度,在完全不微調的情況下也能顯著逼近目標聲線,GPT 模型也更穩定,重複與漏字的情況減少,情感表達更加豐富;V4 版本則修復了 V3 因非整數倍上採樣造成的金屬感雜音問題,原生輸出 48kHz 音訊,官方將其視為 V3 的直接替代版本。
V2 新增韓文粵語並將預訓練資料擴至 5,000 小時;V3 提升音色相似度與情感表達;V4 修復金屬感雜音並原生輸出 48kHz,官方視為 V3 的直接替代。
V2Pro 則是另一個值得關注的分支,它在 V2 的硬體成本與速度基礎上,提供了超越 V4 的性能表現。官方說明指出,V1、V2 與 V2Pro 系列特性相近,在平均音質的訓練集上能產出不錯的結果;而 V3、V4 系列的音色則更偏向參考音訊而非整體訓練集,用戶可以根據自己的資料品質與目標聲線特性選擇合適的版本。多版本並行的策略讓項目能同時服務不同需求的用戶群,也反映了開源項目在快速迭代與穩定兼容之間的平衡。
V2Pro 以 V2 的硬體成本提供超越 V4 的性能;V3、V4 音色更貼近參考音訊,V1、V2、V2Pro 對平均音質訓練集表現較佳,用戶可依需求選版。
GPT-SoVITS 的推理性能表現如何?
在推理速度方面,官方公布了 V2 ProPlus 的實測數據:RTF(Real-Time Factor,即生成 1 秒音訊所需的運算時間)在 NVIDIA RTX 4060 Ti 上為 0.028,在 RTX 4090 上為 0.014,意味著生成約 4 分鐘(1,400 字)的音訊只需約 3.36 秒,遠快於即時播放速度;即使在 Apple M4 的 CPU 上,RTF 也達到 0.526,仍具備可用的即時處理能力。官方同時提供了 CPU 優化版本的獨立分支,以及 Hugging Face 線上 Demo 供用戶直接體驗高速推理效果。
V2 ProPlus 的 RTF 在 RTX 4090 上為 0.014,生成 1,400 字音訊約需 3.36 秒;M4 CPU 為 0.526,官方另提供 CPU 優化分支與線上 Demo。
這種性能表現使 GPT-SoVITS 不僅適合個人實驗,也具備實際生產應用的潛力。批量生成語音、即時配音、互動語音應用等場景都能在消費級 GPU 上流暢運作。配合 Docker 部署與 API 介面(api.py 與 api_v2.py),開發者可以將其整合進自己的應用程式或服務流程,這是許多僅提供研究程式碼的開源 TTS 項目所不具備的工程化優勢。
消費級 GPU 上即時生成語音的性能使其具備生產應用潛力,配合 Docker 部署與 API 介面可整合進自有應用程式,工程化程度高於多數開源 TTS 項目。
如何快速開始使用 GPT-SoVITS?
開始使用 GPT-SoVITS 有幾種途徑。最快速的方式是使用官方提供的 Hugging Face 免費線上 Demo,直接體驗文字轉語音效果;若要完整使用訓練功能,可以選擇 Colab 訓練筆記本,在雲端環境完成模型微調而不需要本地 GPU。本地安裝方面,Windows 用戶可以下載整合安裝包,雙擊 go-webui.bat 即可啟動 WebUI;Linux 與 macOS 用戶則透過 conda 建立 Python 3.10 環境,再執行官方安裝腳本即可。
快速入門可先用 Hugging Face 線上 Demo 體驗效果,再用 Colab 筆記本雲端訓練;本地安裝支援 Windows 整合包與 Linux/macOS 官方安裝腳本。
模型微調流程在 WebUI 中高度自動化:填入音訊路徑後,系統會自動完成音訊切片、降噪、ASR 轉錄與文字校對,接著在微調頁面訓練 GPT 與 SoVITS 模型,最後在推理介面輸入文字即可生成語音。整體流程對首次使用者而言大約一到兩小時內可以完成,官方提供簡體中文與英文的使用者指南,並針對中國大陸用戶提供 ModelScope 鏡像與雲端 Docker 方案,兼顧不同地區的網路環境。
微調流程全自動化:填音訊路徑後自動切片、降噪、轉錄與校對,再訓練模型即可生成語音,首次使用約一至兩小時可完成,官方提供中英文指南。
出處連結有哪些?
本篇文章的資訊來源為 GPT-SoVITS 的 GitHub 官方儲存庫,包含 README 說明文件、版本發布紀錄與官方 Wiki 文件。有興趣的讀者可以前往 GitHub 查看原始碼、功能更新與社群討論。
本篇文章資訊來自 GPT-SoVITS 官方 GitHub 儲存庫,包含 README、版本發布紀錄與 Wiki,讀者可前往查看原始碼、功能更新與社群討論。
出處:RVC-Boss/GPT-SoVITS — GitHub
常見問題有哪些?
總結:GPT-SoVITS 值得一試嗎?
GPT-SoVITS 以 6 萬顆星標驗證了「低門檻語音克隆」的巨大需求。它將過去需要大量錄音素材與專業技術才能完成的語音合成,壓縮到「5 秒音訊、1 分鐘訓練」的極致簡單程度,同時維持了高相似度的合成品質與跨語言能力。對於內容創作者、獨立開發者、語言學習者與需要語音功能的小型團隊而言,GPT-SoVITS 提供了一個免費、開源且工程化完整的解決方案,值得親身一試。隨著版本持續迭代與社群不斷壯大,該項目在開源語音領域的影響力預期將繼續擴大。
GPT-SoVITS 以低門檻、高品質與完整工具鏈滿足語音克隆需求,MIT 授權免費商用,對內容創作者與開發者而言值得一試,開源影響力持續擴大。