
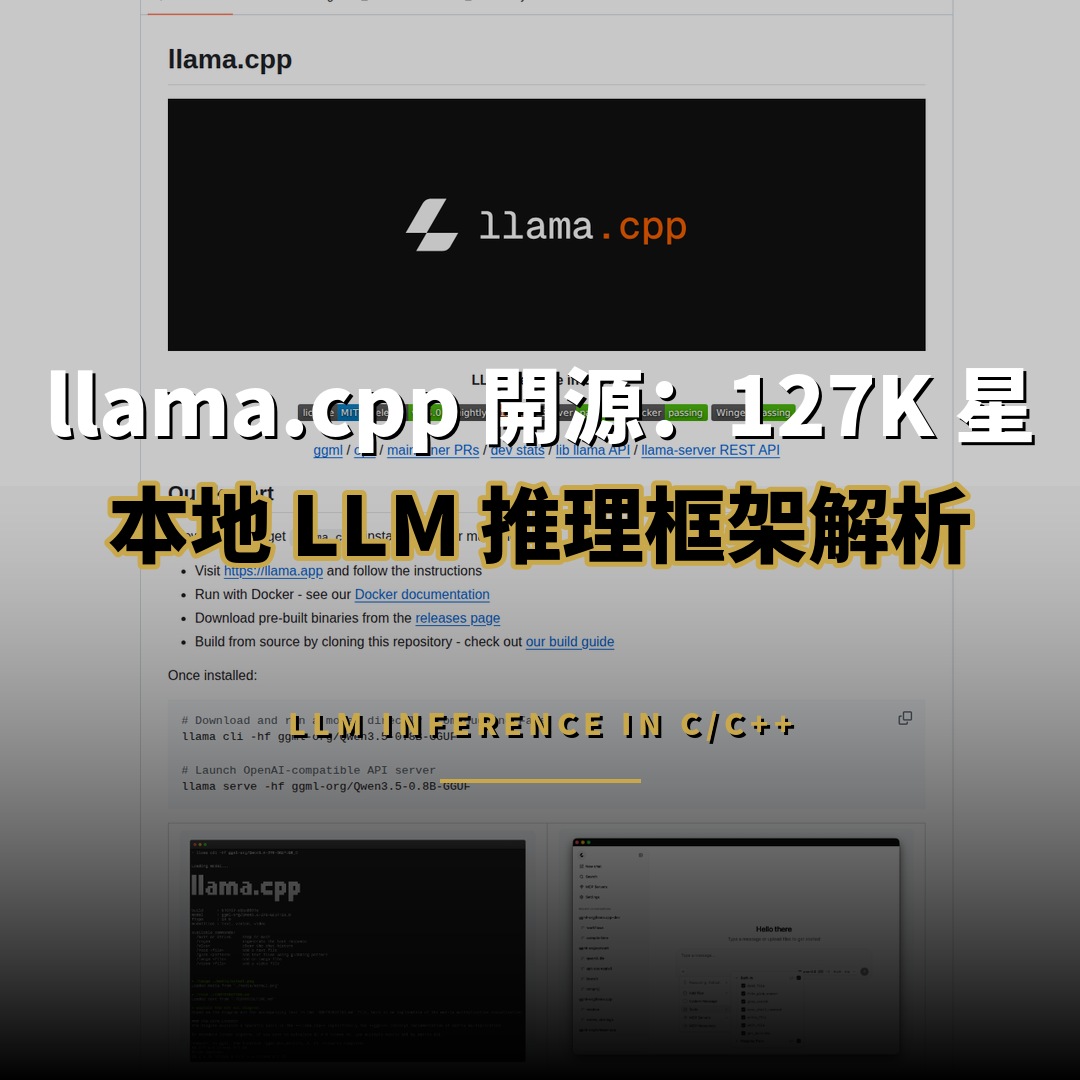
llama.cpp 是 GitHub 上標星數超過 12.7 萬的開源項目,以純 C/C++ 實作大型語言模型(LLM)推理,號稱「零依賴、跨硬件、高性能」,已成為本地 AI 部署領域最具代表性的框架之一。該項目由 Georgi Gerganov 於 2023 年 3 月創立,至今累計獲得 127,278 顆星標與 22,838 次複製(fork),採用 MIT 開源許可證,主要開發語言為 C++,最近一次更新為 2026 年 9 月 6 日。
llama.cpp 是以純 C/C++ 編寫的本地推理框架,GitHub 標星逾 12.7 萬,具零依賴與多硬件後端特色,讓開發者在個人電腦直接運行大型語言模型。
llama.cpp 是什麼?
該項目定位為「在 C/C++ 中執行 LLM 推理(LLM inference in C/C++)」,核心目標是以最少的設定成本,在廣泛的硬件上獲得最先進的推理性能,涵蓋本機與雲端兩種場景。與多數以 Python 為基礎的推理框架不同,llama.cpp 採用純 C/C++ 實作且不依賴任何外部函式庫,因此具備極高的可移植性與啟動效率。
llama.cpp 是專注本機推理的開源框架,以純 C/C++ 零依賴設計為核心,能在 CPU、GPU 與各類加速器上高效運行模型,並提供 OpenAI 相容 API 伺服器。
項目建立在自家開發的 ggml 張量計算函式庫之上,經由連續迭代,現已支援視覺語言模型(VLM)、音訊等多模態能力,並提供 llama cli 與 llama serve 兩套主要工具:前者用於直接與模型互動,後者則啟動一個 OpenAI 相容的 API 伺服器,方便整合進既有應用程式。

llama.cpp 的核心技術亮點有哪些?
llama.cpp 的技術優勢集中體現在量化機制、硬件加速與混合推理三個層面。在量化方面,該框架支援 1.5-bit、2-bit、3-bit、4-bit、5-bit、6-bit 與 8-bit 共七種整數量化格式,開發者可以根據記憶體容量與精度需求自由取捨,大幅降低模型佔用的記憶體空間,這是它能在消費級硬件上運行大模型的關鍵原因。
核心亮點包括 1.5-bit 至 8-bit 七種量化、AVX/AVX512 優化、Metal 原生支援及 CPU/GPU 混合推理,可加速超出顯示卡記憶體的模型。
在硬件加速層面,llama.cpp 對 Apple Silicon 給予第一級支援,透過 ARM NEON、Accelerate 與 Metal 框架進行深度優化;對 x86 架構則提供 AVX、AVX2、AVX512 與 AMX 指令集支援,對 RISC-V 架構亦支援 RVV 等向量擴展。此外,該框架提供自訂 CUDA kernel 以充分發揮 NVIDIA GPU 效能,並透過 HIP 與 MUSA 分別支援 AMD GPU 與摩爾執行緒(Moore Threads)GPU。
值得一提的還有 CPU 加 GPU 混合推理模式,當模型規模超過顯示卡總記憶體(VRAM)容量時,系統會將部分運算分流至 CPU,讓超出單卡容量的模型仍能順利執行。這種設計使 llama.cpp 成為少數可以在記憶體受限環境下運行大模型的推理引擎。
llama.cpp 支持哪些硬件與推理後端?
llama.cpp 的後端支援清單相當完整,幾乎涵蓋市場上的主流運算單元。截至目前,該項目支援的後端包括 CUDA(NVIDIA GPU)、HIP(AMD GPU)、Metal(Apple Silicon)、Vulkan、SYCL(Intel GPU)、OpenCL、WebGPU、CANN(昇騰 NPU)、Hexagon(驍龍平台)、IBM zDNN(IBM Z 大型主機)與 MUSA(摩爾執行緒 GPU)等,合計超過十五種。
llama.cpp 支援逾十五種後端,涵蓋 CUDA、HIP、Metal、Vulkan、WebGPU 與昇騰 CANN 等,可於電腦、手機以至大型主機運行模型。
多元的後端策略意味著開發者不需更換硬件即可完成不同場景的部署:在雲端伺服器上可使用 CUDA 或 SYCL 最大化吞吐量,在筆電上可依靠 Metal 或 Vulkan 發揮整合 GPU 的潛力,在邊緣裝置上則可利用 Hexagon 或 CANN 實現低功耗推理。這種「同一程式碼、多種硬件」的設計,正是該項目獲得大量開發者採用的原因之一。

如何快速開始使用 llama.cpp?
llama.cpp 提供多種安裝途徑,包括直接訪問其官方網站 llama.app 取得安裝程式、使用 Docker 執行容器、下載預編譯的二進位檔案,或從原始碼自行編譯。對於只想快速體驗的用戶,最直接的方式是透過一行指令從 Hugging Face 下載並運行模型。
快速開始只需兩步:安裝後以 llama cli 指令下載並運行模型,或以 llama serve 啟動 OpenAI 相容 API 伺服器,即可直接對外提供推理服務。
# 從 Hugging Face 下載並直接運行模型
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF

# 啟動 OpenAI 相容的 API 伺服器
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
伺服器啟動後即提供與 OpenAI 相容的端點,開發者可以沿用既有 SDK 整合,無需改寫程式碼。項目同時內建網頁介面,可連接至運行中的 llama serve 實例,提供視覺化的對話體驗,降低入門門檻。
llama.cpp 在開源生態中的定位是什麼?
llama.cpp 在開源 AI 生態中扮演「基礎設施層」的角色。它上承 Hugging Face 的模型生態(直接支援 GGUF 格式模型),下接各類應用框架,許多桌面 AI 工具與本地部署方案均以它作為推理引擎。其 MIT 許可證允許商業使用與修改,進一步促進了企業採用。
llama.cpp 是本地 AI 生態的關鍵基礎設施,以 MIT 許可支援商業整合,串接 Hugging Face 的 GGUF 模型生態,並為大量桌面 AI 工具提供底層推理能力。
相較於以 Python 為主的大型框架(如 vLLM、LM Studio 背後的引擎),llama.cpp 的差異化在於輕量與普及:它不需要龐大的執行環境,一枚普通筆電即可運行,這使其成為個人開發者與中小型團隊部署本地模型的優先選擇。而 llama.cpp-dev 開發統計倉庫的設立,也顯示出項目治理正走向更透明的方向。

項目數據總覽
- 127,278Stars
- 22,838Forks
- MITLicense
- C++主要語言
- 2026-09-06最近更新
截至 2026 年 9 月,llama.cpp 累計 127,278 顆星標與 22,838 次 fork,採用 MIT 許可證,主要語言 C++,最近更新為 9 月 6 日,開發仍然活躍。
出處連結有哪些?
本文資訊來源為 llama.cpp 的 GitHub 儲存庫,包含完整的原始碼、文件與更新紀錄。讀者可以前往該倉庫查看最新版本、後端支援清單與社群討論內容。
本文資訊整理自 ggml-org/llama.cpp 的 GitHub 儲存庫,包括 README 說明、原始碼與開發文件,讀者可於該倉庫查閱完整內容與最新版本。
- 官方儲存庫:https://github.com/ggml-org/llama.cpp
- 官方網站:https://llama.app
總結:llama.cpp 適合什麼團隊?
整體而言,llama.cpp 適合所有希望在本地部署大型語言模型的團隊,無論是追求資料隱私的企業、預算有限的個人開發者,還是需要在邊緣裝置執行推理的物聯網系統。其低依賴設計與多元後端支援,讓它能夠適應從高階資料中心到消費級筆電的各種環境。
llama.cpp 適合需要本地部署 LLM 的個人開發者與企業,重視資料隱私、成本控制或邊緣運算場景;MIT 授權與多後端支援,使其成為跨硬件部署模型的可靠選擇。
對初次接觸本地模型的讀者而言,建議先以官方網站提供的安裝程式或 Docker 方式體驗,再逐步探索量化精度與後端選擇的搭配;對已經具備部署經驗的團隊,則可深入研究其混合推理與多模態能力,充分發揮硬件潛力。隨著本地化 AI 需求持續成長,llama.cpp 作為該領域的基礎設施級項目,其地位與影響力預期將進一步擴展。