
LlamaFactory 是 GitHub 上星標逾 74,000 顆的開源大模型微調框架,以單一介面統一支援 100 多款大型語言模型與多模態模型的預訓練、監督微調、獎勵建模與偏好對齊流程,讓開發者透過零代碼指令列或網頁介面即可完成模型調校。 此項目由 hiyouga 團隊自 2023 年 5 月創立,以 Python 撰寫,累積逾 9,100 次 fork,採用 Apache-2.0 授權,相關論文發表於 ACL 2024 並獲逾千次學術引用,官方定位為「Unified Efficient Fine-Tuning of 100+ LLMs & VLMs」。本文將從官方 README 與技術文件出發,分析 LlamaFactory 的架構設計、核心功能與生態影響。
LlamaFactory 是什麼?
LlamaFactory 是開源的大模型微調框架,以單一介面支援 100 多款語言與多模態模型的預訓練、監督微調與偏好對齊,提供零代碼 CLI 與 LLaMA-Board 網頁介面,採用 Apache-2.0 授權,GitHub 星標逾 7.4 萬。
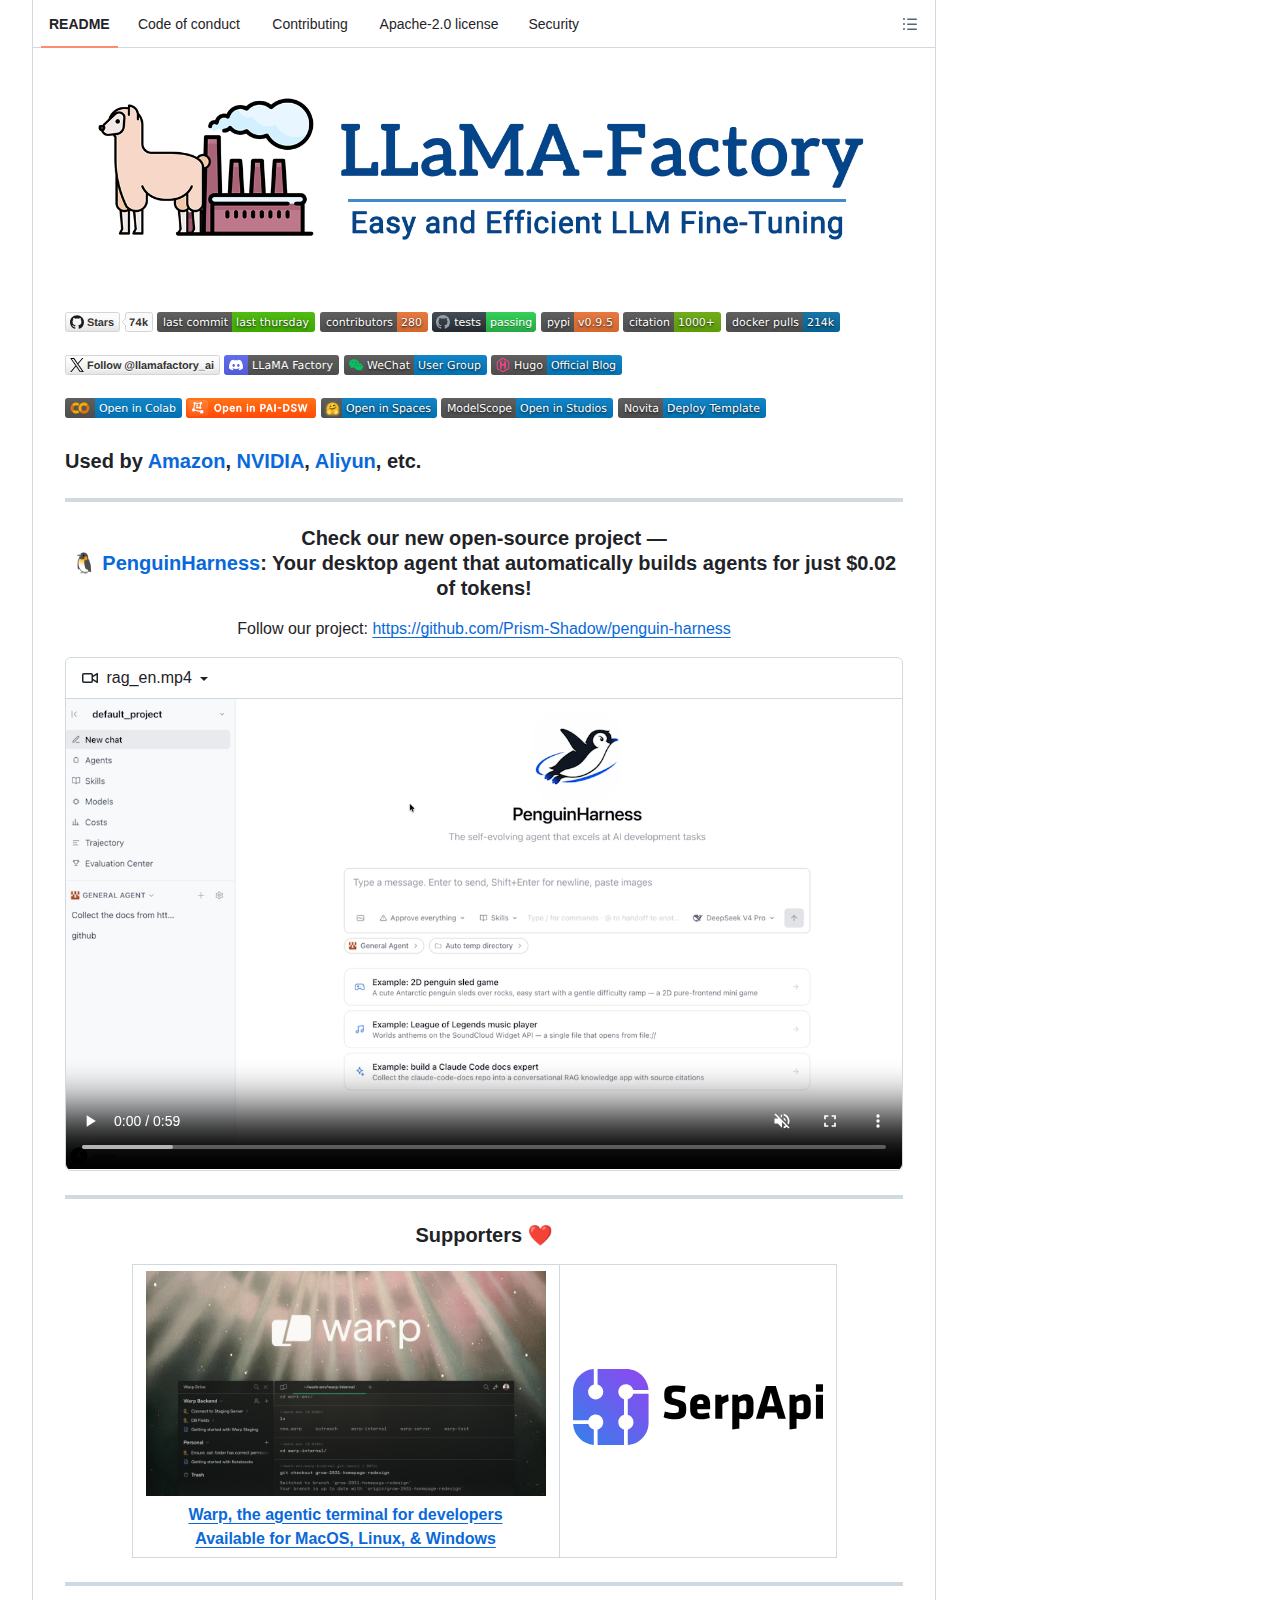
LlamaFactory 的核心設計目標是將大模型微調的複雜流程標準化。傳統上,不同模型的微調需要對應不同的程式碼庫、數據格式與訓練腳本,開發者必須自行處理 tokenizer、對話模板、注意力遮蔽與優化器配置等細節。LlamaFactory 將這些差異抽象為統一的配置層,使用者只需指定模型名稱、數據集與訓練方法,框架即自動載入對應的對話模板與訓練流程,大幅降低微調工程的技術門檻。
項目的官方定位是「Unified Efficient Fine-Tuning of 100+ LLMs & VLMs」,即統一且高效地微調超過一百款大型語言模型與視覺語言模型。其 README 以「Fine-tuning a large language model can be easy as…」開場,強調任何具備基礎 Python 環境的開發者,都能在數分鐘內完成安裝並啟動首次訓練。
LlamaFactory 有哪些核心技術亮點?
LlamaFactory 整合 16-bit 全參數微調、凍結微調、LoRA 與 2 至 8-bit QLoRA 等資源調配方案,並內建 GaLore、BAdam、DoRA、PiSSA 等先進演算法,配合 FlashAttention-2、Unsloth 與 Liger Kernel 加速,讓不同規模的硬體都能完成微調。
在訓練方法層面,LlamaFactory 覆蓋了從基礎到進階的完整譜系。資源配置方面,框架支援 16-bit 全參數微調、凍結微調、LoRA 以及透過 AQLM、AWQ、GPTQ、LLM.int8、HQQ、EETQ 等量化方案實現的 2/3/4/5/6/8-bit QLoRA,開發者可以依照 GPU 記憶體規模選擇最適合的配置。演算法層面,項目整合 GaLore、BAdam、APOLLO、Adam-mini、Muon、OFT、DoRA、LongLoRA、LLaMA Pro、Mixture-of-Depths、LoRA+、LoftQ 與 PiSSA 等多種先進技術,並持續跟進學術界的最新進展。
效能優化是另一項關鍵優勢。框架整合 FlashAttention-2、Unsloth、Liger Kernel 與 KTransformers 等加速元件,官方基準測試顯示 Unsloth 整合可帶來約 170% 的 LoRA 訓練加速,vLLM 推理後端則可實現約 270% 的推論速度提升。項目亦支援 RoPE 外推以擴展上下文長度、NEFTune 雜訊微調與 rsLoRA 等實用技巧,並提供 contamination-free packed training 等工程化功能,滿足長序列與大規模數據的訓練需求。
多模態支援是 LlamaFactory 近年擴展的重點方向。除傳統的純文字模型外,框架支援 LLaVA、Qwen2.5-VL、InternVL、Kimi-VL、PaliGemma 等視覺語言模型的微調,涵蓋圖像理解、視覺定位、影片識別與音訊理解等任務,使開發者能在同一框架內處理多模態模型的調校工作。
LlamaFactory 支援哪些模型與訓練方法?
LlamaFactory 支援 LLaMA、Qwen3、DeepSeek、Gemma、GLM、Phi、Mistral、InternLM 等 100 多款模型的微調,並覆蓋預訓練、監督微調、獎勵建模、PPO、DPO、KTO、ORPO 等訓練方法,且在新模型發布首日即提供支援。
模型支援範圍是 LlamaFactory 生態吸引力的核心。根據官方文件,框架支援的模型涵蓋 Meta 的 Llama 系列與 Llama 4、阿里巴巴的 Qwen3 與 Qwen3-VL、深度求索的 DeepSeek R1 與 MoE 版本、Google 的 Gemma 3、智譜的 GLM-4.5、微軟的 Phi-4、Mistral AI 的 Mistral 與 Mixtral-MoE、上海人工智能實驗室的 InternLM 3、面壁智能的 MiniCPM-o 等逾百款模型,尺寸從 0.1B 到 671B 不等,並陸續加入 ERNIE-4.5、GPT-OSS 與 Kimi-VL 等新興模型。
訓練方法方面,框架整合了監督微調(SFT)、連續預訓練、獎勵建模、PPO、DPO、KTO、ORPO、SimPO 等主流與新興方法,可應對從指令微調到人類偏好對齊的各種需求。項目特別強調「Day-N Support」的更新節奏,即在新模型發布當日或次日即提供微調支援,例如 Qwen3 系列在發布當日(Day 0)即可使用,Llama 3 則在發布次日(Day 1)完成整合,這使 LlamaFactory 成為追蹤前沿模型的快速通道。
如何快速開始使用 LlamaFactory?
使用者可透過 pip install llamafactory 安裝框架,以 YAML 配置檔或 LLaMA-Board 網頁介面啟動訓練,框架提供 Colab 免費筆記本與 Docker 映像,支援本機、雲端與昇騰 NPU 等多種運行環境,數分鐘內即可開始首次微調。
LlamaFactory 的入門流程設計以簡潔著稱。安裝方面,開發者只需執行 pip install llamafactory 即可取得核心套件,框架同時提供 Docker 映像與 Colab 免費筆記本,後者可在 T4 GPU 上完成 Llama-3 模型的微調示範,大幅降低初學者的嘗試成本。對於需要私有化部署的團隊,項目亦提供 ModelScope 與 Modelers Hub 的模型下載整合,方便中國大陸環境使用。
零代碼使用者可以透過 LLaMA-Board 網頁介面完成全部操作。這套以 Gradio 建構的圖形介面整合了數據集管理、模型選擇、訓練配置、評估與推理五大模組,使用者在瀏覽器內點選即可完成從數據準備到模型測試的完整流程,無需撰寫任何程式碼。進階開發者則可使用 YAML 配置檔搭配 CLI 啟動訓練,並透過 OpenAI 風格 API 將微調後的模型部署至任意應用程式。
在硬體需求方面,框架提供極具彈性的資源配置。透過 QLoRA 量化與 FSDP 分片訓練,項目宣稱可在兩張 24GB 顯示卡上完成 70B 模型的微調;使用 Unsloth 長序列方案,則能在 24GB 顯示卡內訓練 Llama-2-7B 的 56k 長上下文版本。此外,框架支援昇騰 NPU、AMD GPU 與雲端平台(如阿里雲 PAI-DSW),並整合 TensorBoard、Wandb、MLflow 與 SwanLab 等實驗監控工具,滿足團隊協作與實驗追蹤需求。
LlamaFactory 的市場影響與生態地位如何?
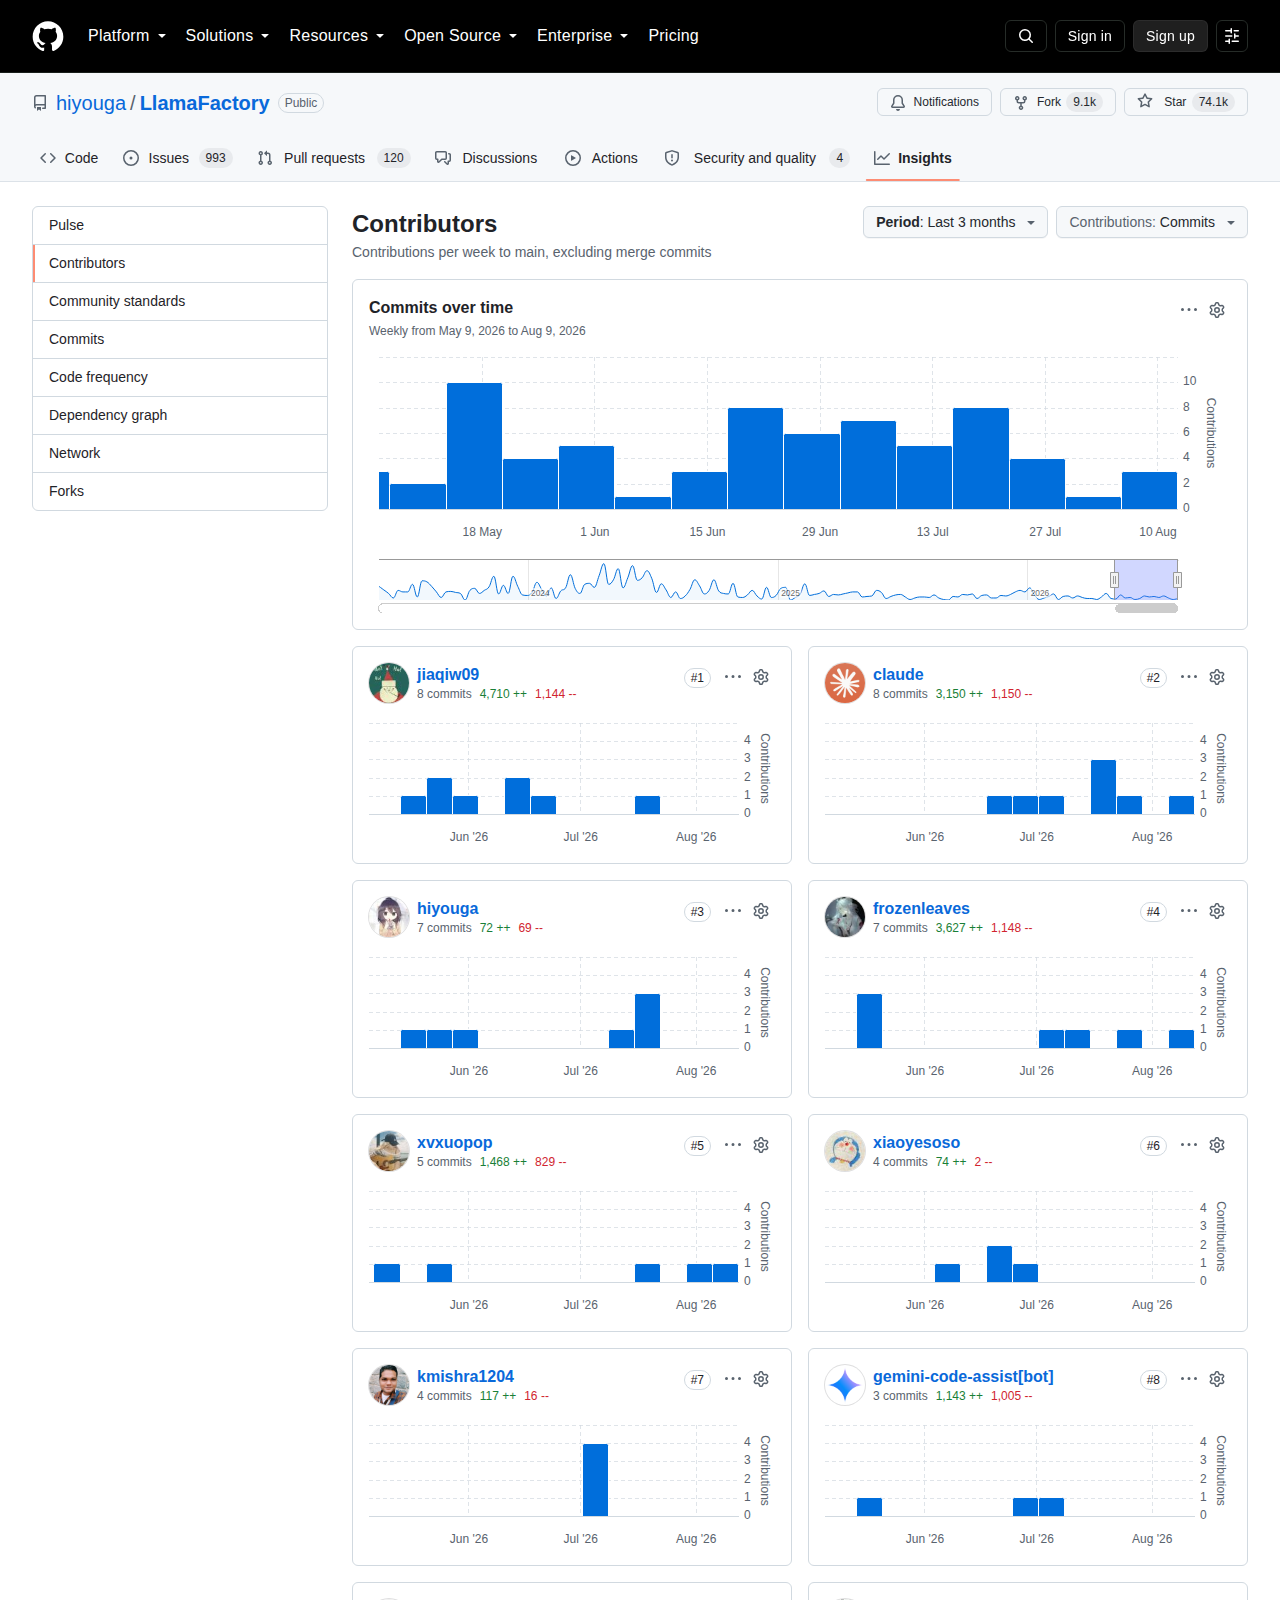
LlamaFactory 已被 Amazon、NVIDIA 與阿里雲等機構用於生產環境與官方教學,其 ACL 2024 論文獲逾千次引用,加上活躍的社群更新與逾 9,100 次 fork,已成為開源大模型微調領域最具代表性的基礎設施項目之一。
在產業採用方面,LlamaFactory 獲得多家科技巨頭的背書。Amazon Web Services 官方部落格刊載了基於 SageMaker HyperPod 與 LlamaFactory 的多模態文件資訊抽取案例,NVIDIA 將其納入 build.nvidia.com 的 Spark 範本,阿里雲則在 PAI 平台提供 LlamaFactory 的微調教學,反映該框架已滲透至主流雲端廠商的 AI 服務棧中。對於企業而言,這種生態整合意味著微調工作可以無縫遷移至各大雲平台,降低供應商鎖定的風險。
在學術影響力方面,項目的研究論文「LlamaFactory: Unified Efficient Fine-Tuning of 100+ Language Models」發表於 ACL 2024,獲逾千次學術引用,成為大模型微調領域的重要參考文獻。項目亦衍生出 FastEdit 等知識編輯工具,並與 EasyR1、DataFlex 等外部專案協作,形成圍繞微調流程的工具生態。官方提供持續更新的技術部落格與社群支援(Discord、WeChat),強化使用者社群的黏著度。
LlamaFactory 的關鍵數據表現如何?
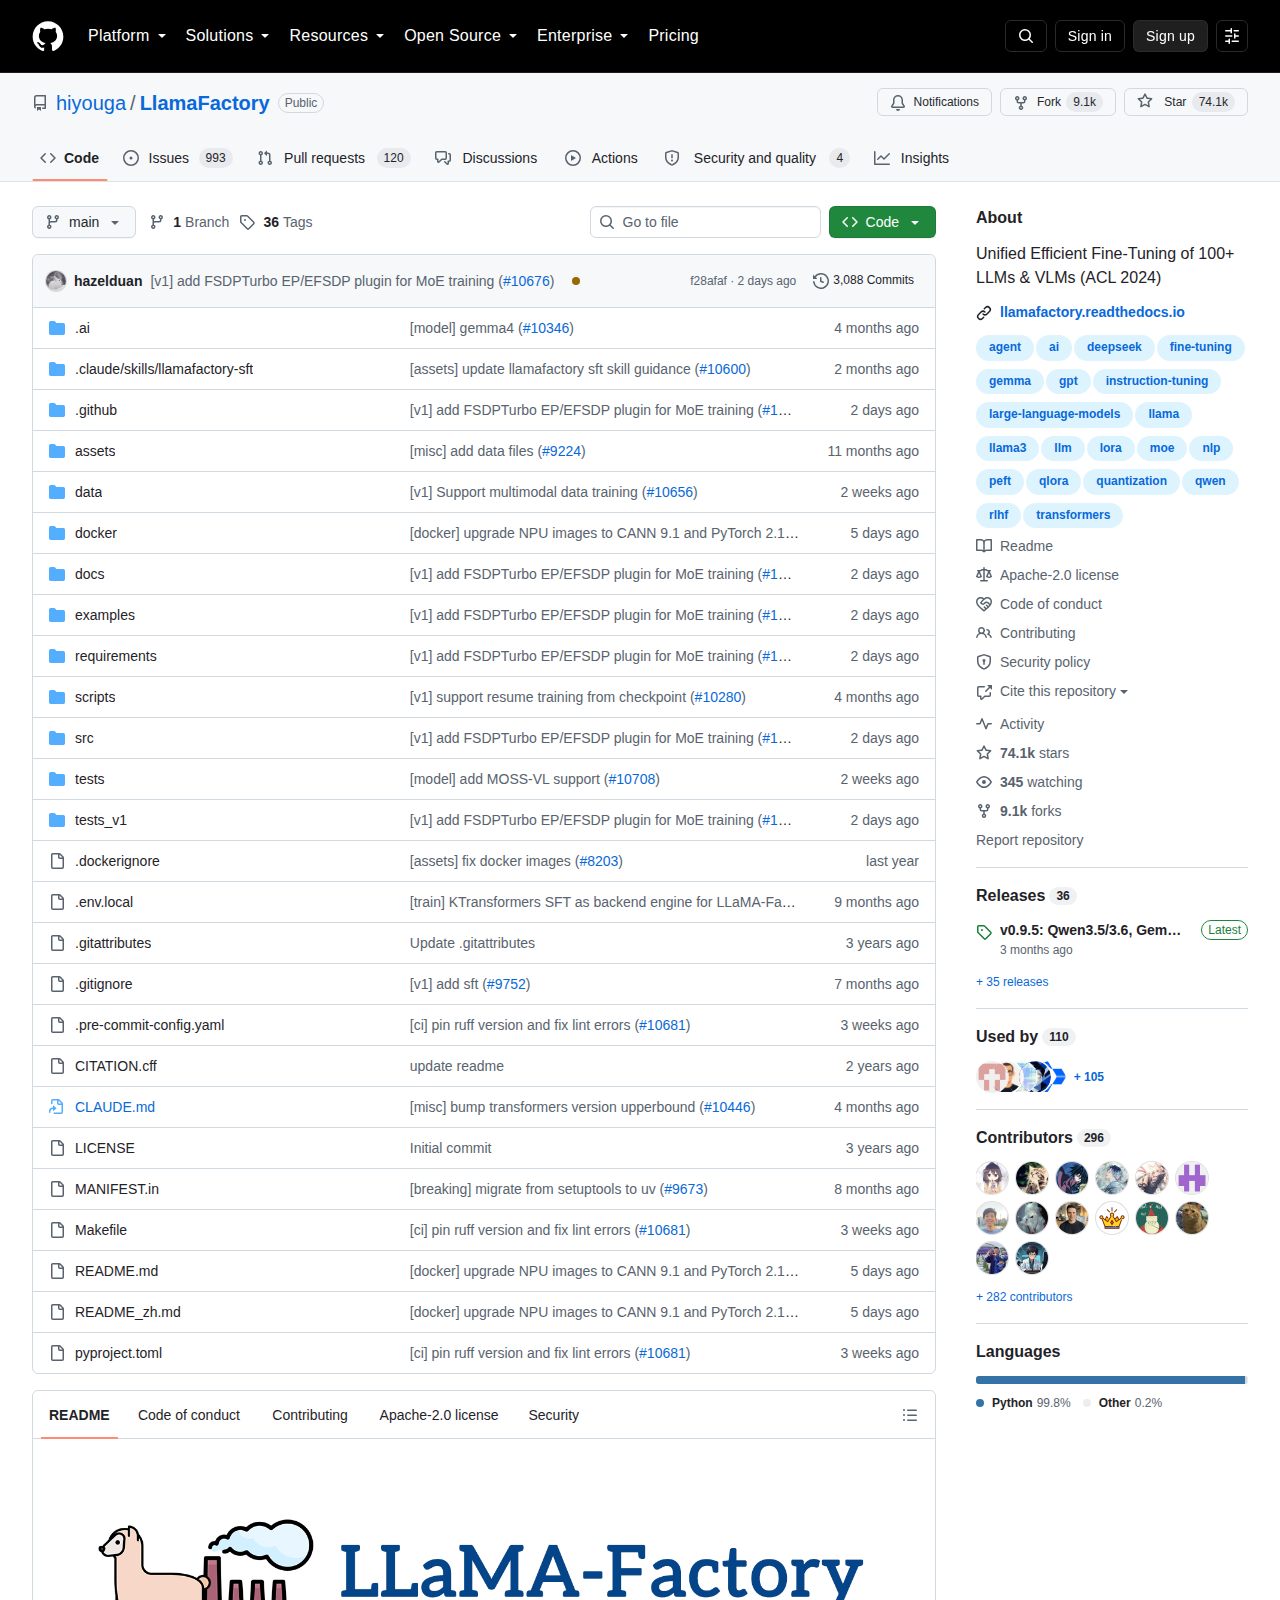
LlamaFactory 累積逾 7.4 萬星標與 9,100 次 fork,以 Python 撰寫,採用 Apache-2.0 授權,創建於 2023 年 5 月,最近活躍更新於 2026 年 8 月,官方網站為 llamafactory.readthedocs.io。
建立日期:2023-05-28|最近 commit:2026-08-15|開發者:hiyouga 團隊|官方網站:https://llamafactory.readthedocs.io|論文:arXiv 2403.13372(ACL 2024)
出處連結有哪些?
本文資料來源為 LlamaFactory 官方 GitHub 儲存庫、官方文件網站與技術部落格,以及發表於 ACL 2024 的研究論文,讀者可透過下列連結查閱原始內容。
常見問題有哪些?
常見問題有哪些?
LlamaFactory 需要什麼硬件配置?
LlamaFactory 的硬體需求具高度彈性。透過 QLoRA 量化,單張消費級 GPU 即可微調 7B 至 13B 模型;搭配 FSDP 分片,兩張 24GB 顯示卡可微調 70B 模型。Colab 免費 T4 環境亦足以完成 Llama-3 的微調示範。LlamaFactory 與 Hugging Face 的關係是什麼?
LlamaFactory 深度整合 Hugging Face 生態,模型與數據集均透過 Hugging Face Hub 載入,框架底層基於 Transformers、PEFT 與 TRL 等函式庫建構,微調完成的模型亦可直接上傳至 Hugging Face 共享。新手可以使用 LlamaFactory 嗎?
可以。LLaMA-Board 網頁介面提供零代碼操作,使用者在瀏覽器內即可完成數據上傳、模型選擇與訓練啟動;官方亦提供 Colab 筆記本與詳細文件,適合初次接觸微調的開發者。LlamaFactory 支援中文模型嗎?
支援。框架涵蓋 Qwen3、DeepSeek、GLM、InternLM 等中文模型系列,並提供中文對話模板與 C-Eval、CMMLU 等中文基準測試整合,可滿足中文場景的微調需求。微調後的模型如何部署?
LlamaFactory 提供 OpenAI 風格 API 伺服器,可與 vLLM 或 SGLang 推理引擎整合,微調完成的模型可透過標準 API 介面接入任意 ChatGPT 架構的應用程式,亦支援 Gradio 介面快速演示。LlamaFactory 的授權可以商用嗎?
可以。項目採用 Apache-2.0 授權,允許商業使用、修改與再分發,僅需保留原始著作權聲明;Amazon、NVIDIA 等企業已將該框架應用於生產環境。總結:LlamaFactory 值得一試嗎?
對於需要將開源大模型調整至特定領域的團隊,LlamaFactory 以零代碼介面、逾百款模型支援與 Apache-2.0 授權,提供了兼顧效率與易用性的完整微調方案,值得作為開源微調工具鏈的首選評估對象。
綜合評估,LlamaFactory 在開源大模型微調領域的定位清晰且具備持續競爭力。其核心價值在於將碎片化的微調工程標準化:逾百款模型、多種訓練方法與完整的效能優化方案被收納於單一框架,配合零代碼介面與彈性硬體需求,使微調從深度工程師的專屬技能擴展為一般開發者皆可掌握的標準流程。對企業而言,Apache-2.0 授權與主流雲平台整合降低了商業化部署的法律與技術風險;對研究機構而言,持續的演算法整合與學術引用使其成為追蹤微調技術進展的可靠基準。整體而言,LlamaFactory 是當前開源大模型微調生態中值得密切關注的代表性項目。