
LlamaIndex 是 GitHub 上擁有超過 5.19 萬星標的開源資料框架,由 Jerry Liu 於 2022 年 11 月創建,官方定位為「數據框架」,專門解決大型語言模型與私有資料之間的連接問題。此項目以 Python 為主要語言,提供資料連接器、索引結構與進階檢索查詢介面,讓開發者能以五行程式碼將企業文件轉化為可查詢的 AI 知識庫,是目前 RAG(檢索增強生成)應用最廣泛使用的開源框架之一。
LlamaIndex 是一個開源的 AI 資料框架,用於將 PDF、網頁、SQL 等私有資料與大型語言模型連接,支援檢索增強生成(RAG)與代理應用開發。目前擁有超過 5.19 萬星標與 8,000 分叉,採用 MIT 授權,提供 300 個以上整合套件。
LlamaIndex 是什麼?
LlamaIndex 由 Jerry Liu 於 2022 年 11 月發起,最初定位為「將大型語言模型與私有資料連接的資料框架」,設計目標是解決 LLM 無法存取企業內部資料的問題。與僅提供模型推論的工具不同,此項目聚焦在資料層:從資料攝取、結構化、索引建立到檢索查詢,提供完整管線。
此專案的核心價值在於降低 RAG 應用的開發門檻。開發者只需安裝 llama-index 套件,透過 SimpleDirectoryReader 讀取文件,再以 VectorStoreIndex.from_documents 建立索引,即可完成一個可查詢的知識庫。高階使用者則可自訂資料連接器、檢索器、查詢引擎與重排序模組,從入門到生產級應用都能涵蓋。
LlamaIndex 是為大型語言模型設計的開源資料框架,提供資料連接器、索引結構與檢索查詢介面,讓 LLM 應用能讀取並查詢私有資料。其高階 API 以五行程式碼完成資料攝取與索引建立,並支援自訂模組延伸。
LlamaIndex 有哪些核心技術亮點?
LlamaIndex 的技術架構圍繞資料攝取與檢索兩大主軸。資料層提供超過百種資料連接器,涵蓋 PDF、DOCX、網頁、SQL 資料庫、API 等格式,並以 300 個以上的整合套件串接主流模型供應商。檢索層則提供多種索引類型,包括向量索引、樹狀索引、知識圖譜索引與關鍵字索引,開發者可依應用場景選擇。
此框架在 2026 年的發展重點轉向代理化能力。官方推出的 LlamaParse 平台專注於 Agentic OCR 與文件解析,支援 130 種以上文件格式的結構化抽取;LlamaAgents 提供端對端文件代理系統,可部署具備工具呼叫能力的文件代理。其 Workflows 機制讓開發者能以事件驅動方式組合複雜的代理流程,這是此框架與傳統 RAG 工具最大的差異。
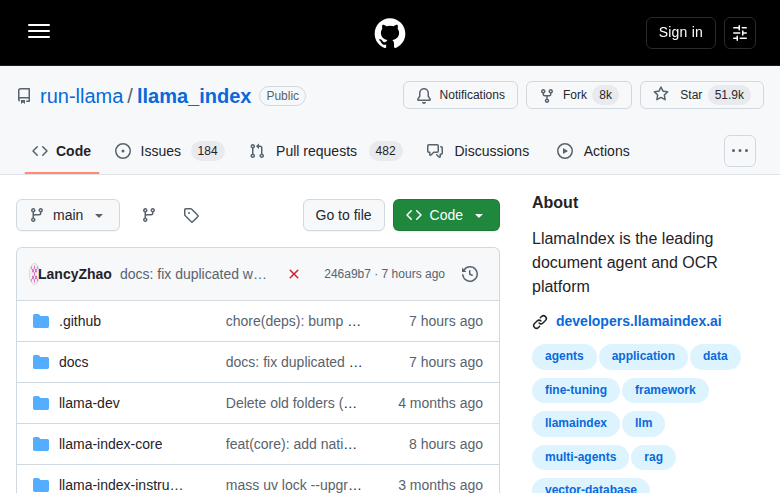
LlamaIndex 的核心亮點包括:超過百種資料連接器、多種索引類型(向量、樹狀、知識圖譜)、300 個以上整合套件,以及 Workflows 事件驅動代理機制。其 LlamaParse 平台提供 Agentic OCR 能力,支援 130 種文件格式的結構化抽取。
LlamaIndex 與 LangChain 有什麼不同?
LlamaIndex 與 LangChain 同為 LLM 應用開發的主流框架,但切入角度不同。LangChain 定位為「應用編排框架」,提供鏈(Chain)、代理(Agent)與工具呼叫等應用層抽象;LlamaIndex 則聚焦「資料層」,強調資料索引、檢索與查詢引擎的深度最佳化。實務上,許多開發者會同時使用兩者:以 LlamaIndex 處理資料攝取與檢索,以 LangChain 編排整體應用流程。
此差異反映在各自的架構設計上。LlamaIndex 的查詢引擎直接封裝檢索、重排序與回應合成邏輯,對 RAG 場景提供開箱即用的體驗;LangChain 則提供更泛用的代理與工具生態。值得注意的是,LlamaIndex 的整合套件近年也加入代理與工作流能力,兩框架的功能邊界正逐漸模糊,開發者選擇時應以資料管線複雜度與既有生態為主要考量。
LlamaIndex 專注於資料層,提供索引、檢索與查詢引擎的深度最佳化;LangChain 則聚焦應用編排,提供鏈與代理抽象。兩者可互補使用,實務上常見以 LlamaIndex 處理資料、以 LangChain 編排流程的組合。
如何快速開始使用 LlamaIndex?
LlamaIndex 提供兩種安裝方式:初學者可直接安裝 llama-index 完整套件,包含核心功能與常用整合;進階使用者則安裝 llama-index-core 並依需加入個別整合套件。實際使用時,開發者以 SimpleDirectoryReader 讀取資料目錄,透過 VectorStoreIndex.from_documents 建立向量索引,再以 query_engine.query 完成查詢,全程只需數行程式碼。
此框架支援多種模型後端。除 OpenAI 外,可透過設定類別串接 Ollama 本地模型、HuggingFace 嵌入模型等,適合重視資料私隱的部署場景。索引建立後可將儲存上下文持久化至磁碟,下次啟動直接載入,無需重複攝取文件。官方文件提供完整的範例與逐步教學,涵蓋從基本 RAG 到多代理系統的各種應用。
開始使用 LlamaIndex 只需三步:安裝 llama-index 套件、以 SimpleDirectoryReader 讀取資料、用 VectorStoreIndex.from_documents 建立索引並以 as_query_engine 查詢。支援 OpenAI、Ollama 與 HuggingFace 等多種模型後端。
LlamaIndex 的商業化路徑是什麼?
LlamaIndex 採取開源核心與雲端平台並行的雙軌策略。開源版本以 MIT 授權維持社群擴散,累積超過 5.19 萬星標與 1,904 位貢獻者;商業化則透過 LlamaCloud 平台實現,提供 Agentic OCR、結構化資料抽取與託管檢索服務,讓企業以 API 形式使用 LlamaParse 等進階能力。
此商業模式與其他開源 AI 框架一致:以開放框架建立開發者生態,再以託管服務與企業功能變現。LlamaIndex 的差異在於強化文件代理與 OCR 領域,直接對應企業文件處理的高頻需求。對個人開發者而言,開源版本已涵蓋大部分使用場景;對需要 SLA、擴展性與資料管線託管的團隊,雲端平台則提供付費路徑。
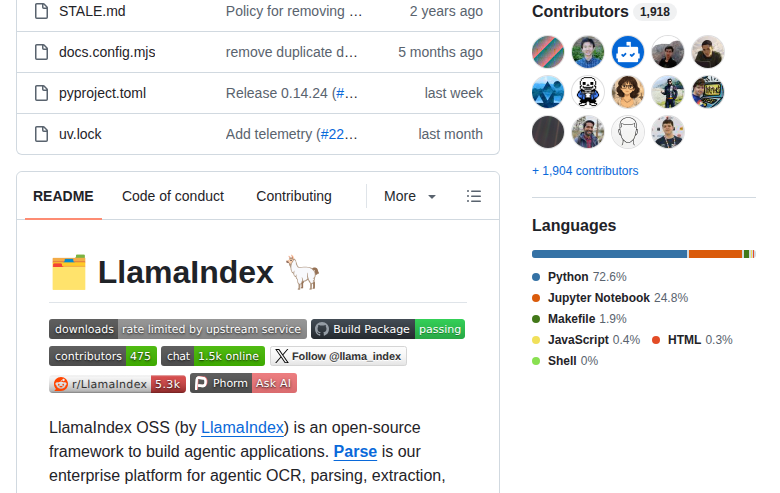
LlamaIndex 以 MIT 授權的開源框架建立開發者生態,透過 LlamaCloud 平台提供 Agentic OCR、結構化抽取與託管檢索服務變現,形成開放擴散與企業付費並行的雙軌商業模式。
出處連結有哪些?
本文資訊來源為 LlamaIndex 的 GitHub 儲存庫,包含完整的 README 文件、安裝指引、API 參考與整合套件清單。讀者可前往官方儲存庫查看原始碼、範例與社群討論,相關文件與 LlamaCloud 產品資訊亦可在官方文件網站取得。
本文資訊來源為 run-llama/llama_index 的 GitHub 儲存庫,官方文件位於 developers.llamaindex.ai。讀者可查看原始碼、安裝指引、整合套件清單與最新版本資訊。
- GitHub 儲存庫:run-llama/llama_index
- 官方文件:LlamaIndex Documentation
總結:LlamaIndex 適合什麼團隊?
LlamaIndex 適合需要將私有資料轉化為可查詢知識庫的團隊,包括 RAG 應用開發者、企業文件處理部門與 AI 產品團隊。其低門檻 API 適合快速原型,進階模組與雲端平台則支援生產級部署,目前仍持續擴展代理與 OCR 能力。
LlamaIndex 以資料層為核心的定位,使其在 RAG 與文件智能領域建立穩固的開源地位。其超過 5.19 萬星標與 8,000 分叉反映社群認可度,MIT 授權與雙軌商業模式則平衡開放與永續發展。對需要將大型語言模型與自有資料整合的開發者與企業而言,此框架提供從原型到生產的完整路徑,未來在代理系統與文件處理領域的擴展值得持續關注。