
LocalAI 是 GitHub 星標超過 48,555 顆的開源 AI 引擎,以 Go 語言撰寫、採用 MIT 授權,核心定位是讓使用者在任何硬件——包括 NVIDIA、AMD、Intel、Apple Silicon、Vulkan 甚至純 CPU——上運行任意型態的模型,涵蓋大型語言模型、視覺、語音、影像與視訊,且無需 GPU 即可在本地端完整部署;項目於 2023 年 3 月由 Ettore Di Giacinto 發起,並提供與 OpenAI、Anthropic、ElevenLabs 相容的 API,成為在地端自架 AI 服務的熱門選擇。
LocalAI 是以 Go 撰寫、MIT 授權的開源 AI 引擎,可於 NVIDIA、AMD、Intel、Apple Silicon、Vulkan 及純 CPU 硬件上運行 LLM、視覺、語音、影像與視訊等模型,相容 OpenAI、Anthropic、ElevenLabs API,GitHub 星標逾 4.8 萬。
LocalAI 是什麼?
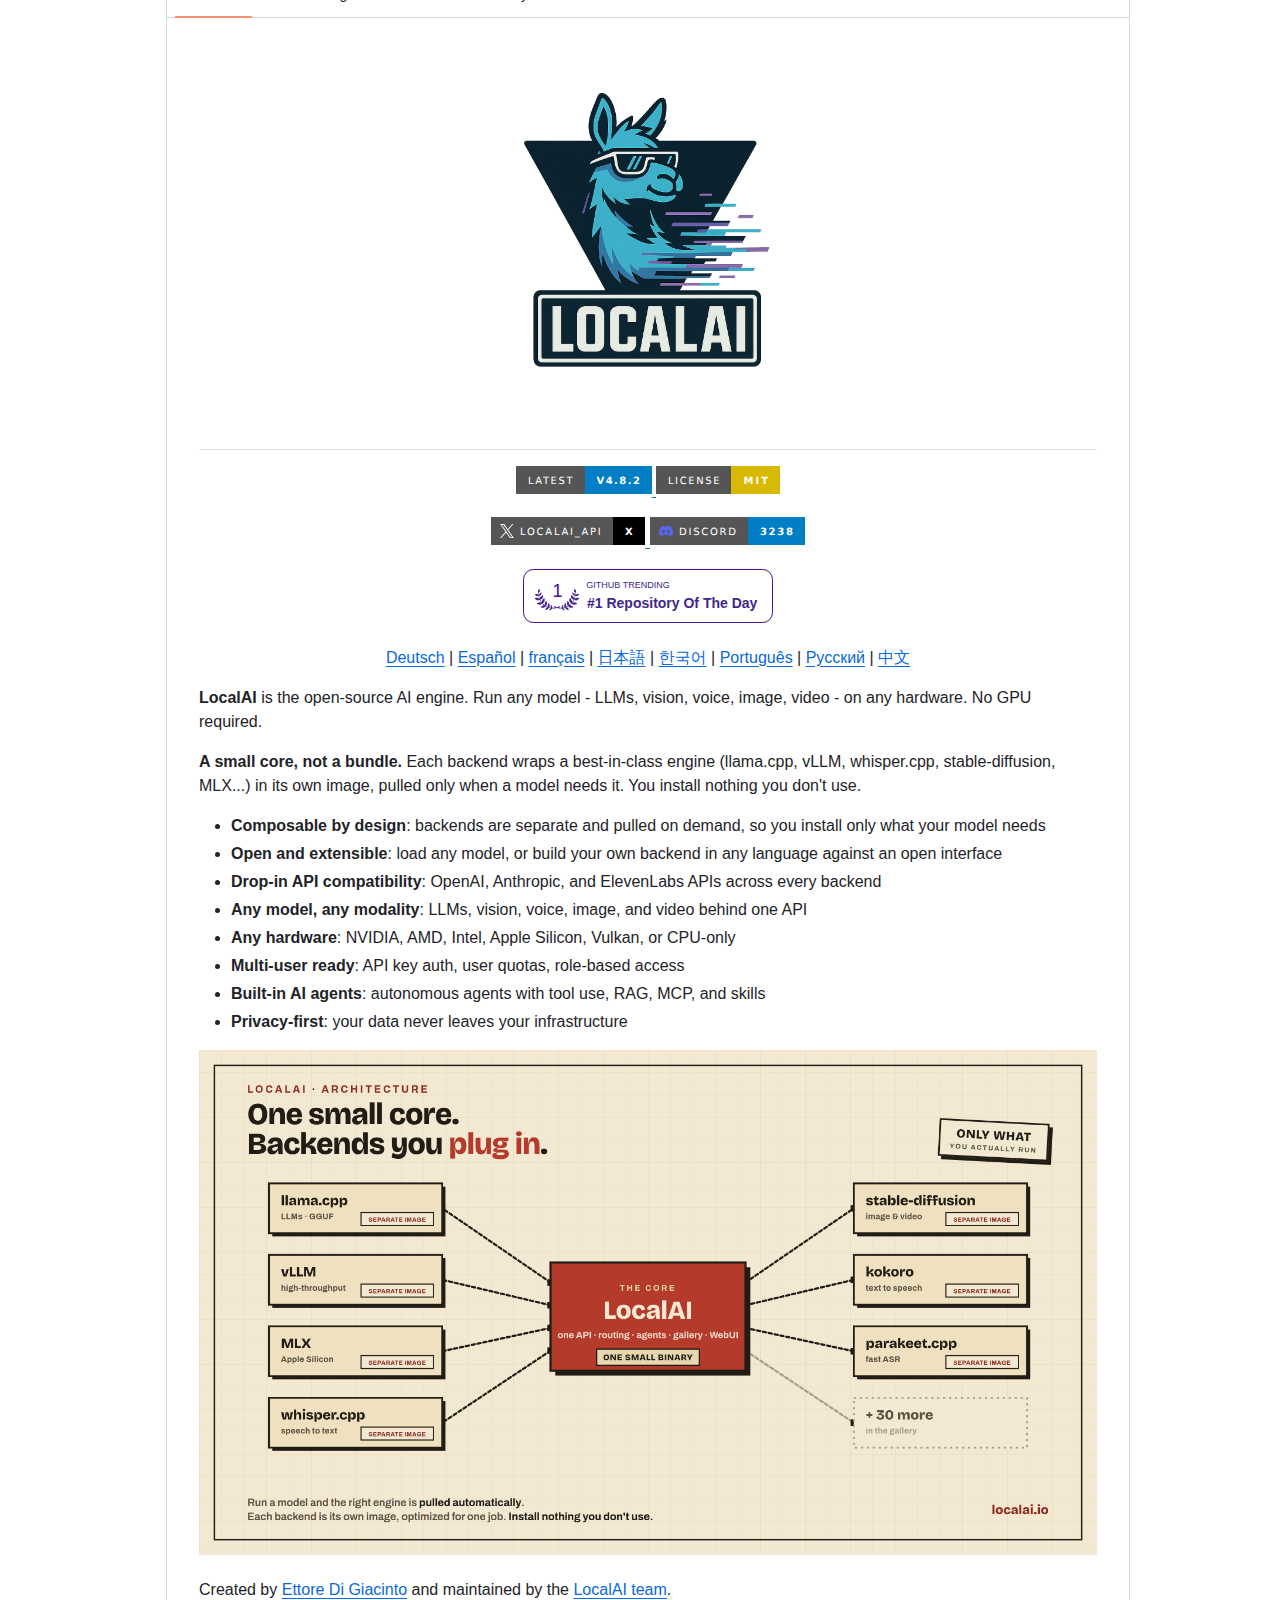
LocalAI 是一套「開源 AI 引擎」,其設計哲學是「小核心、非捆綁」(a small core, not a bundle)。不同於把一大堆推理引擎全部塞進單一程式的做法,LocalAI 將每個後端(backend)包成獨立映像檔,只在需要該模型時才拉取,因此使用者安裝的內容恰好就是自己會用到的部分,不會白佔儲存與記憶體。
LocalAI 是「小核心、非捆綁」的開源 AI 引擎,每個後端獨立成映像檔、按需拉取,讓使用者只安裝自己需要的部分,不浪費儲存與記憶體。
在相容性方面,LocalAI 針對 OpenAI、Anthropic 與 ElevenLabs 的 API 提供 drop-in 級相容,意味著原本面向這些雲端服務的應用程式,可以幾乎不修改就把呼叫導向本地端的 LocalAI。而它同時支援「任何模型、任何模態」,在同一個 API 介面下即可串接大型語言模型、視覺理解、語音合成、語音辨識、影像生成與視訊生成,並具備多使用者支援(API 金鑰驗證、配額、角色權限)與內建的自主 AI Agent。
LocalAI 有哪些核心技術亮點?
LocalAI 的第一個技術亮點是模組化的後端設計。項目支援超過 60 個後端,涵蓋 llama.cpp、vLLM、SGLang、transformers、whisper.cpp、diffusers、MLX 等工程上各擅勝場的引擎,並針對 NVIDIA、AMD(ROCm)、Intel(oneAPI/SYCL)、Apple Silicon(Metal)、Vulkan 與 NVIDIA Jetson 提供硬件加速;後端可從 Backend Gallery 隨時安裝或移除,形成一套可組合、可擴展的推理基礎設施。
技術亮點一是模組化後端:支援超過 60 個後端(llama.cpp、vLLM、transformers、MLX 等),並對 NVIDIA、AMD、Intel、Apple Silicon、Vulkan 提供硬件加速,可隨裝隨卸。
第二個亮點是自研的輕量 C/C++/GGML 引擎。LocalAI 團隊並非只封裝既有上游引擎,也親自開發了多個原生引擎,例如從零撰寫的 vLLM C++20 移植版 vllm.cpp(具備分頁 KV 快取、連續批次、前綴快取)、以 C++/GGML 實作的 ASR 引擎 parakeet.cpp、純 C 撰寫的 Voxtral TTS、以及臉部偵測、說話者辨識、3D 重建等一系列模態引擎;這些引擎在推理階段完全不依賴 Python 或 onnxruntime,GGUF 權重自帶、與參考實作位元級一致,體現了「為地端輕量化而刻意打磨」的工程取捨。
技術亮點二是自研輕量引擎:LocalAI 親自開發 vllm.cpp、parakeet.cpp、Voxtral TTS 等原生 C/C++/GGML 引擎,推理階段不依賴 Python/onnxruntime,適合地端輕量化部署。
第三個亮點是「一台引擎包辦一切」的整合能力。LocalAI 不只是純文字推理,而是把嵌入向量生成、重排序、工具呼叫、Real-time 語音對語音 API、物件偵測、RAG、MCP、自主 Agent 與視覺/影像/視訊生成整合進同一個介面。尤其值得注意的是它的分散式模式——支援以 PostgreSQL 與 NATS 進行水平擴充與智慧路由,讓單機地端服務也能延伸成可橫向擴展的叢集。此外它具備隱私優先特性,資料可完全停留在使用者的基礎設施內,不會外送。
技術亮點三是全功能整合:嵌入、重排序、工具呼叫、即時語音 API、RAG、MCP、自主 Agent 與多模態生成整合於單一介面,並支援 PostgreSQL+NATS 的水平擴充。
LocalAI 支援哪些硬體與模型?
在硬件支援上,LocalAI 強調「任何硬件、無需 GPU」。正式支援的加速平台包括 NVIDIA(CUDA 12/13)、AMD(ROCm)、Intel(oneAPI)、Apple Silicon(Metal)、Vulkan,以及 NVIDIA Jetson 系列(L4T),未搭配 GPU 的純 CPU 環境亦能運行;官方以 Docker、Podman 等容器方式發布不同硬體對應的映像(例如 localai/localai:latest-gpu-nvidia-cuda-13、-gpu-hipblas、-gpu-intel、-gpu-vulkan),並提供 macOS 原生應用與內建後端自動偵測,讓系統自行判斷 GPU 能力並下載對應後端。
LocalAI 支援 NVIDIA、AMD、Intel、Apple Silicon、Vulkan 與 Jetson,純 CPU 也能運行;透過 Docker 提供各硬體對應映像,並自動偵測 GPU 下載對應後端。
在模型載入方式上,LocalAI 也做到高度彈性。使用者可以從官方模型廊(model gallery)、Hugging Face、Ollama 的 OCI registry、標準 OCI registry(如 Docker Hub),甚至以純 YAML 設定檔載入模型,並透過 local-ai run 命令一行啟動。它同時提供內建的指令行 Agent,可在終端機中問答、讀取檔案並執行指令,於變更狀態前要求使用者核准,接近一個可以實際協作的本地 AI 助手。
模型載入高度彈性:可從官方模型廊、Hugging Face、Ollama、任意 OCI registry 或 YAML 設定載入,並內建可在終端協作的 Agent,改動前會要求使用者核准。
LocalAI 與 OpenAI 及本地方案相比如何?
相對於 OpenAI、Anthropic 等雲端商業服務,LocalAI 的差異在於「自架、隱私優先與成本可控」。它相容 OpenAI、Anthropic 與 ElevenLabs 的 API,讓既有雲端應用可以幾乎無痛切換到本地端,資料不再離開自家基礎設施;而 macOS、純 CPU 等低門檻支援,也大幅降低了想要「在地跑 AI」卻沒有高階 GPU 的開發者門檻。它並非取代雲端方案,而是提供一條把推理留在本地的替代路線,並以分散式模式滿足需要橫向擴充的場景。
相較雲端商業服務,LocalAI 主打自架、隱私優先與成本可控,相容 OpenAI/Anthropic/ElevenLabs API 讓既有應用無痛切換,並以低門檻硬件支援降低地端部署門檻。
以本地開源方案而言,常見的競品包括 Ollama 與 LM Studio 等。LocalAI 的定位更接近「完整引擎」而非單一模型工具——它同時涵蓋視覺、語音、影像、視訊與自主 Agent,並具備分散式叢集、MCP、內建身分驗證與配額等平台級功能;而它的「小核心、非捆綁」與自研輕量引擎,則讓它在資源受限場景與多模態整合上有明顯差異。整體而言,LocalAI 較適合需要把多種 AI 能力整合進自管基礎設施、又重視隱私與成本控管的團隊。
# 以 CPU 模式一行啟動 LocalAI(Docker)
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
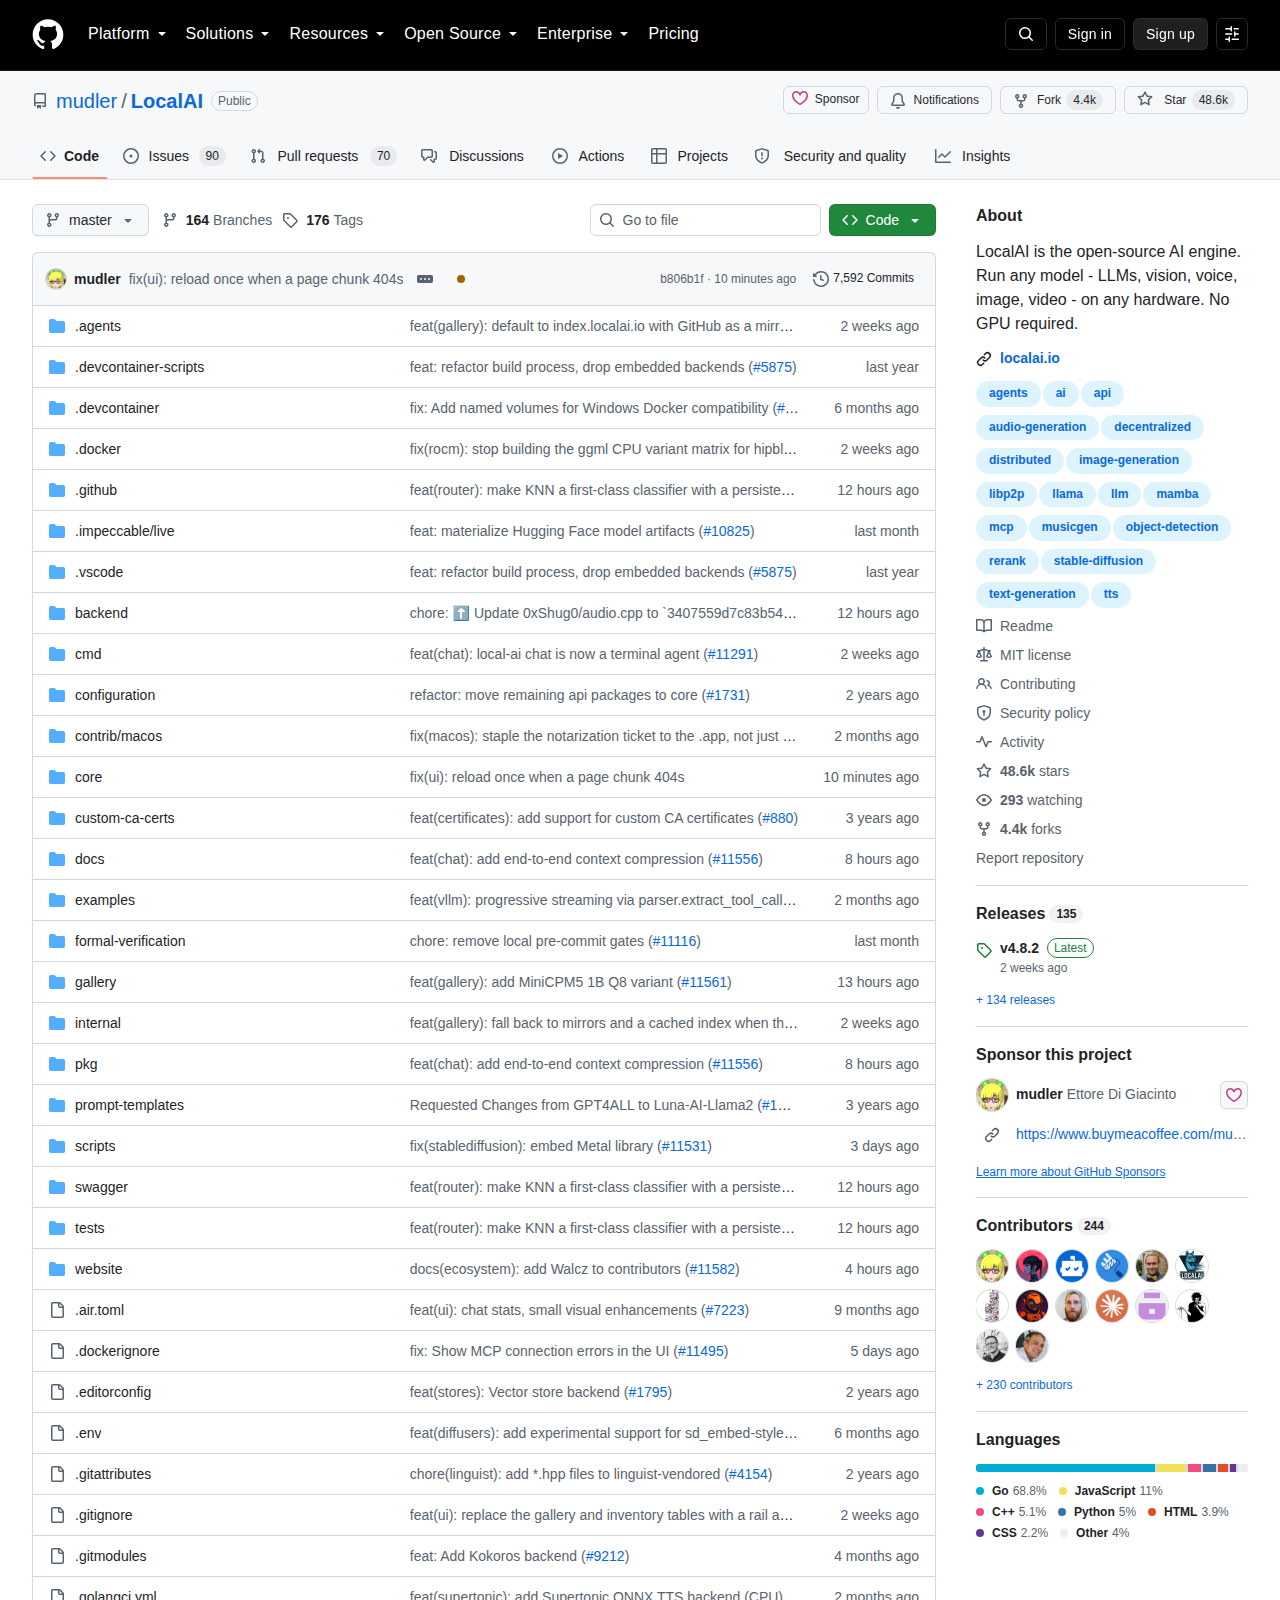
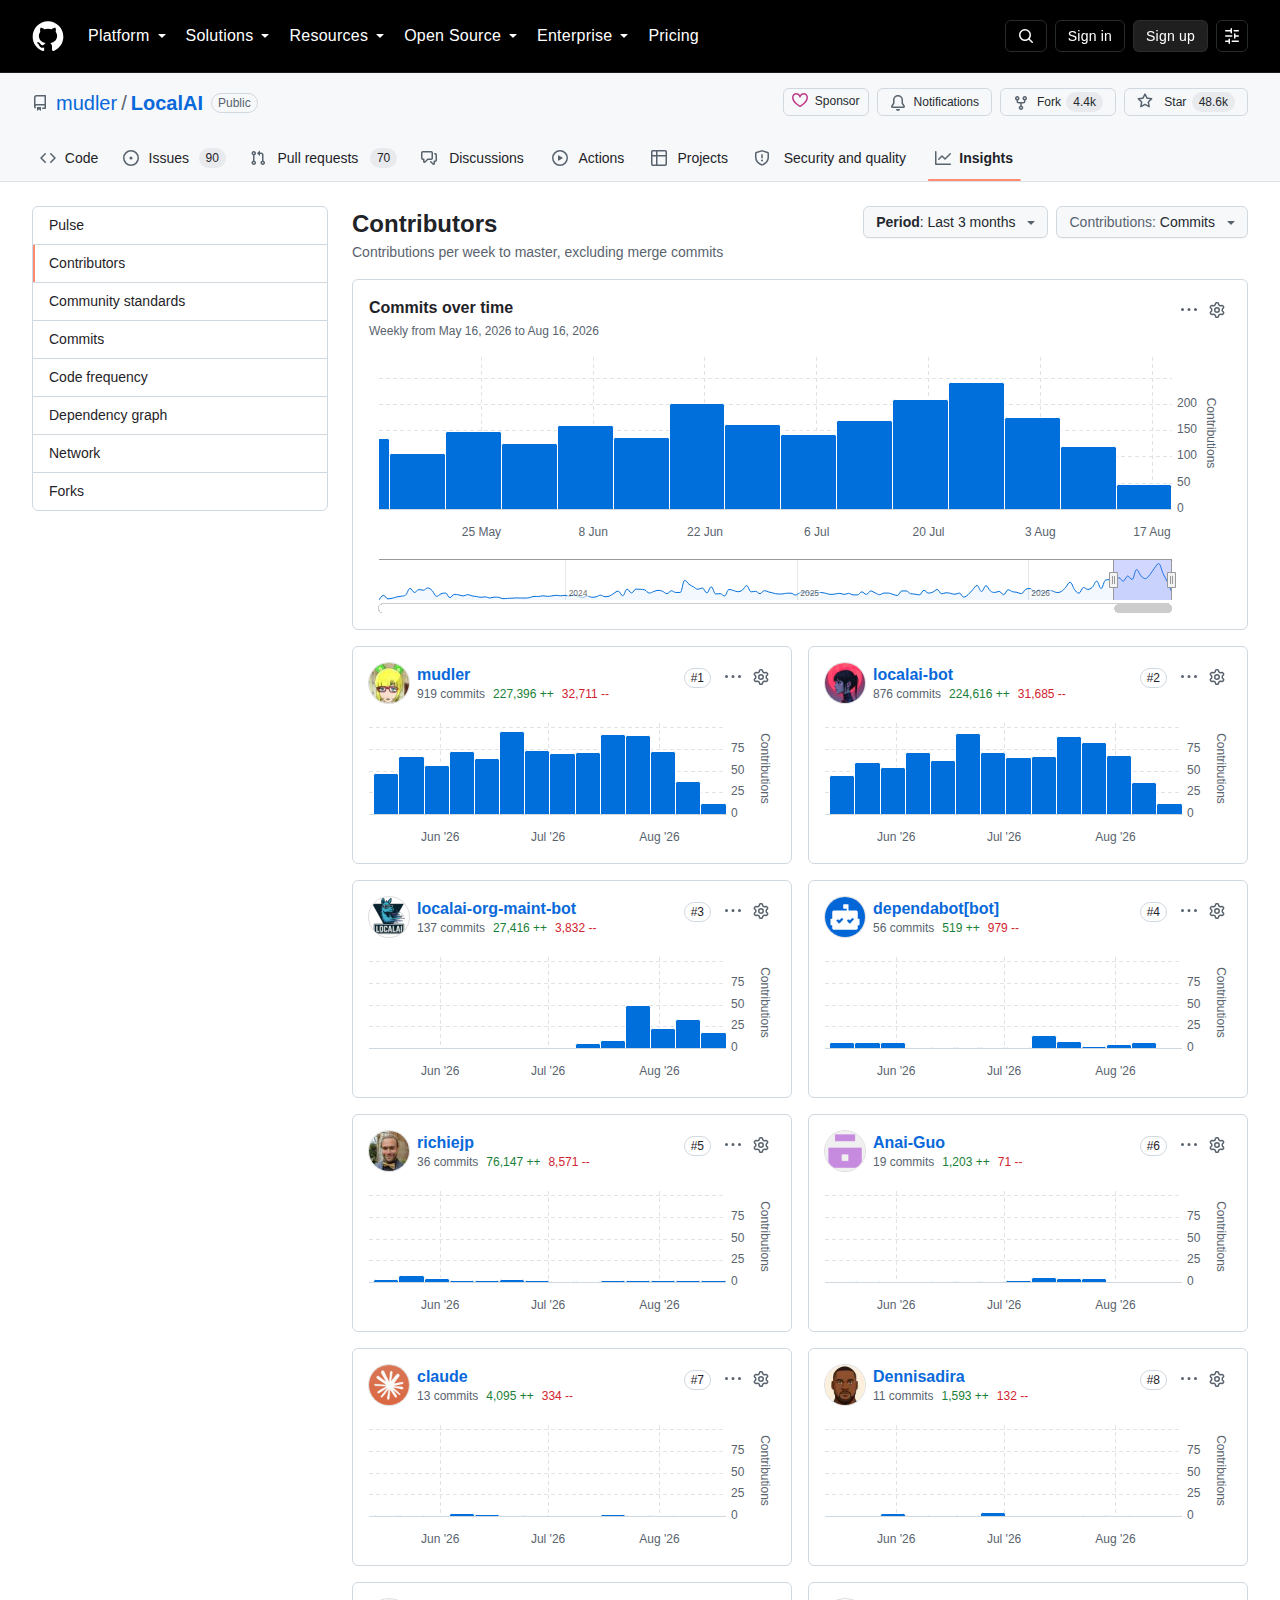
從數據面觀察,LocalAI 以 48,555 顆星標與 4,366 次復刻,穩居本地 AI 引擎項目的一線陣營,其超過 60 個後端與多硬件支援的廣度,在同類開源項目中相當罕見。項目於 2026 年 8 月中旬仍維持活躍提交,且新聞稿顯示 2026 年上半年持續釋出 4.0.0 至 4.3.0 等多個大版本,加入 Agent 編排、分散式叢集、語音辨識、人臉偵測與 Real-time API 等大量新功能,顯示其正從「本地推理工具」快速蛻變為「自管 AI 平台」。
LocalAI 以 4.8 萬星標與 4,366 復刻穩居本地 AI 引擎一線,60+ 後端罕見;2026 上半年連出 4.0-4.3 大版本,正從推理工具蛻變為自管 AI 平台。
如何快速開始使用 LocalAI?
要快速開始使用 LocalAI,最直接的方式是透過容器運行。在裝有 Docker 或 Podman 的機器上用一條 docker run -ti --name local-ai -p 8080:8080 localai/localai:latest 指令即可啟動預設的 CPU 版本;若要使用 GPU 加速,可選擇對應硬件版本的映像,例如 NVIDIA CUDA 13、AMD ROCm(hipblas)、Intel oneAPI 或 Vulkan。macOS 使用者則可直接下載官方 DMG 應用程式。
快速開始以 Docker 一行指令啟動 CPU 版本,GPU 用戶可選對應硬件映像(CUDA 13、ROCm、oneAPI、Vulkan),macOS 可下載官方 DMG;模型則用 local-ai run 載入。
服務啟動後即可用 local-ai run 載入模型,支援從模型廊、Hugging Face、Ollama 或任意 OCI registry 拉取。要與服務互動,可在另一個終端以 local-ai chat --model <名稱> 啟動內建指令行 Agent,它能回答問題、讀取檔案並在變更系統狀態前請求核准。LocalAI 正確偵測 GPU 並下載對應後端後,即完成一個可實際使用的本地 AI 引擎設定,後續應用程式只需將 API 指向其 8080 連接埠。
服務啟動後用 local-ai run 載入模型,並以 local-ai chat 啟動內建 Agent 互動;它自動偵測 GPU 下載後端,應用可將 API 指向 8080 連接埠即可使用。
出處連結有哪些?
本篇文章的資訊來源為 LocalAI 的 GitHub 官方儲存庫,包括 README 說明文件、原始程式碼、Release 新聞與官方文件網站;其中並涵蓋官方對最新功能版本(4.0 至 4.3)的公開說明。有興趣的讀者可以前往 GitHub 查看多模態支援、硬件加速對照與社群討論。
本篇文章資訊來自 LocalAI 官方 GitHub 儲存庫,涵蓋 README、原始碼與 Release 新聞;讀者可前往查看多模態支援、硬件加速對照與社群討論。
常見問題有哪些?
總結:LocalAI 的未來前景如何?
LocalAI 以 48,555 顆星標與 4,366 次復刻,展示了「本地 AI 引擎」從單一推理工具走向完整自管平台的路徑。它以「小核心、非捆綁」的模組化設計、多達 60 個後端與涵蓋 CPU 到各品牌 GPU 的硬件支援,讓在地端運行任意模態模型成為可負擔的工程選項;而 2026 年上半年連續的大版本更新,更把分散式叢集、自主 Agent、人臉與語音辨識等能力整合進同一介面。對於重視資料隱私、希望控制推理成本、或需要整合多種 AI 能力進自家基礎設施的開發者與團隊,LocalAI 提供了一個成熟、開放且持續進化的選擇,其生態後續發展值得密切關注。
LocalAI 以 4.8 萬星標展示本地 AI 引擎從推理工具走向自管平台的成熟路徑,60+ 後端、多硬件支援與連續大版本更新確立其領先地位,適合重視隱私與成本控管的開發者長期採用。