
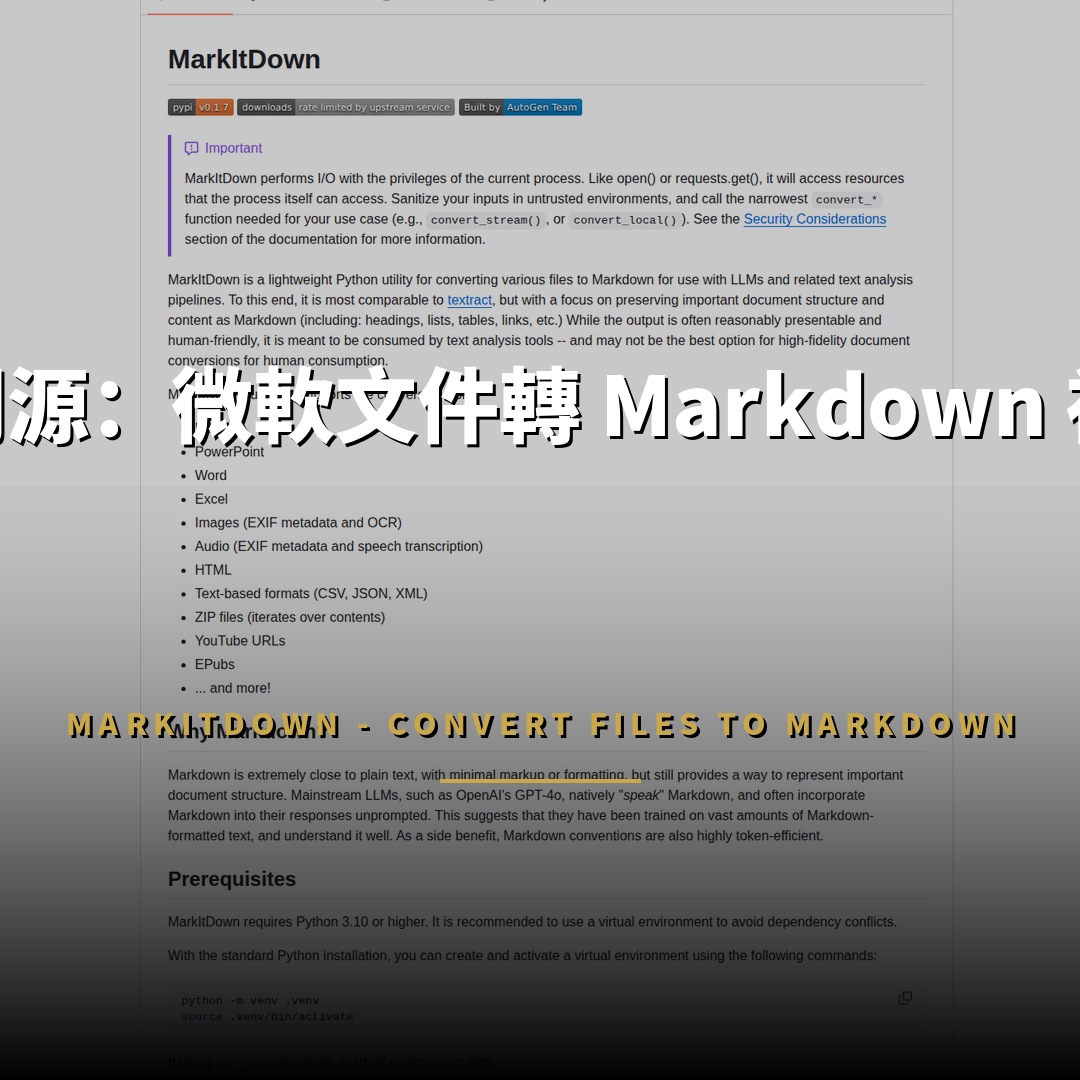
MarkItDown 是微軟 AutoGen 團隊開發並開源的 Python 文件轉換工具,截至 2026 年 9 月初在 GitHub 累積超過 17.8 萬星標,定位是將 PDF、Word、PowerPoint、Excel、影像、音訊等各類檔案轉換為 Markdown 格式,供大型語言模型與文字分析管線使用。該專案自 2024 年 11 月發布以來,憑藉輕量設計與對文件結構的完整保留,迅速成為 AI 資料預處理環節中最受矚目的開源工具之一,官方描述將其視為 textract 的現代化替代方案,但更聚焦於 Markdown 輸出品質與 LLM 可讀性。
MarkItDown 是微軟 AutoGen 團隊開源的輕量工具,將 PDF、Office 檔案、影像與音訊轉為 LLM 友善的 Markdown,累積逾 17.8 萬星標。
MarkItDown 是什麼?
MarkItDown 是由微軟 AutoGen 團隊於 2024 年 11 月建立的開源專案,採用 MIT 授權,其核心目標是解決「非結構化文件進入 AI 管線前的最後一哩路」問題。大型語言模型原生理解 Markdown,且該格式接近純文字、標記極少,token 效率高,因此將文件轉換為 Markdown 成為餵養模型前的重要預處理步驟,MarkItDown 正是為此而生的輕量工具。

與傳統文件解析程式庫不同,MarkItDown 不追求供人類閱讀的高保真轉換,而是以「保留重要文件結構」為優先,包括標題、清單、表格與連結。官方文件明確指出,輸出的 Markdown 主要供文字分析工具消費,這項定位使它與 Docx 解析、PDF 抽取等通用工具形成互補關係,而非競爭。
MarkItDown 由微軟 AutoGen 團隊於 2024 年 11 月發布,MIT 授權,定位為 LLM 與文字分析管線前的文件 Markdown 化預處理工具。
MarkItDown 支援哪些檔案格式轉換?
MarkItDown 內建支援的格式涵蓋辦公室文件與多媒體兩大類。辦公室文件包括 PDF、PowerPoint、Word、Excel(含舊版 XLS),以及 HTML、CSV、JSON、XML 等文字型格式;多媒體方面則支援影像的 EXIF 詮釋資料與 OCR 文字抽取、音訊的詮釋資料與語音轉錄,並可處理 ZIP 壓縮檔內容、YouTube 網址與 ePub 電子書。

在擴充性方面,官方提供以 [all] 一次安裝所有相依元件,或按需安裝 [pdf]、[docx]、[pptx] 等單一格式套件,開發者可依任務規模控制依賴數量。值得注意的是,第三方插件機制讓新格式支援不需修改主儲存庫,插件預設停用,可透過 --use-plugins 參數啟用,並以 #markitdown-plugin 標籤在 GitHub 上搜尋既有插件,例如 markitdown-ocr 插件即可為 PDF 與 Office 文件加入基於 LLM 的 OCR 能力。
內建支援 PDF、Office 四件套、影像 OCR、音訊轉錄、HTML、CSV、JSON、ZIP 與 ePub;第三方插件機制可按需擴充格式,插件預設停用。
MarkItDown 有哪些核心技術亮點?
MarkItDown 的技術亮點體現在三個面向。第一是結構保留能力,轉換過程完整保留標題層級、清單、表格與連結,讓模型可以理解文件組織方式,而非僅取得扁平文字;第二是輕量與低依賴設計,基礎安裝只依賴 Python 3.10 以上版本與少量套件,開發者可依所需格式逐項加入選用相依,避免套件衝突;第三是安全邊界設計,官方文件特別提醒工具會以目前程序權限執行 I/O,並建議在不可信環境中呼叫最窄範圍的轉換方法,例如 convert_local() 或 convert_stream(),而非全功能的 convert()。
在 AI 整合方面,開發者可為影像與簡報提供 llm_client 與 llm_model 參數,讓大型語言模型生成影像描述,例如搭配 OpenAI 用戶端與 GPT-4o 模型,即會以自然語言描述圖片內容並寫入 Markdown。官方亦提供 markitdown-mcp 套件,將轉換能力包裝為 Model Context Protocol 伺服器,讓 Claude 等 AI 代理工具可以透過標準協定直接呼叫文件轉換,進一步融入代理式工作流程。
核心亮點為結構保留、低依賴與安全邊界設計;支援 LLM 生成影像描述,並提供 markitdown-mcp 套件供 AI 代理以標準協定呼叫轉換。
MarkItDown 如何與 Azure 雲端服務整合?
MarkItDown 除了離線轉換外,亦提供兩條 Azure 雲端路徑。第一條是 Azure Document Intelligence,開發者只需設定端點環境變數,即可讓雲端版面分析服務接手 PDF 等文件的抽取,適合掃描文件與複雜表格等本地工具力有未逮的情境;第二條是 Azure Content Understanding,這是較新的多模態分析服務,支援文件、影像、音訊與影片四種媒體,並可透過預建或自訂分析器提取發票金額、收據日期、合約條款等結構化欄位,以 YAML front matter 形式寫入輸出。

兩條路徑的取捨在於成本與能力:Document Intelligence 僅處理文件,Content Understanding 則涵蓋音訊影片並提供欄位抽取,但兩者皆為按次計費的 Azure API 呼叫。官方提供 cu_file_types 參數,讓開發者限制只有 PDF 等特定格式走雲端,其餘維持本地轉換,在成本與品質之間取得平衡。
MarkItDown 可整合 Azure Document Intelligence 做雲端分析,或 Content Understanding 處理音訊影片並抽取結構化欄位。
MarkItDown 在 AI 生態中的定位如何?
MarkItDown 的崛起反映一個明確趨勢:文件預處理已成為 RAG 與 LLM 應用管線中的獨立環節。過往開發者需要自行拼湊 PyPDF、python-docx、openpyxl 等多個程式庫,再手動處理結構遺失問題;MarkItDown 將這些能力收斂為單一 API 與單一輸出格式,大幅降低文件管線的整合成本,因此迅速在開發者社群中累積星標與使用率。
與 Azure 自家生態的連結亦強化了其商業化路徑。作為 AutoGen 團隊的專案,它自然融入微軟的 AI 代理與雲端服務體系;同時其 MIT 授權與雲端服務僅為選用整合的設計,確保了開源社群與企業用戶都可以自由採用。這種「核心開源、雲端選配」的策略,與許多現代開源 AI 工具的商業模式一致,也解釋了為何大型科技公司願意主導此類基礎工具。
MarkItDown 將文件預處理收斂為單一 API 與單一輸出格式,配合 MIT 授權與 Azure 選配整合,確立其 AI 資料管線標準層定位。
MarkItDown 有哪些快速上手方式?
最快的途徑是透過 pip 安裝:執行 pip install 'markitdown[all]' 後,命令列一行指令即可完成轉換,例如 markitdown path-to-file.pdf > document.md,亦可使用 -o 指定輸出檔,或利用標準輸入輸出進行管線串接。對於需要程式化控制的開發者,Python API 只需建立 MarkItDown() 實例並呼叫 convert() 方法,即可取得包含 Markdown 文字的結果物件。
在部署方面,專案提供 Docker 映像建置方式,可將工具包裝為容器服務,適合 CI/CD 管線或伺服器端批次轉換。整體而言,從一行指令到容器化部署皆有對應途徑,學習曲線相對平緩,一般開發者可在數分鐘內完成首次轉換。
安裝只需一行 pip 指令,命令列即可將檔案轉為 Markdown;Python API 提供 MarkItDown 類別呼叫 convert 方法,並支援 Docker 部署。
出處連結有哪些?
本文資訊整理自 microsoft/markitdown 的 GitHub 儲存庫、README 文件與 Azure 文件 AI 官方文件,來源連結列於下方,供讀者進一步查閱原始資料與版本歷史。
本文資訊整理自 microsoft/markitdown 的 GitHub 儲存庫與 README,以及 Azure 文件 AI 官方說明。
- GitHub 儲存庫:https://github.com/microsoft/markitdown
- Azure Content Understanding:https://learn.microsoft.com/azure/ai-services/content-understanding/
總結:MarkItDown 適合什麼團隊?
MarkItDown 適合所有需要將大量 Office 文件、PDF 或多媒體檔案餵入大型語言模型、RAG 系統或資料分析管線的團隊。對個人開發者而言,一行命令即可完成轉換,無需自行拼湊多個解析程式庫;對企業用戶而言,Docker 部署、Azure 雲端整合與結構化欄位抽取提供了向上擴展的空間,而 MIT 授權確保了商用零障礙。
MarkItDown 適合需要將大量文件轉為 LLM 可讀格式的個人與企業團隊,具備一行指令、Docker 部署與 Azure 雲端整合的完整擴展路徑。