
Milvus 是一個高性能、雲原生的開源向量資料庫,由 Zilliz 主導開發並隸屬於 LF AI & Data Foundation,GitHub 上累積 45.7k 星標。它專門用於組織與搜尋文字、圖像、多模態資料等非結構化數據的向量表示,是檢索增強生成(RAG)、語義搜尋與推薦系統等 AI 應用的核心基礎設施。該項目以 Go 與 C++ 撰寫,實現 CPU/GPU 硬件加速,可水平擴展至數十億向量規模,並以 Apache 2.0 許可證分發。
Milvus 是由 Zilliz 主導、隸屬 LF AI & Data Foundation 的開源向量資料庫,GitHub 獲 45.7k 星標。它以 Go 與 C++ 撰寫,支援 CPU/GPU 硬件加速與多種向量索引,可水平擴展至數十億向量規模,是 RAG、語義搜尋與推薦系統的核心基礎設施,採用 Apache 2.0 許可證。
Milvus 是什麼?
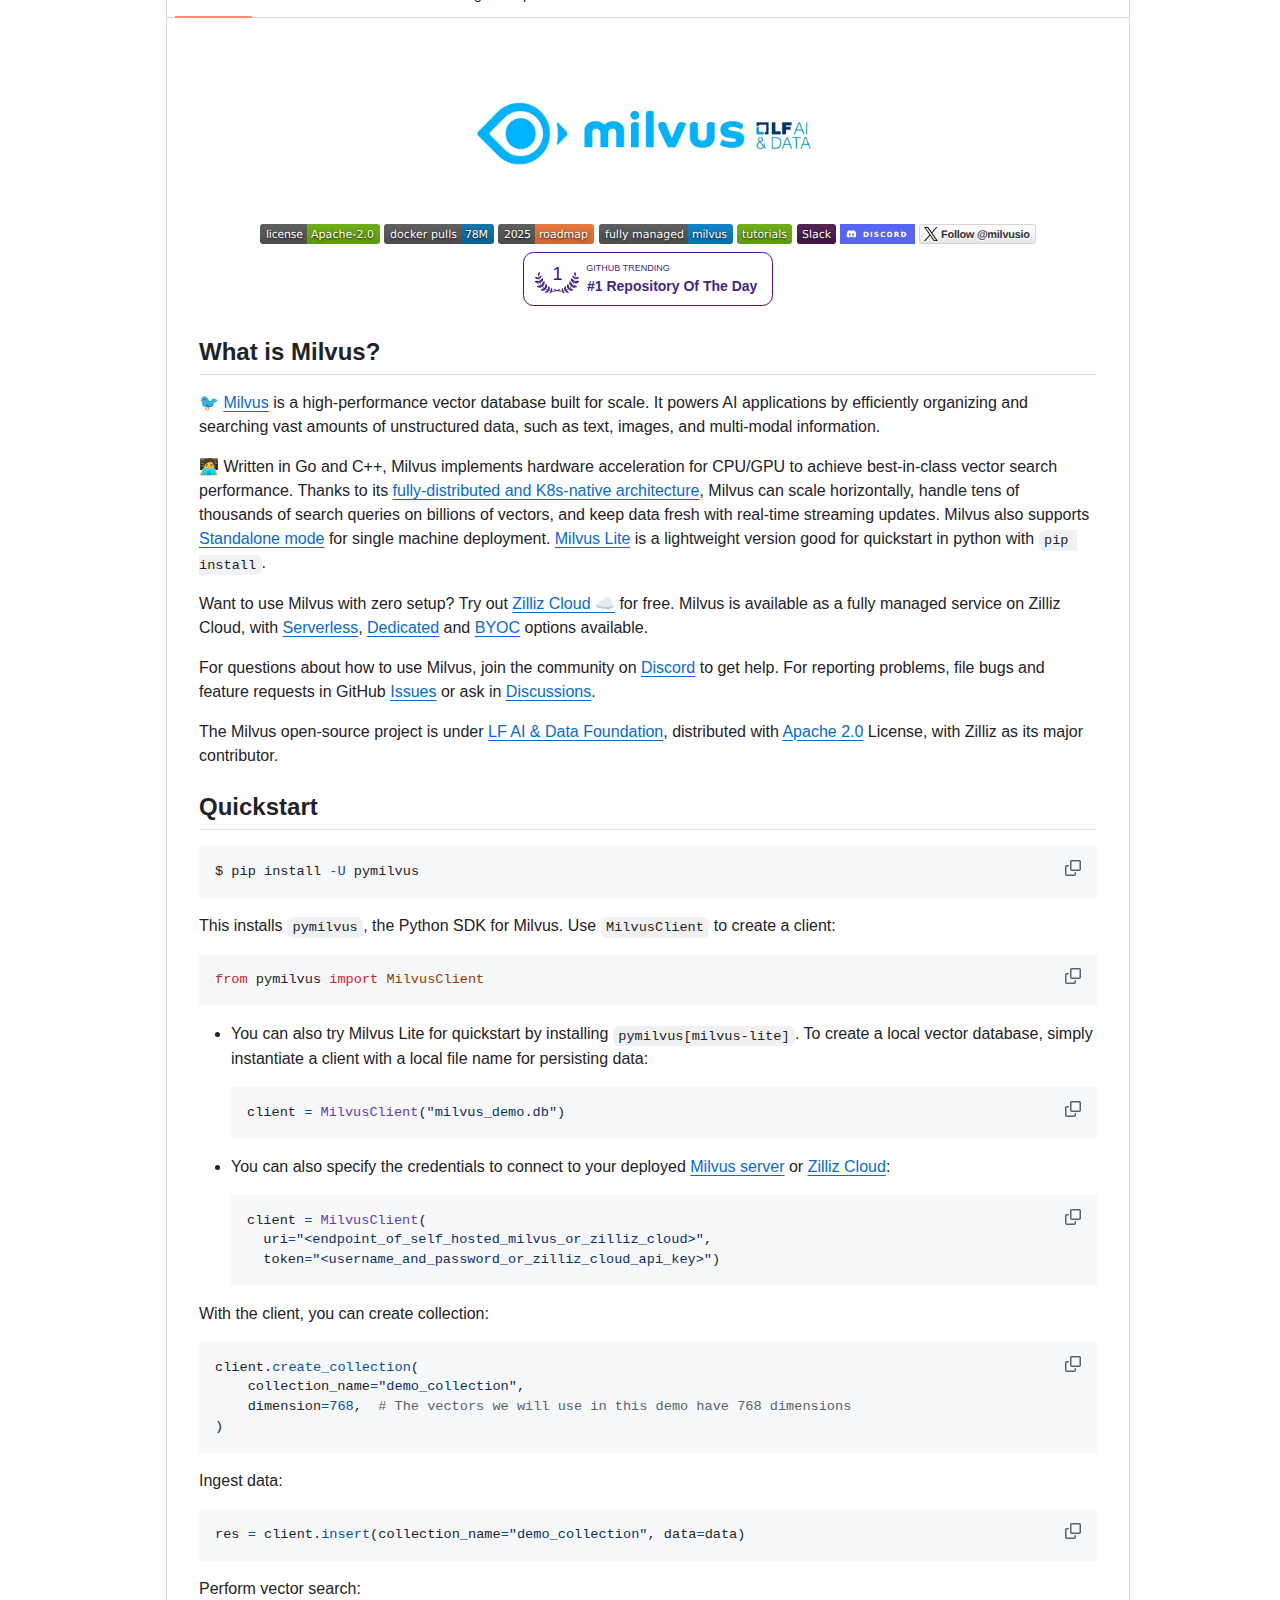
Milvus 是一個專為規模化向量搜尋而設計的高性能資料庫,核心任務是儲存向量——即非結構化數據的學習表示——並與整數、字串、JSON 等標量資料一同管理,讓開發者可以在同一套系統中進行向量搜尋、元數據過濾與混合檢索。其架構將計算與儲存分離,採用 Kubernetes 原生微服務設計,既能以 Standalone 模式部署於單機,也能透過 Milvus Lite 以 pip install 快速在 Python 環境中建立本地向量資料庫。
Milvus 是專為規模化向量搜尋設計的高性能資料庫,儲存向量並與標量資料一同管理,支援向量搜尋、元數據過濾與混合檢索。架構將計算與儲存分離,Kubernetes 原生微服務設計支援水平擴展,並提供 Milvus Lite 輕量版本方便快速入門。
Milvus 有哪些核心技術亮點?
Milvus 的技術優勢體現在三個面向。首先是性能與可用性:分散式架構分離計算與儲存,查詢節點與資料節點可以獨立擴展,讀取密集與寫入密集的工作負載各自優化,無狀態的 Kubernetes 微服務讓故障恢復迅速,副本機制則將資料段載入多個查詢節點,提升容錯能力與吞吐量。其次是索引與硬件加速:系統將核心向量搜尋引擎獨立出來,支援 HNSW、IVF、FLAT、SCANN 與 DiskANN 等主流索引類型,並提供量化變體與 mmap 優化,同時支援 NVIDIA CAGRA 等 GPU 索引,配合元數據過濾與範圍搜尋等進階功能。
第三個亮點是儲存與租戶彈性:Milvus 支援資料庫、集合、分割區或分割區鍵層級的多租戶隔離,單一叢集可服務數百至數百萬租戶;熱/冷儲存機制將頻繁存取的熱資料置於記憶體或 SSD,冷資料則存放於較慢但成本更低的儲存,在維持關鍵任務性能的同時顯著降低營運成本。此外,Milvus 原生支援以 BM25 為基礎的全文搜尋與 SPLADE、BGE-M3 等學習型稀疏嵌入,允許稠密向量與稀疏向量共存於同一集合,並透過函式對多路檢索結果進行重新排序,實現語義搜尋與全文搜尋的混合檢索。
Milvus 的技術亮點包括:分離計算與儲存的分散式架構,查詢與資料節點可獨立擴展;支援 HNSW、IVF、FLAT、SCANN、DiskANN 等多種索引並提供 GPU 加速;多租戶隔離與熱/冷儲存降低成本;原生支援 BM25 全文搜尋與 SPLADE 等稀疏嵌入,實現稠密與稀疏向量混合檢索。
Milvus 如何支撐 RAG 應用?
在檢索增強生成架構中,向量資料庫負責儲存知識庫文件的嵌入向量,並在用戶查詢時快速回傳最相關的內容片段,供大型語言模型生成回答。Milvus 提供的混合檢索能力讓 RAG 系統可以同時進行語義比對與關鍵字比對,避免純語義檢索在專業術語或精確詞彙場景下的遺漏。其官方教學涵蓋基礎 RAG、進階 RAG 優化、全文檢索混合、多模態搜尋與 Graph RAG 等完整路徑。
在 RAG 架構中,Milvus 儲存知識庫文件的嵌入向量並快速回傳相關片段供 LLM 生成回答。其混合檢索能力讓系統同時進行語義比對與 BM25 關鍵字比對,避免專業術語遺漏,官方提供從基礎 RAG 到 Graph RAG 的完整教學路徑。
Milvus 在向量資料庫市場的定位如何?
Milvus 屬於最早規模化的開源向量資料庫之一,項目始於 2019 年,至今累積超過四千個 fork,並由商業公司 Zilliz 提供 Zilliz Cloud 全託管服務,涵蓋 Serverless、Dedicated 與 BYOC(Bring Your Own Cloud)等部署選項。在開源生態中,Milvus 與 Qdrant、Weaviate 等項目同屬主流選擇,其差異化在於 Kubernetes 原生架構、GPU 索引支援與背後完整的商業化支撐;作為 LF AI & Data Foundation 的孵化項目,其治理模式亦適合企業長期採用。
Milvus 是最早規模化的開源向量資料庫之一,始於 2019 年,累積逾四千個 fork。Zilliz 提供 Serverless、Dedicated 與 BYOC 全託管服務,其差異化在於 Kubernetes 原生架構、GPU 索引與 LF AI & Data Foundation 治理模式,適合企業長期採用。
Milvus 的數據表現如何?
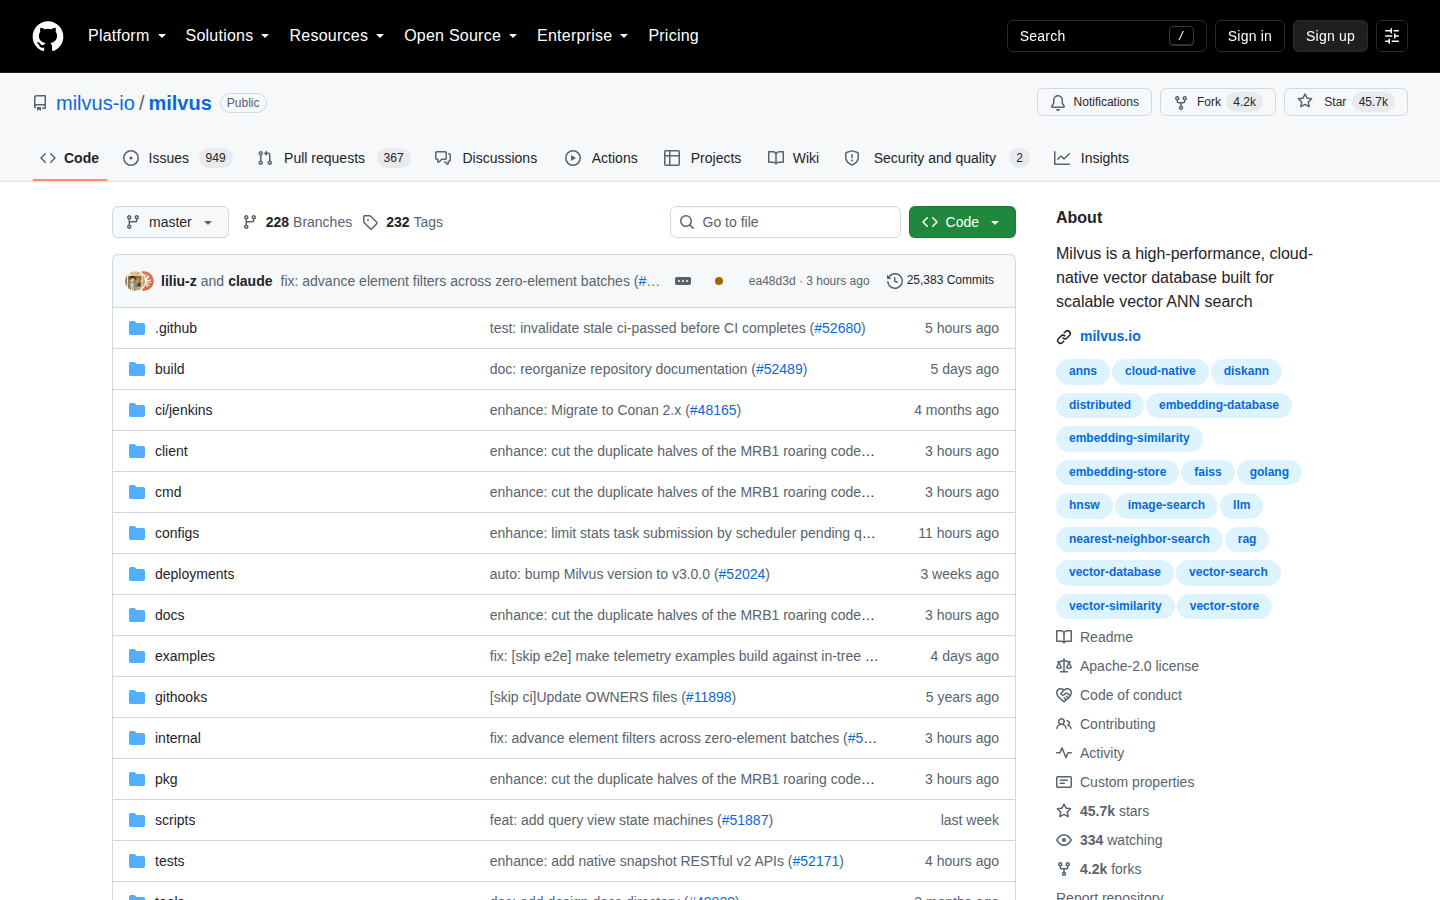
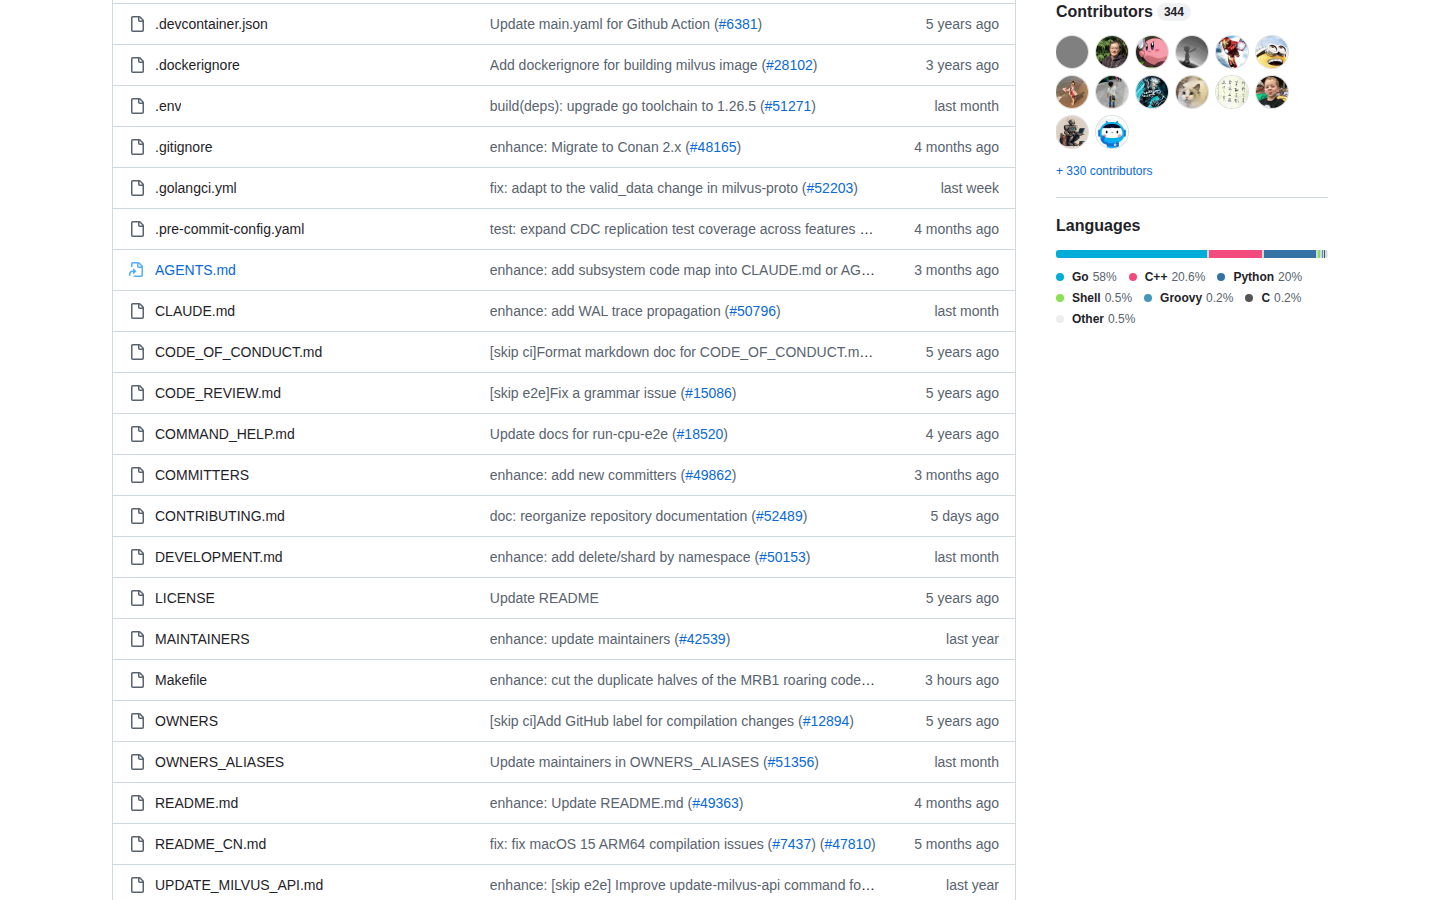
Milvus 的開發活躍度維持在高位,專案持續更新,最近一次代碼提交於 2026 年 8 月 20 日。其 Docker 映像下載量與社群規模反映廣泛的生產環境採用,官方社群提供 Slack 與 Discord 渠道,並有 344 位貢獻者參與開發。
Milvus 在 GitHub 累積 45.7k 星標與逾 4.2k fork,以 Go 與 C++ 撰寫,採用 Apache 2.0 許可證。項目創立於 2019 年,隸屬 LF AI & Data Foundation,持續活躍更新,擁有 344 位貢獻者與龐大的生產環境採用基礎。
出處連結有哪些?
本文資訊來源為 Milvus 的 GitHub 儲存庫,完整代碼、文件與教學資源可於官方儲存庫查看:milvus-io/milvus。官方網站 milvus.io 提供架構說明、安裝指南與各類應用教學,Zilliz Cloud 則提供免設定的全託管體驗。
本文資訊來源為 milvus-io/milvus 的 GitHub 儲存庫,包含完整代碼、架構文件與教學資源。官方網站 milvus.io 提供安裝指南與應用教學,Zilliz Cloud 提供 Serverless 全託管服務,均可作為進一步參考。
常見問題有哪些?
Milvus 與傳統資料庫有什麼分別?
傳統關聯式資料庫以精確比對為核心,適合結構化資料的查詢與交易;Milvus 則以近似最近鄰搜尋為核心,專門處理文字、圖像等非結構化數據的向量表示,並同時支援標量過濾與混合檢索,兩者定位互補而非取代。
Milvus 需要什麼硬件才能運行?
Milvus 可以單機部署於 Docker 環境,Milvus Lite 更可透過 pip 安裝於一般開發機;若要發揮完整規模化能力,建議使用 Kubernetes 叢集與 NVIDIA GPU 以啟用硬件加速索引。
Milvus 是免費的嗎?
Milvus 以 Apache 2.0 許可證開源,可以免費使用與商業部署;Zilliz Cloud 提供額外的全託管服務選項,讓團隊不需自行維運基礎設施。
總結:如何開始使用 Milvus?
開始使用 Milvus 的最快途徑是安裝 PyMilvus Python SDK,透過 MilvusClient 建立連線並創建集合,即可完成向量插入與搜尋;需要本機快速體驗時,可安裝 Milvus Lite 直接以本地檔案建立向量資料庫。對於追求規模化的團隊,Kubernetes 部署配合 Zilliz Cloud 託管服務是進入生產環境的務實路徑。
開始使用 Milvus 可先安裝 PyMilvus SDK,透過 MilvusClient 建立連線、創建集合並進行向量搜尋;本機快速體驗可用 Milvus Lite 以本地檔案建立向量資料庫,追求規模化的團隊則以 Kubernetes 部署或 Zilliz Cloud 託管服務進入生產環境。