
MinerU 是 GitHub 上星標超過 77,636 顆的開源高精度文檔解析引擎,由 OpenDataLab 開發,可將 PDF、圖片、DOCX、PPTX 與 XLSX 等複雜文檔轉化為 LLM 可直接讀取的 Markdown 與 JSON 格式,支援 109 種語言的 OCR 辨識,採用 VLM 與 OCR 雙引擎架構,在 OmniDocBench v1.6 基準測試中取得 95.39 分的端到端準確度,是當前 RAG 與 AI 代理工作流中最受矚目的文檔資料基礎設施項目之一。
MinerU 是 GitHub 星標逾 7.7 萬的開源高精度文檔解析引擎,將 PDF、DOCX、PPTX、XLSX 與圖片轉化為 LLM 可直接讀取的 Markdown 與 JSON,支援 109 種語言 OCR,在 OmniDocBench v1.6 基準中取得 95.39 分。
MinerU 是什麼?它為何能吸引逾 7.7 萬星標?
MinerU 的定位是「LLM 時代的文檔解析基礎設施」。該項目誕生於 InternLM 大模型預訓練過程,開發團隊在處理科學文獻時遇到符號轉換難題,因而聚焦於解決複雜文檔的結構化解析問題。與傳統 PDF 轉換工具不同,MinerU 不僅輸出純文字,而是保留文件的閱讀順序、標題層級、列表結構、表格 HTML 格式與公式 LaTeX 格式,直接產出可供檢索、萃取與餵入大模型的機器可讀內容。
MinerU 是為 LLM 與 RAG 工作流設計的文檔解析引擎,誕生於 InternLM 預訓練過程,輸出保留閱讀順序與結構的 Markdown/JSON,包括表格 HTML 與公式 LaTeX,定位為文檔資料基礎設施。
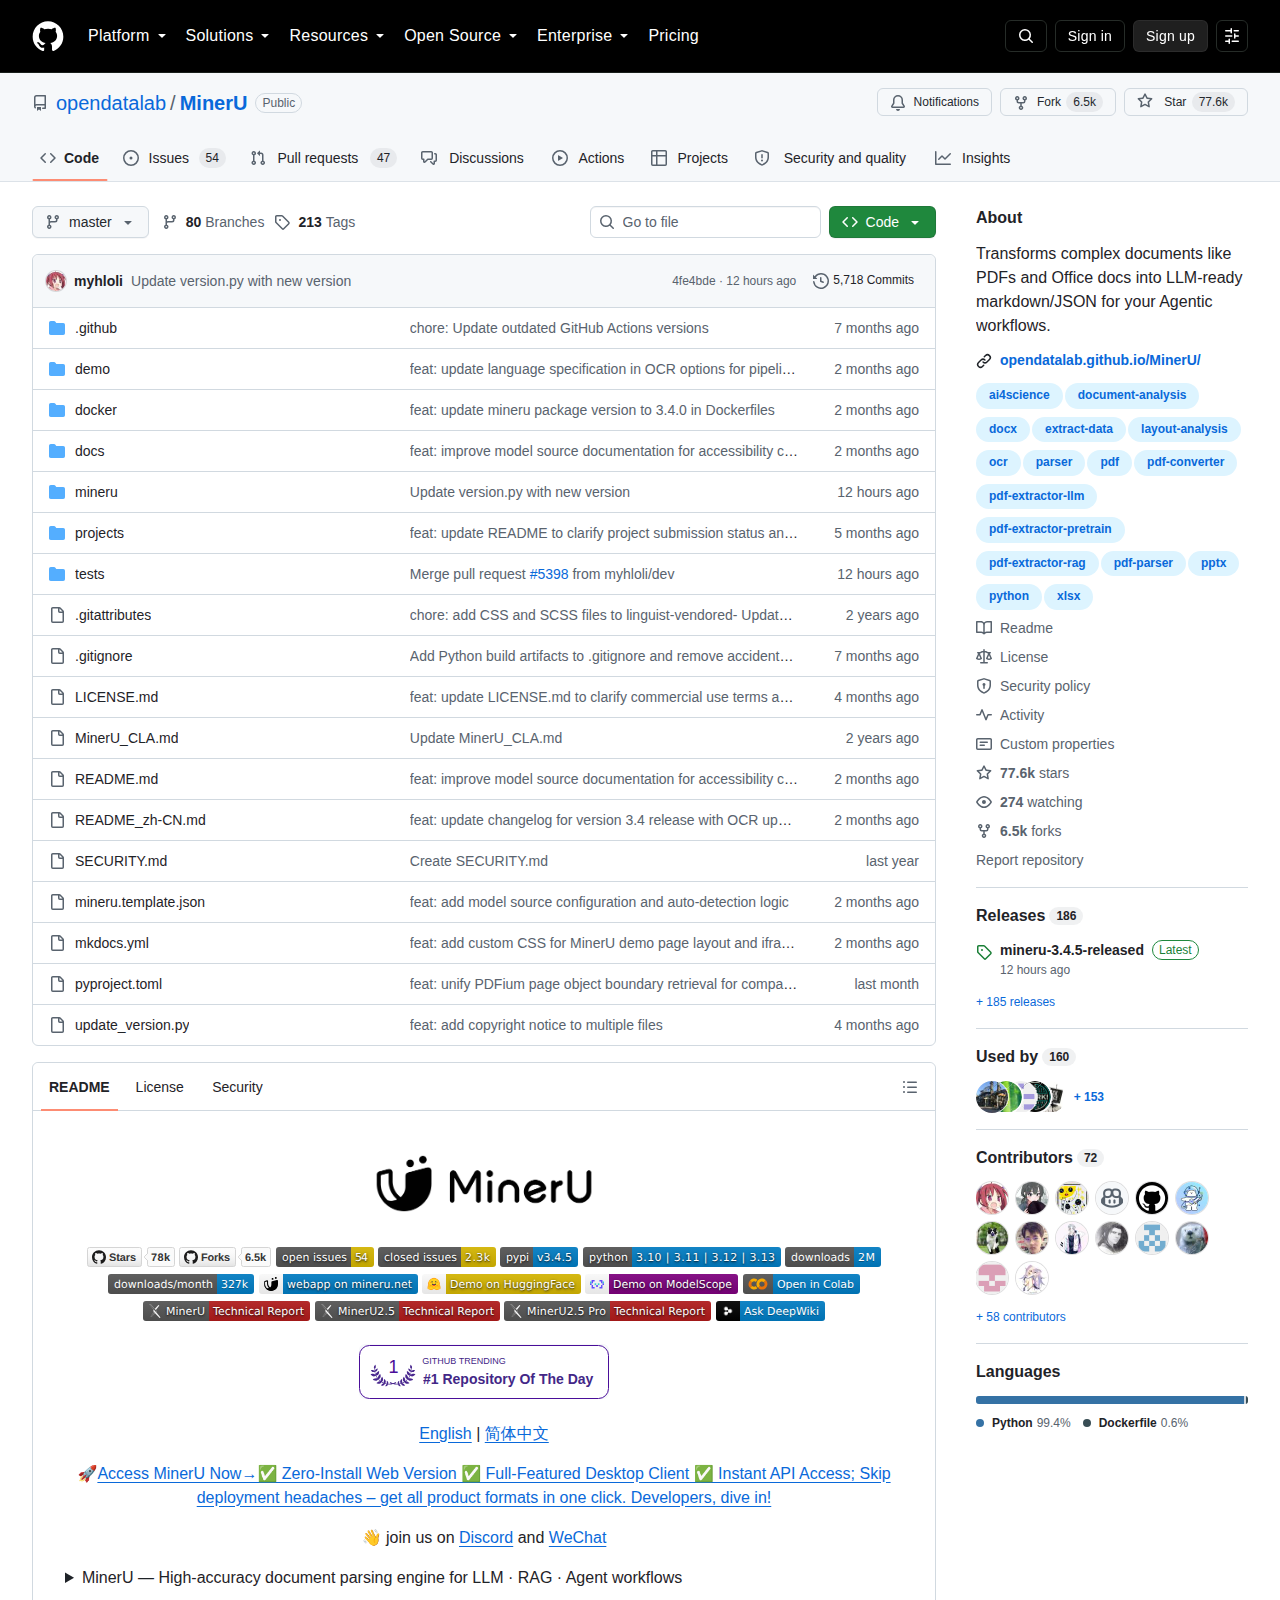
項目自 2024 年 2 月創建以來,星標數量快速增長至逾 7.7 萬,復刻數超過 6,500 次,關鍵驅動力在於它解決了 AI 應用落地的真實痛點:企業文件多為掃描檔、多欄排版與複雜表格,傳統解析方式常出現內容錯亂與資訊遺失,導致 RAG 檢索品質低落。MinerU 透過自動偵測掃描 PDF 並啟用 OCR、去除頁首頁尾與頁碼、合併跨頁表格等機制,將解析品質提升至可直接用於生產的層級,因此迅速獲得開發者社群與企業用戶的採用。
星標快速增長的關鍵在於解決 AI 落地痛點:自動偵測掃描 PDF 啟用 OCR、去除頁首頁尾、合併跨頁表格,將解析品質提升至可直接用於生產的層級,滿足企業文件結構化需求。
MinerU 的核心技術亮點有哪些?
MinerU 的技術架構以 VLM 與 OCR 雙引擎為核心。VLM 引擎(視覺語言模型)負責理解複雜版面與圖文混排內容,OCR 引擎則負責文字偵測與辨識,兩者協同運作,官方宣稱支援 109 種語言的文字辨識,涵蓋掃描文件、手寫內容、多欄版面與跨頁表格合併等場景。輸出格式支援多模態 Markdown、NLP Markdown、依閱讀順序排序的 JSON 以及豐富的中間格式,並提供版面視覺化與 Span 視覺化工具,方便使用者快速確認解析品質。
核心亮點是 VLM 與 OCR 雙引擎架構,支援 109 種語言辨識,輸出多模態 Markdown、NLP Markdown 與依閱讀順序排序的 JSON,並提供版面視覺化工具確認解析品質。
在文件格式覆蓋方面,MinerU 已實現 PDF、圖片、DOCX、PPTX 與 XLSX 的原生解析。其中 DOCX 原生解析於 3.0.0 版本推出,相較傳統「先轉 PDF 再解析」的工作流,端到端速度提升數十倍;PPTX 與 XLSX 支援則於 3.1.0 版本加入,使項目完成主流辦公文件格式的全覆蓋。表格與公式的處理能力是另一項技術重點,系統可將表格自動轉化為 HTML、將公式自動轉化為 LaTeX,並支援表格內圖片與公式的辨識,這對學術文獻與財務報告等場景尤為關鍵。
MinerU 已原生支援 PDF、圖片、DOCX、PPTX 與 XLSX 五種格式,DOCX 原生解析速度較傳統流程提升數十倍,表格自動轉 HTML、公式自動轉 LaTeX,覆蓋主流辦公文件格式。
MinerU 如何將複雜文檔轉化為 LLM 就緒的 Markdown?
MinerU 的解析流程強調「保留結構」而非「抽取文字」。系統會先進行版面分析,辨識標題、段落、列表、表格、圖片與公式等元素,再依人類閱讀順序重組輸出,同時自動移除頁首、頁尾、頁碼與註腳,確保語意連貫。針對掃描 PDF 與亂碼 PDF,系統會自動偵測並啟用 OCR 功能,讓老舊紙本文件也能轉化為結構化資料。
解析流程先進行版面分析,依人類閱讀順序重組輸出,自動移除頁首頁尾與頁碼,針對掃描與亂碼 PDF 自動啟用 OCR,確保輸出內容語意連貫且結構完整。
在長文件處理上,3.0.0 版本引入滑動窗口機制,顯著降低長文檔解析的峰值記憶體佔用,數萬頁的巨型文件不再需要手動拆分;批次推論支援串流寫入磁碟,長時間任務的解析結果可即時落盤。3.1.0 版本進一步加入截斷段落合併、跨頁表格合併與表格內圖片辨識能力,並強化圖表解析,使複雜文件佈局下的輸出品質達到新的水準。
滑動窗口機制降低長文檔峰值記憶體,數萬頁文件無需手動拆分;批次推論支援串流寫入磁碟,並具備截斷段落合併與跨頁表格合併能力。
MinerU 3.4 版本帶來了哪些升級?
MinerU 3.4 於 2026 年 6 月發布,核心升級聚焦於 OCR 能力與模型下載體驗。pipeline 後端的 OCR 模型升級至 PP-OCRv6,在 OmniDocBench v1.6 基準中 OCR 準確度提升約 11%;OCR 推論與處理管線經優化後,處理速度提升約 100%,大幅改善批次文件與 OCR 密集型文件的解析效率。模型下載方面,系統新增自動選擇模型來源機制,並優先檢查本地模型快取,避免重複下載,使首次安裝與多環境部署更加穩定。
MinerU 3.4 將 OCR 模型升級至 PP-OCRv6,準確度提升約 11%、處理速度提升約 100%,並加入自動模型來源選擇與本地快取機制,改善首次安裝與多環境部署體驗。
此前的 3.3 版本則專注於 Hybrid 後端的效能平衡,新增 effort 解析強度參數,提供 medium 與 high 兩級選擇。在 OmniDocBench v1.6 基準中,medium 級別相較 high 僅降低 0.13 分,但解析速度在不同平台提升 35% 至 220%,其中 macOS 的文字 PDF 場景提升約 220%;該版本同時將 VLM 模型升級至 MinerU2.5-Pro-2605-1.2B,加入原生多語言 OCR 支援。3.1.0 版本則完成了授權的重大變革,從 AGPLv3 改為基於 Apache 2.0 的 MinerU Open Source License,大幅降低商業部署的採用門檻。
3.3 版本新增 effort 解析強度參數,medium 級別速度提升 35% 至 220% 而準確度僅降 0.13 分;3.1.0 版本將授權改為基於 Apache 2.0 的 MinerU Open Source License,降低商業採用門檻。
MinerU 如何部署並整合至 RAG 工作流?
MinerU 提供多層次的部署選項,涵蓋 CLI、FastAPI、Gradio WebUI 與 Docker,並支援純 CPU 環境運行,亦支援 GPU 與 Apple Silicon 加速,最低僅需 4GB 顯示記憶體即可運行 pipeline 後端。對於大規模場景,項目提供 mineru-router 統一入口,可跨多個服務與多張 GPU 進行任務路由與自動負載平衡,實現一鍵多 GPU 部署,滿足高併發、高吞吐的企業級需求。
部署選項涵蓋 CLI、FastAPI、Gradio WebUI 與 Docker,支援純 CPU 運行與 GPU/MPS 加速,pipeline 後端最低僅需 4GB 顯示記憶體,並提供 mineru-router 實現多 GPU 任務路由。
在生態整合方面,MinerU 提供 MCP Server,可接入 Cursor、Claude Desktop 與 Windsurf 等 AI 程式設計工具;同時提供 LangChain、LlamaIndex、RAGFlow、Flowise、Dify 與 FastGPT 等主流 RAG 框架的原生整合,並支援 Python、Go 與 TypeScript 三種語言的 SDK、CLI、REST API 與 Docker 部署。項目亦相容超過 10 款國產 AI 晶片,包括昇騰、寒武紀、燧原、摩爾執行緒、崑崙芯等,顯示其在中國市場的在地化部署優勢。
MinerU 提供 MCP Server 接入 Cursor 與 Claude Desktop,原生整合 LangChain、Dify、RAGFlow 等主流框架,支援三種語言 SDK,並相容超過 10 款國產 AI 晶片。
MinerU 與其他文檔解析工具相比有何優勢?
在文檔解析市場中,MinerU 的核心競爭力來自「高準確度」與「低資源需求」的組合。pipeline 後端以 86.47 分的 OmniDocBench 成績支援純 CPU 環境運行,適合資源受限的部署場景;Hybrid 與 VLM 後端則以 95.39 分提供最高解析品質,開發者可依硬體條件與精度需求選擇後端,這種彈性架構在同類工具中較為少見。相較以雲端 API 為主的商業方案,MinerU 的開源屬性允許企業完全私有化部署,文件資料無需離開本地環境,這對金融、法律與政府機構等高度重視資料隱私的產業尤其重要。
MinerU 以高準確度與低資源需求的組合取勝,pipeline 後端支援純 CPU 運行、VLM 後端提供最高精度,開源屬性允許完全私有化部署,滿足資料隱私敏感的產業需求。
在商業化路徑上,OpenDataLab 提供 mineru.net 線上服務、桌面用戶端與 API 存取,形成「開源核心引擎+商業雲端服務」的雙軌模式。這種模式既維持開源社群的活躍度,又為企業用戶提供免部署的即用方案,與其他開源解析工具的單一模式形成差異化。項目的授權變更(由 AGPLv3 改為基於 Apache 2.0 的自訂授權)亦被視為擴大商業採用的策略性調整,顯示開發團隊正積極推動項目從開發者工具走向企業基礎設施。
商業化採用「開源核心引擎+商業雲端服務」雙軌模式,mineru.net 提供免部署即用方案,授權由 AGPLv3 改為基於 Apache 2.0 的自訂授權,推動企業採用。
常見問題有哪些?
MinerU 支援 PDF、圖片、DOCX、PPTX 與 XLSX 五種格式,可在純 CPU 環境運行,最低僅需 4GB 顯示記憶體,並提供 CLI、Docker、WebUI 與雲端服務多種使用方式。
MinerU 支援哪些文件格式? 項目原生支援 PDF、圖片、DOCX、PPTX 與 XLSX 五種輸入格式,輸出為 Markdown 與 JSON,並提供多模態 Markdown、NLP Markdown 與依閱讀順序排序的 JSON 等選擇。
MinerU 需要什麼硬件配置? pipeline 後端最低僅需 4GB 顯示記憶體,並支援純 CPU 環境運行;VLM 後端建議 8GB 以上顯示記憶體。系統相容 Windows、Linux 與 macOS 平台,macOS 需 14.0 或以上版本。
MinerU 如何與 RAG 框架整合? 項目原生支援 LangChain、LlamaIndex、RAGFlow、Flowise、Dify 與 FastGPT 等主流框架,並提供 MCP Server 供 Cursor、Claude Desktop 等 AI 工具接入。
MinerU 的授權是否允許商業使用? 自 3.1.0 版本起,項目使用基於 Apache 2.0 的 MinerU Open Source License,相較先前的 AGPLv3 大幅降低商業部署門檻,詳細條款可參考項目的 LICENSE 文件。
總結:MinerU 值得一試嗎?
MinerU 以其逾 7.7 萬星標的社群規模、95.39 分的基準測試成績與完整的格式覆蓋,確立了其在開源文檔解析領域的領先地位。項目的核心價值在於將「複雜文檔結構化」這一 AI 落地的隱性瓶頸,轉化為一鍵可用的標準化流程,無論是個人開發者建立本地 RAG 知識庫,還是企業構建大規模文檔處理管線,都能在統一的架構下獲得穩定輸出。
MinerU 以 7.7 萬星標、95.39 分基準成績與完整格式覆蓋確立領先地位,將複雜文檔結構化轉化為一鍵可用的標準化流程,個人與企業均適合採用。
從生態發展趨勢觀察,MinerU 正從單一的資料生產工具演進為大型文檔解析基礎設施,多 GPU 部署、MCP 生態整合與國產晶片相容等能力,使其在 Agentic 工作流普及的背景下具備顯著的成長空間。對於需要高品質文檔解析的團隊,該項目值得納入技術評估清單。
MinerU 正從資料生產工具演進為文檔解析基礎設施,多 GPU 部署與 MCP 生態整合使其在 Agentic 工作流普及背景下具備顯著成長空間,值得納入技術評估。
出處連結有哪些?
本文資訊整理自 MinerU 官方 GitHub 專案,包含 README 文件、版本更新記錄與 OmniDocBench 基準測試數據,讀者可直接前往項目頁面查看完整文件與原始碼。