
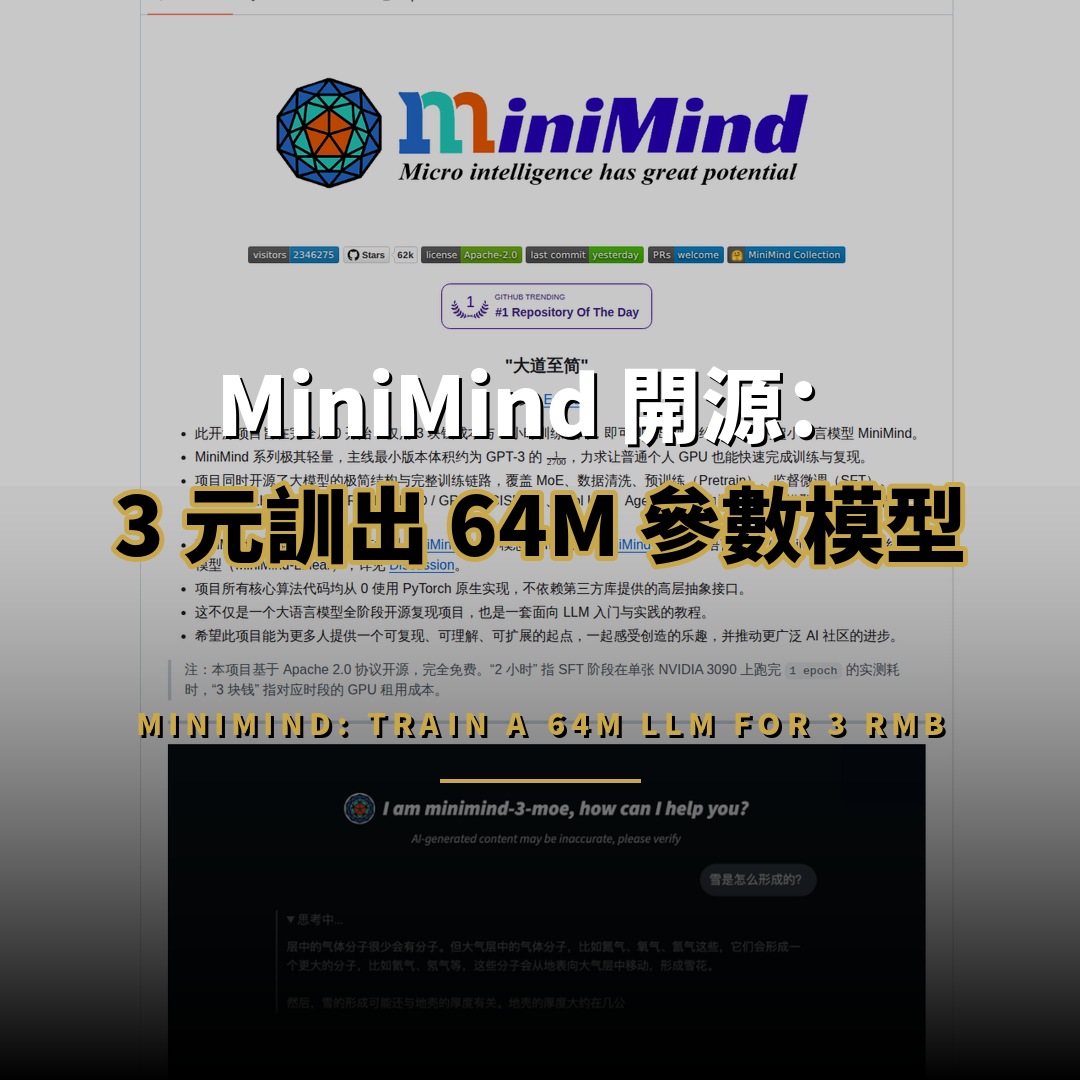
MiniMind 是 2024 年 7 月開源的大型語言模型訓練專案,在 GitHub 累積 62,267 顆星標與 8,096 個分支。專案由開發者 jingyaogong 建立,主張以約人民幣 3 元的算力成本、在單張 RTX 3090 上花費約兩小時,從零訓練出一個約 64M 參數的語言模型。當主流模型的訓練預算以百萬美元計算、參數規模動輒數百億時,這組數字構成明確的新聞錨點,也解釋了它為何在兩年間持續吸引關注。
MiniMind 是從零實作的開源訓練專案,主線模型約 64M 參數。官方估算單張 RTX 3090 訓練兩階段約 2.3 小時、成本約人民幣 3 元,權重與資料集全部開源。
MiniMind 是什麼?
MiniMind 是強調可複現的開源語言模型專案,涵蓋 Dense 與 MoE 結構,以及從預訓練到強化學習的完整鏈路。核心算法以 PyTorch 原生實作,兼任入門教程。
專案自我定位為「大道至簡」。README 說明其目標是讓普通個人顯示卡也能快速完成訓練與複現,因此刻意把模型縮到極小規模,主線最小版本體積約為 GPT-3 的二千七百分之一。整個倉庫同時是一套教材,除了可執行的程式碼之外,還附上各階段的原理說明、loss 曲線與實驗對比,試圖把語言模型從黑盒還原成可逐行理解的實作。
它與常見的微調方案有明顯分野。多數開發者的入門路徑是以 LoRA 等方式調整既有大模型,理解的是接口而非機制;MiniMind 則要求使用者親手跑完預訓練、微調與後訓練各階段,藉此看清參數如何從隨機初始化逐步形成語言能力。
MiniMind 的項目背景與開發者是誰?
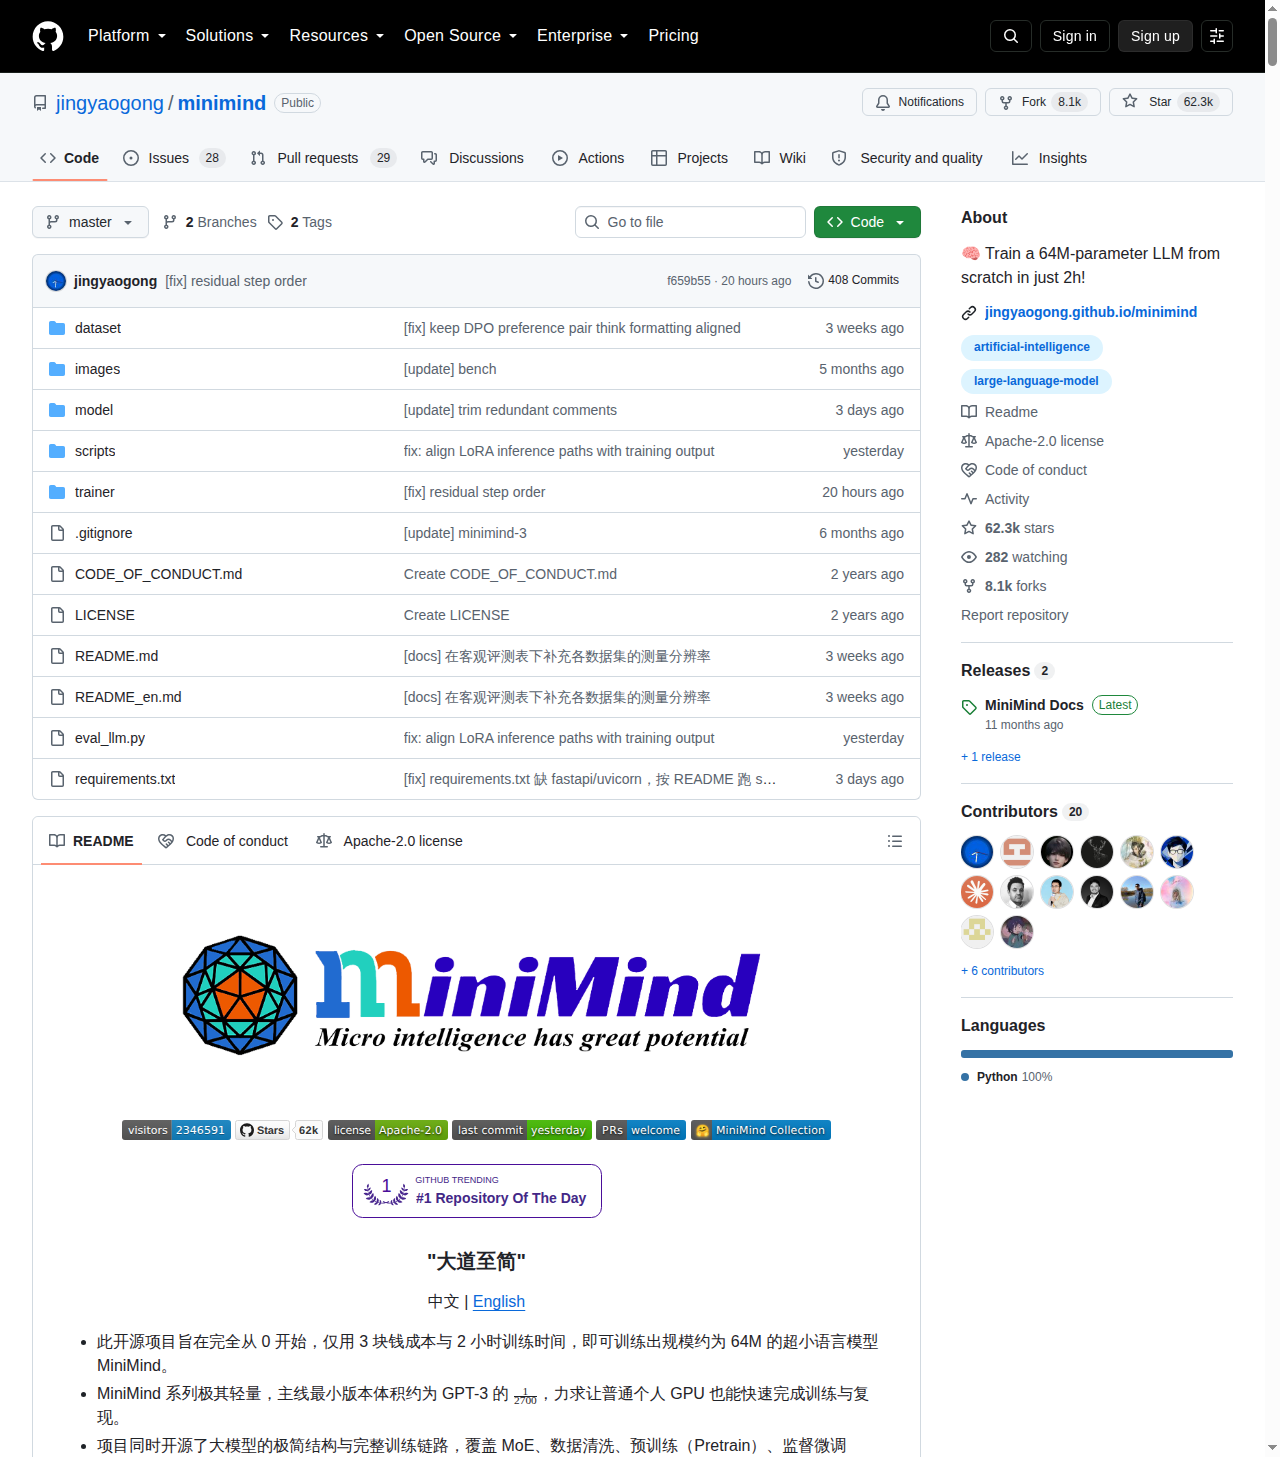
專案於 2024 年 7 月建立,由開發者 jingyaogong 主導,累積 408 次提交與 19 位貢獻者。程式碼以 Apache-2.0 授權釋出,另設獨立文件站。
倉庫建立於 2024 年 7 月 27 日,最初目標是提供一套完全從零開始的語言模型訓練實作。開發者 jingyaogong 在 README 中直言,市面上大量付費課程以漏洞百出的講解包裝 AI 教學,與其停在推理層面調用現成框架,不如降低門檻讓學習者親手訓練一個極小的模型。
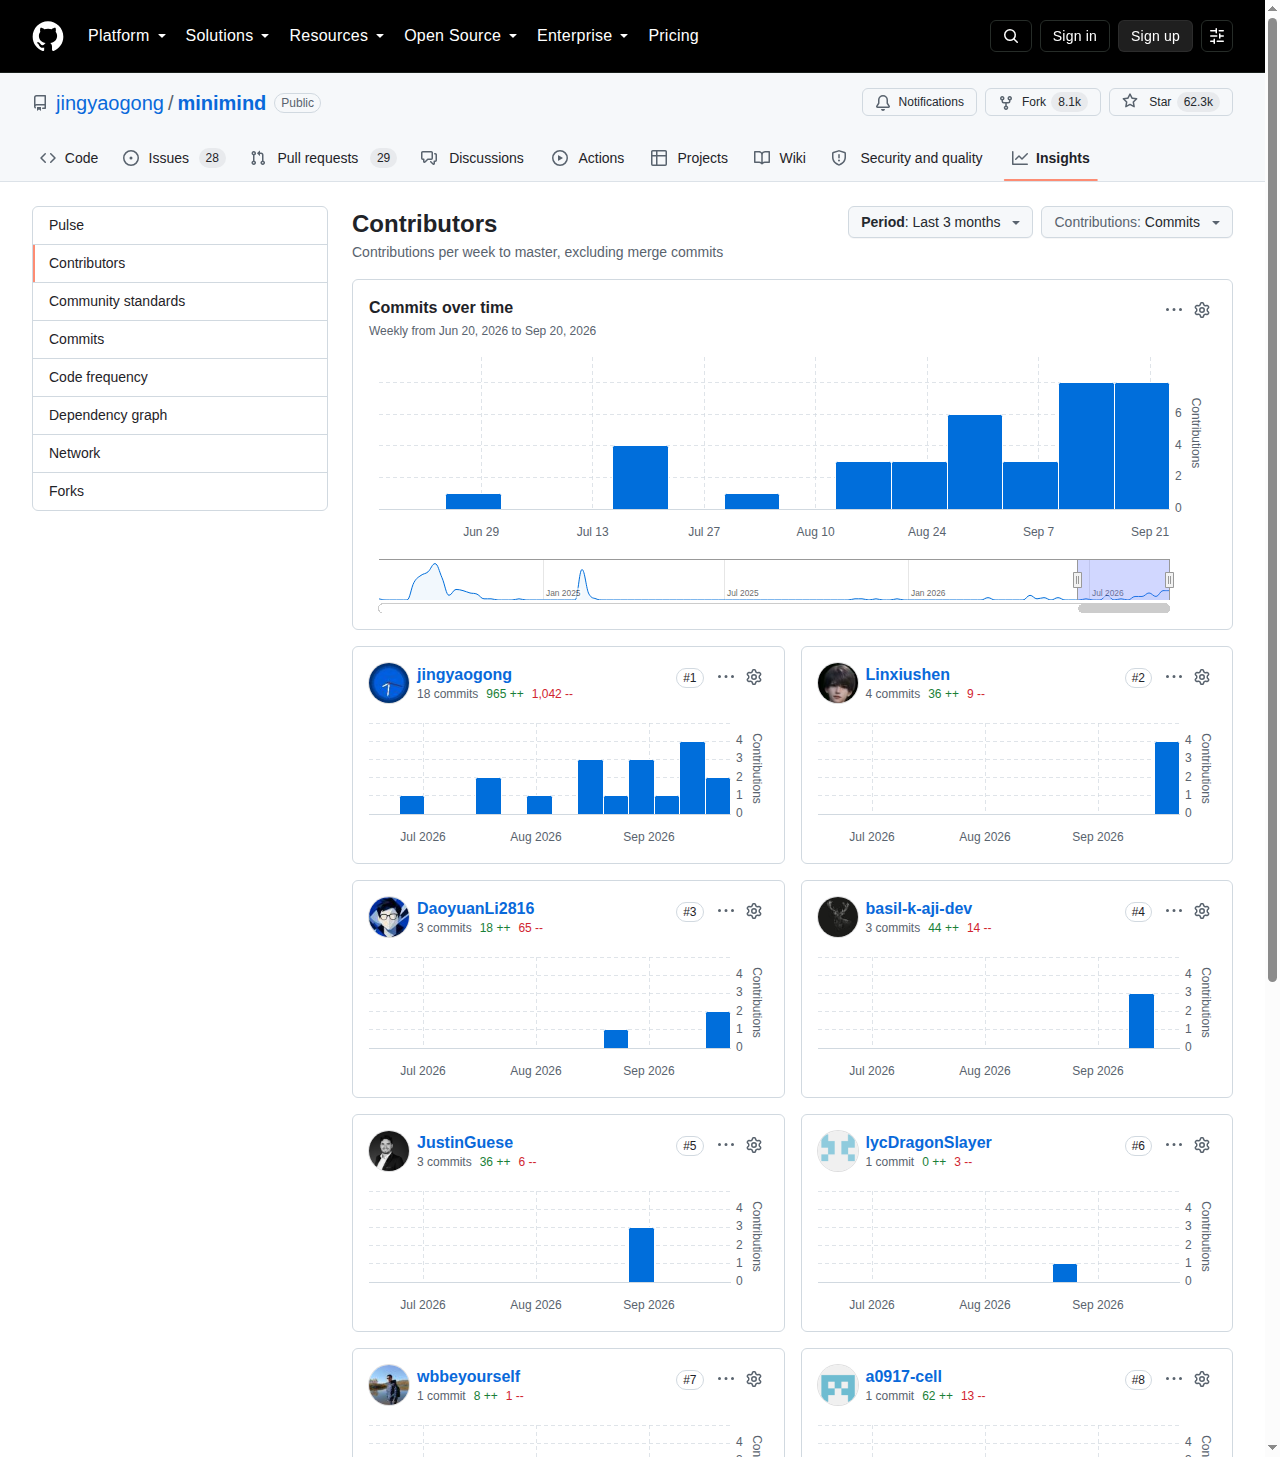
貢獻結構相當集中。倉庫累積 408 次提交,其中主導開發者貢獻 215 次,其餘由 18 位開發者分攤,多數為單次修補、翻譯或文件補充,顯示這是一個由個人驅動、社群輔助的專案。授權採用 Apache-2.0,條款寬鬆,允許商業使用與修改,對教學用途尤其友善。專案另設有獨立文件站,把訓練原理與實作細節整理成可閱讀的教材。
MiniMind 的架構有什麼特點?
主線採 Decoder-Only Transformer,對齊 Qwen3 生態:Pre-Norm、RMSNorm、SwiGLU 與 RoPE,並支援 YaRN 外推。
結構設計刻意向主流生態靠攏。Dense 版本使用預標準化加 RMSNorm、SwiGLU 激活函數與 RoPE 旋轉位置編碼,並透過 YaRN 演算法實現長文本外推,最大位置編碼長度為 32768,rope_theta 設為 1e6。這種配置與 Qwen3 系列對齊,使模型權重可直接轉換至 transformers、llama.cpp、ollama 與 vllm 等生態。
MoE 版本在相同骨架上擴展專家前饋層,默認採用四個專家與 top-1 路由,並移除了共享專家設計。README 特別指出一個反直覺現象:專家數量繼續增加後,實際訓練耗時往往遠高於同尺寸的稠密模型,原因是原生訓練時詞元需先按專家分桶再分別前向,核心算子啟停與調度開銷急劇增加。專案選擇保留原生 PyTorch 的普適性,並以四個專家作為折衷甜點,耗時約比稠密模型多五成。
MiniMind 如何做到 3 元訓練成本?
關鍵在模型規模與資料精簡。主線僅 64M 參數、8 層結構,官方另提供輕量資料集,並以 3090 租卡約每小時 1.3 元計算,預訓練與微調合計約 2.31 小時、約 3 元。
成本數字的推導來自三項前提。首先是模型規模,主線選擇 d_model 為 768、n_layers 為 8,屬於淺層窄身配置,訓練所需的計算量遠低於百億級模型。其次是資料集,官方提供 pretrain_t2t_mini 與 sft_t2t_mini 兩個輕量版本,讓使用者不必先處理十 GB 級語料。第三是租卡單價,README 以每小時約 1.3 元人民幣估算,據此得出預訓練約 1.21 小時、監督微調約 1.10 小時,合計 2.31 小時、成本約 3 元。
README 也說明兩小時的具體含義,指的是監督微調階段在單張 3090 上跑完一個訓練週期的實測耗時,而 3 元對應的是該時段的 GPU 租用成本。專案強調這並非行銷話術,並保留一段早期 Zero 模型的對話樣本,顯示該版本已具備基礎對話能力,但事實知識與泛化效果仍相當有限,適合作為訓練可行性的參考。
MiniMind 支援哪些訓練流程?
涵蓋預訓練、監督微調、LoRA、知識蒸餾、DPO,以及 PPO、GRPO、CISPO 等 RLAIF 演算法,並新增 Agentic RL 與工具調用訓練。
訓練鏈路的完整度是這個專案的主要賣點。從最基礎的預訓練與全參數監督微調,到 LoRA 低秩微調、白盒知識蒸餾、DPO 偏好學習,再到 PPO、GRPO 與 CISPO 等強化學習演算法,專案都提供可執行的腳本,且關鍵算法不依賴 peft、trl 等高層封裝,而是以原生 PyTorch 重寫。
2026 年 4 月的更新把訓練目標進一步擴展到代理場景。倉庫新增代理訓練腳本,支援多輪工具使用情境下的 GRPO 與 CISPO 訓練,並將工具調用樣本混入監督微調主線資料,使默認權重即具備基礎工具調用能力。專案同時終結了過去獨立維護推理模型的做法,改由對話模板配合思考標籤與思考開關,在推理時動態切換是否輸出顯式思考過程。
MiniMind 的模型規模與配置如何?
主線 minimind-3 為 64M 參數,MoE 版本為 198M 總參數、64M 激活,採四個專家與 top-1 路由。詞表 6400,最大位置長度 32768,兩者皆 8 層。
當前主線的 minimind-3 與 minimind-3-moe 於 2026 年 4 月 1 日發布,結構、分詞器、訓練鏈路與推理接口同步重寫。兩者皆採 8 層、d_model 768、kv_heads 4、q_heads 8 的配置,差別在於 MoE 版本以四個專家擴展容量,總參數提升至 198M,但每次前向僅激活約 64M,用以在相近計算量下換取更高模型容量。詞表由自建 BPE 加 ByteLevel 分詞器訓練,大小為 6400,並為工具調用與思考標記預留緩衝詞元。
配置取捨背後有明確依據。README 引用 MobileLLM 的研究指出,在參數量固定時深度往往比寬度更重要,深而窄的結構更容易學到抽象概念。因此主線選擇較淺的 8 層,同時把 d_model 維持在 768,避免維度過窄導致的模式崩潰,在訓練效率、穩定性與最終效果之間取得平衡。
MiniMind 如何部署與整合第三方框架?
安裝依賴並下載 ModelScope 或 HuggingFace 權重後,可用命令列推理,亦支援 Streamlit 網頁介面與 ollama、vllm 等推理引擎。
上手流程僅需兩個步驟。使用者先複製倉庫並安裝依賴,再從 ModelScope 或 HuggingFace 取得模型權重,即可透過命令列腳本直接對話;若需要圖形介面,專案提供基於 Streamlit 的極簡聊天網頁,支援思考過程展示、工具選擇與多輪工具調用。
生態兼容性是另一項設計重點。倉庫明確支援 llama.cpp、vllm 與 ollama 等推理引擎,也兼容 Llama-Factory 等訓練框架,並提供一個遵循 OpenAI API 協議的極簡服務端,可接入 FastGPT、Open-WebUI 等第三方聊天介面。訓練層面則同時支援單卡與單機多卡,提供分散式資料平行與 DeepSpeed 選項,並內建檢查點續訓機制,支援跨不同 GPU 數量恢復進度。
MiniMind 的數據表現如何?
倉庫累積 62,267 顆星標、8,096 個分支,共 408 次提交與 19 位貢獻者,開放問題 57 項,以 Python 撰寫並採 Apache-2.0 授權。
這組數據反映的是一個參與度極高的教學型專案。八比一的星標分支比例高於一般文件類倉庫,說明相當比例的使用者願意複製程式碼並實際動手修改,而非僅收藏備查。倉庫體積約三十九 MB,程式碼行數集中,符合其極簡定位;主要語言為 Python,無其他語言夾雜,依賴結構相對單純。
提交量與貢獻者數量的對比也值得注意。408 次提交由 19 位貢獻者分攤,主導開發者佔比超過一半,代表專案方向由單一維護者掌握,社群主要提供修補與翻譯。開放問題僅 57 項,對一個持續更新兩年的專案而言屬偏低水位。最後一次提交與本文取材同日,顯示維護節奏仍然活躍。
出處連結有哪些?
本文資訊整理自 jingyaogong/minimind 的官方 GitHub 儲存庫及其文件站,數據取自 GitHub API 公開端點,時間為 2026 年 9 月下旬。
本文所有結構描述、訓練流程與統計數據均取自 MiniMind 官方 GitHub 儲存庫,包括 README 的架構說明、模型配置表、訓練開銷估算、數據集清單與更新日誌,以及官方文件站 jingyaogong.github.io/minimind 的原理教學內容。星標、分支、提交、貢獻者與開放問題數據引自 GitHub API 公開端點,截至 2026 年 9 月下旬。
常見問題有哪些?
以下整理三個關於 MiniMind 的常見疑問,涵蓋硬件門檻、訓練成果的實際能力,以及與微調既有大模型方案之間的差異。