
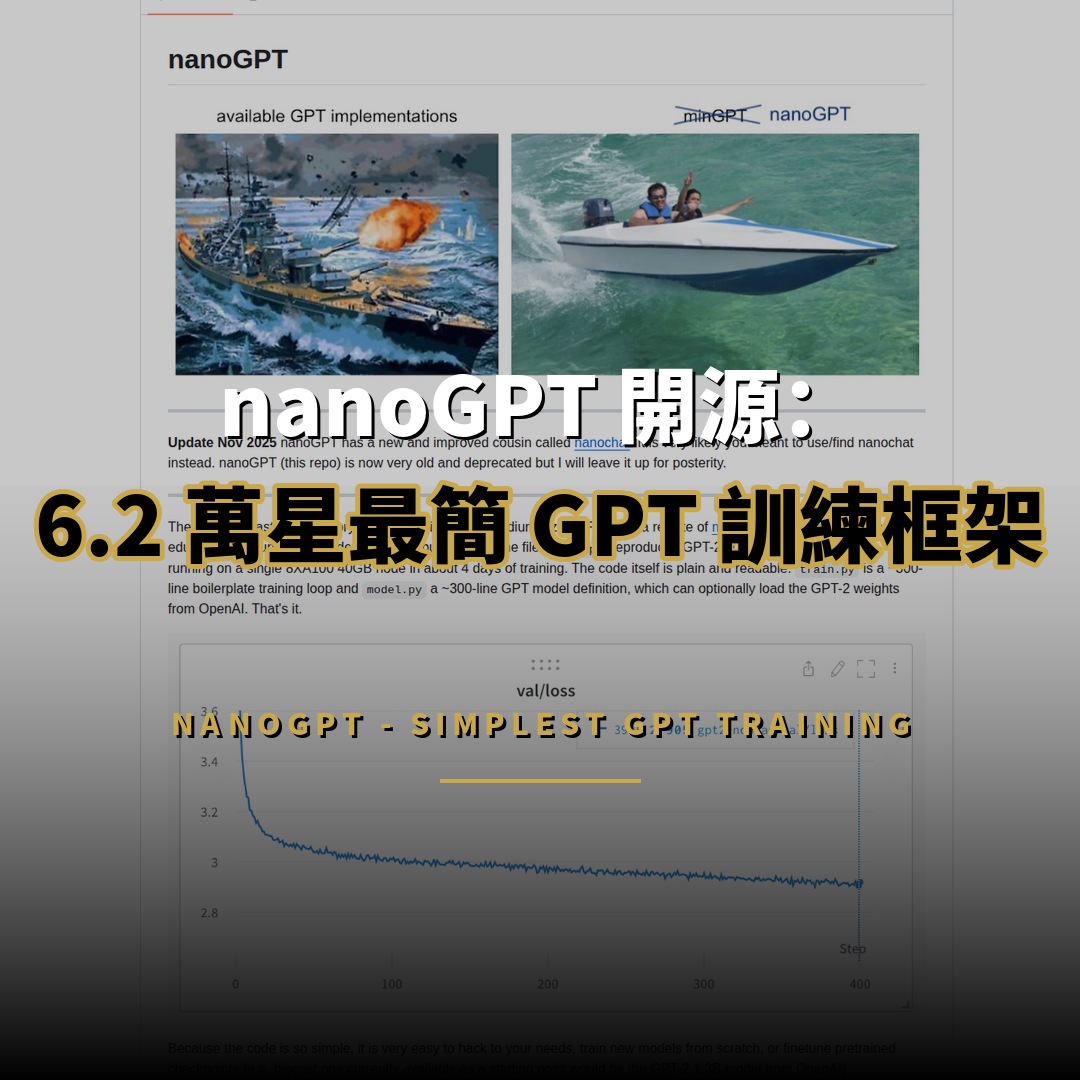
開源 GPT 訓練框架 nanoGPT 在 GitHub 上已累積 6.2 萬星標與 1.08 萬次 fork,是 Andrej Karpathy 以「極簡」與「可讀」為核心設計理念打造的教學級項目。該項目僅依靠約 300 行的 train.py 與約 300 行的 model.py,即可在單一節點 8 張 A100 顯示卡上以四天時間重現 GPT-2(1.24 億參數)在 OpenWebText 資料集上的訓練結果,被廣泛視為理解 GPT 內部運作的最佳入門原始碼。
nanoGPT 是由 Andrej Karpathy 開發的開源 GPT 訓練框架,在 GitHub 獲得 6.2 萬星標。它以約 300 行的訓練迴圈與模型定義程式碼,在 8 張 A100 上四天內重現 GPT-2 的訓練結果,以極簡設計著稱,是學習 GPT 原理的經典教材。
nanoGPT 是什麼?
nanoGPT 是一個用於訓練與微調中型 GPT 模型的開源儲存庫,由 OpenAI 前研究科學家 Andrej Karpathy 於 2022 年 12 月發布,是早期 minGPT 項目的重寫版本。該項目的定位從「教育優先」轉向「實用與可讀並重」,在保留教學價值的同時,讓開發者可以直接在真實硬體上重現 GPT-2 的訓練流程。
項目採用 MIT 授權完全開源,主要開發語言為 Python,依賴 PyTorch、NumPy、Hugging Face Transformers 等生態元件。其核心設計哲學是將複雜的 Transformer 架構濃縮為可逐行閱讀的簡潔程式碼,讓開發者不需要穿越大量抽象層,就能理解語言模型從資料預處理、模型定義到訓練迴圈與採樣推論的完整流程。
nanoGPT 是 Karpathy 於 2022 年末發布的開源 GPT 訓練框架,以 MIT 授權發布,是 minGPT 的重寫版本。它將 Transformer 訓練濃縮為約 600 行可讀程式碼,支援從零訓練與使用 OpenAI GPT-2 權重初始化微調,是教學與研究皆宜的極簡實作。
nanoGPT 為什麼被稱為「最簡 GPT 訓練框架」?
nanoGPT 的簡潔來自對程式碼結構的刻意壓縮。train.py 是約 300 行的標準訓練迴圈,涵蓋資料載入、損失計算、反向傳播、學習率排程與檢查點儲存;model.py 則是約 300 行的 GPT 模型定義,包含多頭注意力、位置編碼、層歸一化與殘差連接等核心元件。兩份檔案合計約 600 行,即可完成 GPT 的完整訓練與推論。
這種「少即是多」的設計帶來兩個直接優勢。其一,學習者可以逐行追蹤資料在模型中的流動,理解注意力機制與訓練動態,而不會被工程架構干擾;其二,程式碼極易修改,開發者可以快速實驗不同的模型大小、上下文長度與超參數組合,無論是訓練全新模型或微調既有 GPT-2 檢查點,都只需調整設定檔即可完成。
nanoGPT 以約 300 行的訓練迴圈與約 300 行的模型定義構成完整 GPT 訓練流程,無複雜抽象層。這種極簡結構讓學習者能逐行理解 Transformer 運作,同時便於快速修改實驗,因此在教育與研究社群廣受推崇,成為「最簡 GPT 訓練框架」的代表。
nanoGPT 與 nanochat 有什麼關係?
根據 README 在 2025 年 11 月的更新,nanoGPT 的開發重心已轉移至其新一代專案 nanochat,nanoGPT 本身則進入維護狀態並保留供參考。nanochat 繼承了 nanoGPT 的極簡哲學並擴展至對話式模型應用,對於需要最新功能的開發者,官方明確建議轉向 nanochat。
不過,nanoGPT 的歷史地位並未因此減損。它仍然是理解 GPT 訓練原理最直接的原始碼教材,其訓練迴圈與模型結構的設計思路被大量教學課程、論文附錄與開源專案引用。對於學習者而言,先讀懂 nanoGPT 再接觸更複雜的框架,是台灣與亞洲開發者社群中公認有效的學習路徑。
nanoGPT 已於 2025 年 11 月宣布進入維護狀態,官方推薦開發者轉向新一代的 nanochat 專案。nanoGPT 繼續保留作為教學與參考用途,其極簡設計仍被大量課程與開源專案引用,是學習 GPT 原理不可取代的入門教材。
如何用 nanoGPT 訓練自己的 GPT?
nanoGPT 的入門門檻設計得相當低。開發者只需安裝 PyTorch、NumPy、Transformers、Datasets、tiktoken 等依賴,即可開始。最快體驗方式是訓練一個字元級的 GPT:執行資料準備腳本將莎士比亞文集轉為整數序列,接著在一張 A100 顯示卡上以三分鐘完成訓練,再透過採樣腳本生成模仿原文風格的文字,整個流程不到十分鐘即可完成。
對於只有一般電腦的學習者,nanoGPT 也提供 CPU 與 Apple Silicon(MPS)加速的訓練設定,透過縮小模型層數、注意力頭數與上下文長度,同樣可以在數分鐘內完成小模型的訓練。進階使用者則可參考官方設定,以單節點 8 張 A100 重現 GPT-2 1.24 億參數的完整訓練,或直接載入 OpenAI 發布的 GPT-2 各尺寸權重進行基準測試與微調。
使用 nanoGPT 只需安裝 PyTorch 等基礎依賴,最快可在一張 A100 上三分鐘內完成字元級 GPT 訓練並生成文字。一般電腦可用 CPU 或 Apple Silicon 加速跑小模型,進階使用者可重現完整 GPT-2 訓練或載入官方權重進行微調,門檻從初學者到研究者皆可對應。
nanoGPT 的數據表現如何?
以客觀數據檢視,nanoGPT 的 6.2 萬星標與 1.08 萬次 fork,使其位居 GitHub 上最受歡迎的深度學習教學項目之列。項目創建於 2022 年 12 月 28 日,最近一次更新為 2026 年 8 月 30 日,雖已進入維護狀態仍維持基本更新。授權採用 MIT License,允許商業使用與自由修改,進一步降低了採用的法律門檻。


nanoGPT 在 GitHub 擁有 6.2 萬星標與 1.08 萬次 fork,主要語言為 Python,採用 MIT 授權。項目創建於 2022 年 12 月,最近更新於 2026 年 8 月,雖已進入維護狀態仍是深度學習教學領域最受歡迎的開源項目之一。
出處連結有哪些?
本文資訊來源為 nanoGPT 的 GitHub 儲存庫,包含項目原始碼、官方文件與發布紀錄。讀者可透過以下連結取得第一手資料:https://github.com/karpathy/nanoGPT
本文資訊來源為 karpathy/nanoGPT 的 GitHub 儲存庫,內含完整原始碼、訓練設定、基準測試數據與更新紀錄。讀者可前往該儲存庫查看 train.py 與 model.py 的實作細節,以及官方推薦的 nanochat 繼任專案連結。
總結:nanoGPT 適合什麼團隊?
nanoGPT 最適合三類使用者:第一是正在學習 Transformer 與語言模型原理的開發者,極簡程式碼是最佳的逐行教材;第二是需要快速驗證模型訓練想法、進行小型實驗的研究人員,600 行內即可完成修改與訓練;第三是教學者,可將其作為課程的標準參考實作。對於需要生產級部署或多節點大規模訓練的團隊,則應評估 nanochat 或更完整的訓練框架。整體而言,nanoGPT 以極簡設計完成了教育與實用的平衡,在開源 AI 生態中具有難以取代的價值。
nanoGPT 適合學習 Transformer 原理的開發者、需要快速實驗的研究人員與教學者。極簡程式碼使其成為最佳入門教材,但生產級部署或大規模訓練建議改用 nanochat 等更完整的框架。其教育與實用兼顧的定位,在開源 AI 生態中具有難以取代的價值。