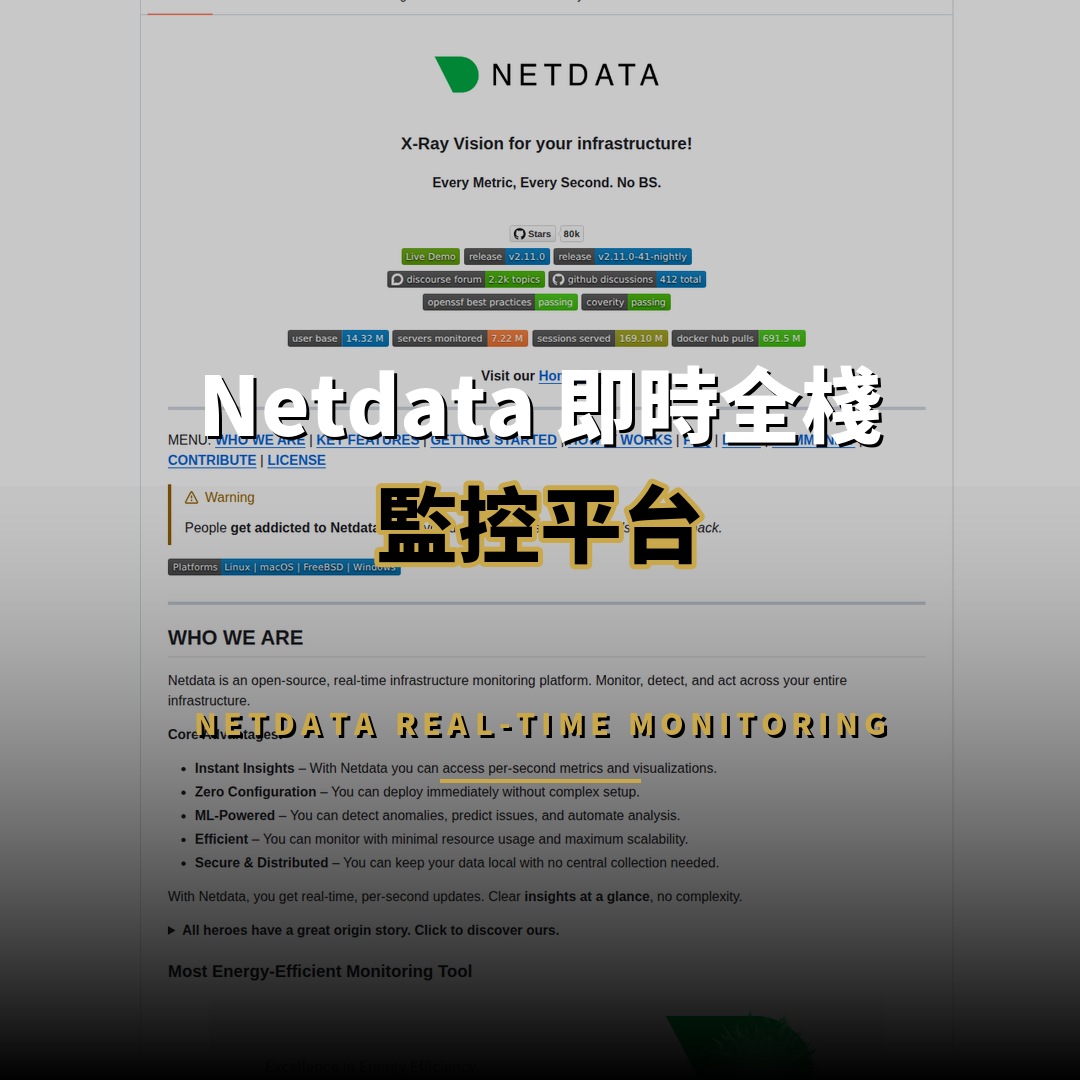
Netdata 是 GitHub 星標超過 80,218 顆的開源實時基礎設施監控平台,讓使用者以「接近零設定」的方式部署後,即時取得每秒更新的伺服器、容器、應用程式與硬體指標,並透過內建的邊緣機器學習進行無監督異常偵測,可運行於 Linux、macOS、FreeBSD、Windows 與 Kubernetes 等環境,具備 800 多種整合與極低資源佔用,是自建可觀測性方案的熱門選擇。
Netdata 是 GitHub 逾 8 萬星的開源實時基礎設施監控平台,以每秒採集與邊緣機器學習異常偵測為核心,支援 Linux、macOS、Windows、容器與 Kubernetes,具備 800 多種整合與接近零設定部署。
Netdata 是什麼?
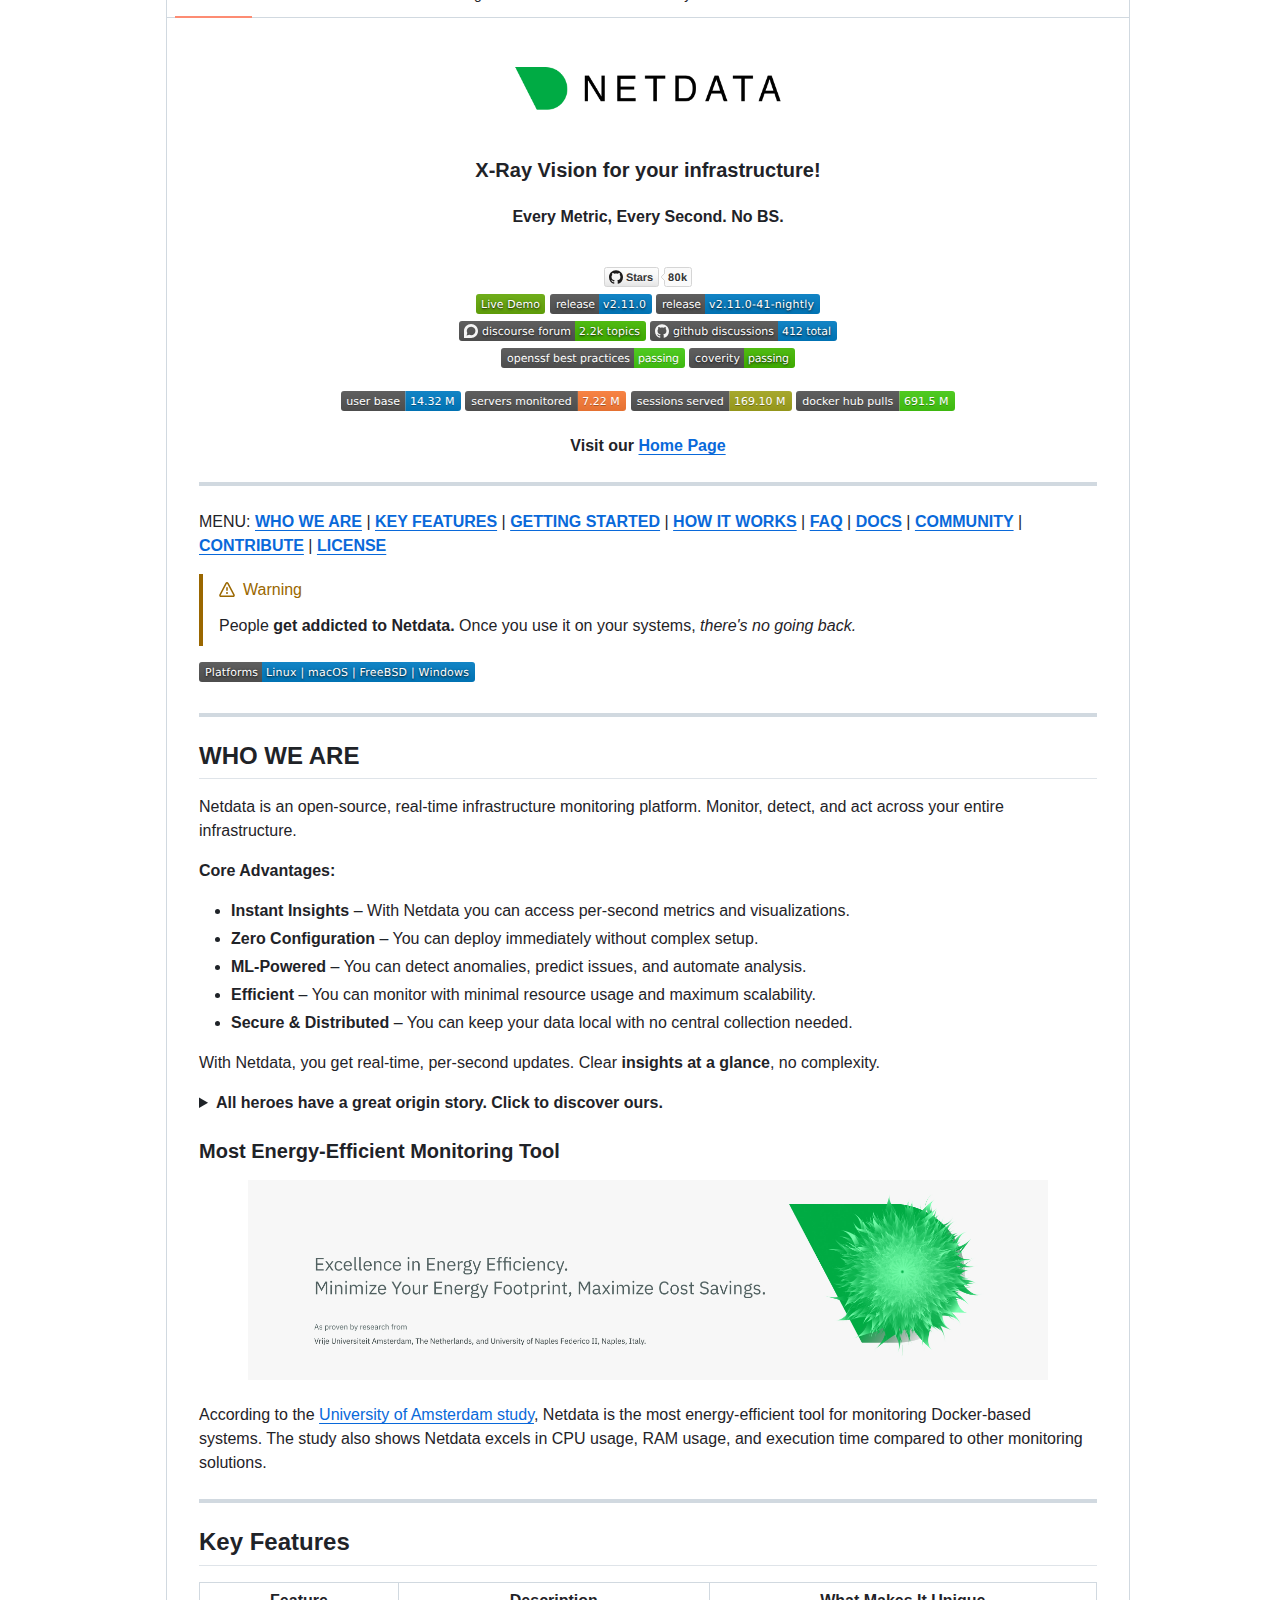
Netdata 是由 netdata 團隊開發與維護的開源監控項目,起源於創辦人 Costa Tsaousis 在 2013 年因公司雲端交易大量無聲失敗、而當時沒有任何監控工具能找出根因而受挫的親身經歷。他決定從零打造一套監控工具,最終發展成今日的 Netdata 平台,並成為 Cloud Native Computing Foundation(CNCF)成員,也是該基金會可觀測性領域星標最高的項目之一。項目的核心定位是「為基礎設施提供 X 光般的透視能力」,讓從單一伺服器到複雜多雲環境的指標都能一眼掌握。
Netdata 起源於創辦人 2013 年因既有監控工具無法找出交易故障根因而受挫的經歷,從零打造而成,現為 CNCF 成員,定位是為基礎設施提供即時透視能力的開源監控平台。
Netdata 的主要賣點在於「即時」與「自動化」。官方文件強調,使用者只要完成安裝,Netdata 就會自動偵測並開始收集系統上幾乎所有元件的指標,包括 CPU、記憶體、儲存、網路、硬體感測器、容器、虛擬機器、系統日誌與數百種套件應用程式,不需要手動配置收集器或撰寫查詢語法。這種「開箱即用」的設計顯著降低了傳統監控方案的部署與維護成本,尤其適合人手精簡的中小型團隊。
Netdata 強調即時與自動化,安裝後自動偵測並收集 CPU、記憶體、儲存、網路、容器、虛擬機與數百種應用程式的指標,無需手動配置收集器或撰寫查詢語法。
Netdata 有哪些核心技術亮點?
Netdata 最核心的技術亮點之一,是「邊緣式機器學習異常偵測」。與一般將數據集中到後端再分析的架構不同,Netdata 直接在每個節點本地為每個指標訓練多個機器學習模型,依據近期歷史行為自動辨識異常,再以「異常評分」的方式呈現,讓使用者能一眼看出哪個指標偏離正常範圍,而不需要預先設定閾值或撰寫規則。這種分散式的設計既保護資料隱私,也能在亞秒級延遲下即時反應。
核心亮點之一是邊緣式機器學習異常偵測,Netdata 在每個節點本地為每個指標訓練多個模型,依歷史行為自動辨識異常並以異常評分呈現,無需預設閾值。
另一個亮點是「極低資源佔用的即時採集」。Netdata 採用高效能的時間序列資料庫與分層儲存設計,每個樣本僅約需 0.5 bytes 即可儲存,並以 Tier 0 秒級、Tier 1 分鐘級、Tier 2 小時級的分層方式自動壓縮保留資料;官方數據顯示,即使在啟用機器學習與每秒指標的情況下,Netdata 在正式環境預設只佔用約 5% CPU 與 150 MiB 記憶體,若停用 ML 與警報則可低至不足 1% CPU 與約 100 MiB 記憶體,並可選擇完全在記憶體中運行而完全不寫入磁碟。
另一亮點是極低資源佔用的即時採集,每個樣本約 0.5 bytes 並以秒/分/時三層分層儲存;預設僅佔約 5% CPU 與 150 MiB 記憶體,停用 ML 與警報時可低至不足 1% CPU。
Netdata 如何做到每秒監控與邊緣 AI?
Netdata 管線由多個模組組成:收集、儲存、學習、偵測、檢查、串流、封存、查詢與評分。每個 Agent 會先從系統、容器、應用程式、日誌、API 與合成檢查中收集指標,存入高效率的分層時間序列資料庫;接著在本地訓練機器學習模型,利用訓練結果辨識異常、套用預設或自訂的警報規則,再視需要將指標實時串流給 Netdata Parent 做集中化,或封存到 Prometheus、InfluxDB、OpenTSDB、Graphite 等外部系統。這種「分散式可觀測性管線」讓不同規模的部署都能靈活組合。
Netdata 以收集、儲存、學習、偵測、檢查、串流、封存、查詢與評分等模組組成管線,先在本機收集指標並訓練 ML 模型,再視需要串流給 Parent 或封存到 Prometheus 等外部系統。
在擴展性方面,Netdata 採用「子母節點」架構:大量 Agent 可水平擴展橫向接管更多主機,而功能較強的 Parent 則縱向集中處理多個節點的儀表板、警報與較長期的資料保留,最高可處理每秒數百萬個指標。若需要橫跨多個獨立基礎設施的統一視圖,使用者可選擇接上 Netdata Cloud 做企業級管理,但官方強調 Cloud 屬選用功能,所有指標仍可完全留在使用者自己的基礎設施內,不會有中央化收集的隱私疑慮。
擴展性採用子母節點架構,大量 Agent 水平橫向接管更多主機,功能較強的 Parent 縱向集中處理儀表板與警報,可處理每秒數百萬指標;Netdata Cloud 屬選用功能,資料可完全留在本地。
Netdata 支援監控哪些系統與應用?
Netdata 的收集能力相當全面,涵蓋系統資源、儲存、網路、硬體與感測器、作業系統服務、程序、容器、虛擬機器、合成檢查(如 API、TCP 連接埠、Ping、憑證),以及 nginx、Apache、PostgreSQL、Redis、MongoDB 等數百種常見套件應用程式,並能自訂 OpenMetrics 與 StatsD 指標。在 Linux 環境下,它還能持續監控 Intel、AMD、Nvidia GPU、PCI AER、RAM EDAC、IPMI、NVMe、風扇、電源供應與電壓等硬體感測值,讓底層硬體的健康狀態也一目了然。
Netdata 可監控系統資源、儲存、網路、硬體感測器、程序、容器、虛擬機、合成檢查與數百種套件應用程式,在 Linux 下並能監控 Intel/AMD/Nvidia GPU 與各類硬體感測值。
在部署彈性上,Netdata 提供官方的一鍵安裝程式、macOS 安裝包、FreeBSD 支援、Windows 安裝程式、Docker 映像與 Kubernetes 設定,幾乎所有主流部署方式都能覆蓋。安裝完成後,使用者可透過瀏覽器連到 http://localhost:19999(或 http://NODE:19999)立即檢視即時儀表板;這種「單一指令開始、瀏覽器即用」的體驗,是項目吸引眾多開發者的重要原因。
部署支援一鍵安裝、macOS、Windows、FreeBSD、Docker 映像與 Kubernetes,安裝後以瀏覽器連到 localhost:19999 即可檢視即時儀表板,實現單一指令開始、瀏覽器即用的體驗。
如何快速開始使用 Netdata?
開始使用 Netdata 非常直接:使用者可參考官方文件,依據自己的平台選擇 Linux 的一鍵安裝、macOS、FreeBSD、Windows、Docker 或 Kubernetes 安裝方式。完成安裝後,第一步是確認收集器,Netdata 通常會自動偵測大部分指標,但也可手動配置 SNMP 等特定收集器;第二步是設定警報,Netdata 內建數百種預設警報,並支援 email、Slack、Telegram、PagerDuty、Discord、Microsoft Teams 等多種通知管道。若需集中管理多台主機,可設定 Netdata Parent 統一整合儀表板、警報與儲存。
開始使用只需依平台完成安裝,Netdata 大多自動偵測指標,再設定數百種內建警報並接到 email、Slack、Telegram、Discord 等通知管道,需要時可加設 Parent 集中管理多主機。
值得留意的是,Netdata 官方網頁與文件提供了覆蓋法蘭克福、紐約、亞特蘭大、舊金山、多倫多、新加坡與班加羅爾等地的實時示範站點,使用者不需安裝任何軟體就能先在網頁上實際體驗即時監控儀表板的效果。這種「先試用再安裝」的模式,大幅降低了評估門檻,讓有興趣的團隊可以先確認功能是否符合需求再投入部署。
Netdata 提供覆蓋全球多個城市的實時示範站點,使用者不需安裝即可在網頁直接體驗即時監控儀表板,先用後裝的低門檻模式有助於評估是否符合需求。
Netdata 與 Prometheus、Grafana 有何不同?
Netdata 與 Prometheus、Grafana 是市場上常被比較的兩類監控方案。Prometheus 是收集與查詢時間序列資料的開源系統,搭配 Grafana 做視覺化儀表板,兩者合起來能組成功能強大的監控棧,但通常需要使用者自行設計收集器、撰寫查詢或配置儀表板。相比之下,Netdata 提供一套「完整解決方案」:安裝後自動產生儀表板、內建機器學習異常偵測、預設警報與關聯分析,使用者不需要手動組合不同工具。官方並提供與 Prometheus 的效能對比報告供參考。
與 Prometheus+Grafana 需自行組合收集器、查詢與儀表板不同,Netdata 提供安裝即用的完整解決方案,自動產生儀表板、內建 ML 異常偵測、預設警報與關聯分析,並提供官方效能對比。
另一方面,Netdata 也能與既有監控體系共存。官方文件指出,Netdata 可以與 Nagios、Zabbix 等傳統工具並行運行,提供補充性的實時高解析度視圖、異常偵測與自動化儀表板,並能透過封存功能將指標輸出到 Prometheus、InfluxDB、Graphite 等外部時間序列系統。因此對已經有既有監控棧的團隊而言,Netdata 並非一定要「取代」原有方案,也可以作為提升即時可視性與異常偵測能力的補充工具。
Netdata 可與 Nagios、Zabbix 等傳統工具並行,補充實時高解析度視圖與異常偵測,也可將指標封存到 Prometheus、InfluxDB、Graphite 等外部系統,適合作為既有監控棧的補充。
Netdata 值得一試嗎?
從技術與生態角度評估,Netdata 的優勢在於即時性、邊緣機器學習與極低資源佔用,尤其適合希望以低成本快速建立全面可觀測性的開發者與中小型團隊。其接近零設定的部署方式、瀏覽器即用的儀表板,以及可選的實時示範站點,都讓評估與上手門檻降到很低。對於重視資料私隱的使用者,指標可完全保留在本機的設計也是一大吸引點;而對已投資既有監控棧的大型組織,則可先從補充性用途開始嘗試。
Netdata 在即時性、邊緣機器學習與極低資源佔用上有明顯優勢,適合希望低成本快速建立可觀測性的開發者與中小型團隊;指標可保留本機、支援先用後裝,值得一試。
綜合而言,Netdata 以逾 8 萬顆星標與活躍的開發節奏,證明了它在開源監控領域的受歡迎程度。其每秒級即時指標與邊緣 AI 異常偵測的組合,填補了傳統監控工具在高解析度實時可視性上的缺口,並以開源授權與可自架特性,為不想受制於商業 SaaS 定價與資料外流的團隊,提供了一套務實且具擴展性的可觀測性方案。
整體而言,Netdata 以逾 8 萬星標證明其在開源監控的受歡迎程度,每秒即時指標與邊緣 AI 異常偵測填補傳統工具缺口,開源自架特性適合不想受制於商業 SaaS 定價的團隊。
出處連結有哪些?
本篇文章的資料來源為 Netdata 在 GitHub 上的官方儲存庫及官方文件,讀者可前往以下連結查閱項目的原始程式碼、安裝指南與完整架構說明。
本文資料來源為 Netdata 官方 GitHub 儲存庫與官方文件,讀者可前往 https://github.com/netdata/netdata 查閱原始程式碼、安裝指南與完整架構說明。
- GitHub 儲存庫:https://github.com/netdata/netdata
- 官方網站:https://www.netdata.cloud
- 官方文件:https://learn.netdata.cloud
常見問題有哪些?
Netdata 適合什麼規模的團隊?
Netdata 的接近零設定與低資源佔用設計,特別適合開發者、系統管理員與中小型團隊,同時其子母節點架構與 Netdata Cloud 支援也能擴展到多雲大型基礎設施,可涵蓋從單機到企業級的各種規模。
Netdata 的資源佔用真的很低嗎?
是。官方數據顯示,即使啟用機器學習與每秒指標,Netdata 在正式環境預設約佔用 5% CPU 與 150 MiB 記憶體;停用 ML 與警報並使用臨時儲存時,可降至不足 1% CPU 與約 100 MiB 記憶體。
Netdata 的資料可以保留多久?
Netdata 使用分層儲存,保留時間主要受磁碟空間影響:Tier 0 每秒解析度、Tier 1 每分鐘解析度、Tier 2 每小時解析度,查詢時依縮放層級自動選用,也可選擇完全在記憶體中運行。
Netdata 需要連接雲端才能使用嗎?
不需要。Netdata 可完全離線單獨運作;Netdata Cloud 屬選用功能,用於遠端存取、集中警報與多基礎設施統一視圖等,所有指標仍可完全保留在使用者自己的基礎設施內。
Netdata 會與現有監控工具衝突嗎?
不會。Netdata 可與 Nagios、Zabbix 等既有工具並行運行,作為補充性的實時高解析度視圖與異常偵測,並能將指標封存輸出到 Prometheus、InfluxDB、Graphite 等外部系統。
總結:如何評估 Netdata 的應用價值?
總結而言,Netdata 以超過 8 萬顆星標與活躍開發節奏,成為開源實時監控領域的代表性項目之一。它以每秒級指標收集、邊緣機器學習異常偵測、800 多種整合與極低資源佔用為核心優勢,並透過接近零設定部署與先試用再安裝的模式降低使用門檻。對於希望以合理成本建立全面可觀測性、同時保持資料私隱的團隊,Netdata 是一套值得深入評估的開源方案。
總結而言,Netdata 以逾 8 萬星標與活躍開發節奏成為開源實時監控代表項目,每秒指標、邊緣 ML 異常偵測、800 多種整合與低資源佔用為核心優勢,適合以合理成本建立全面可觀測性的團隊。