
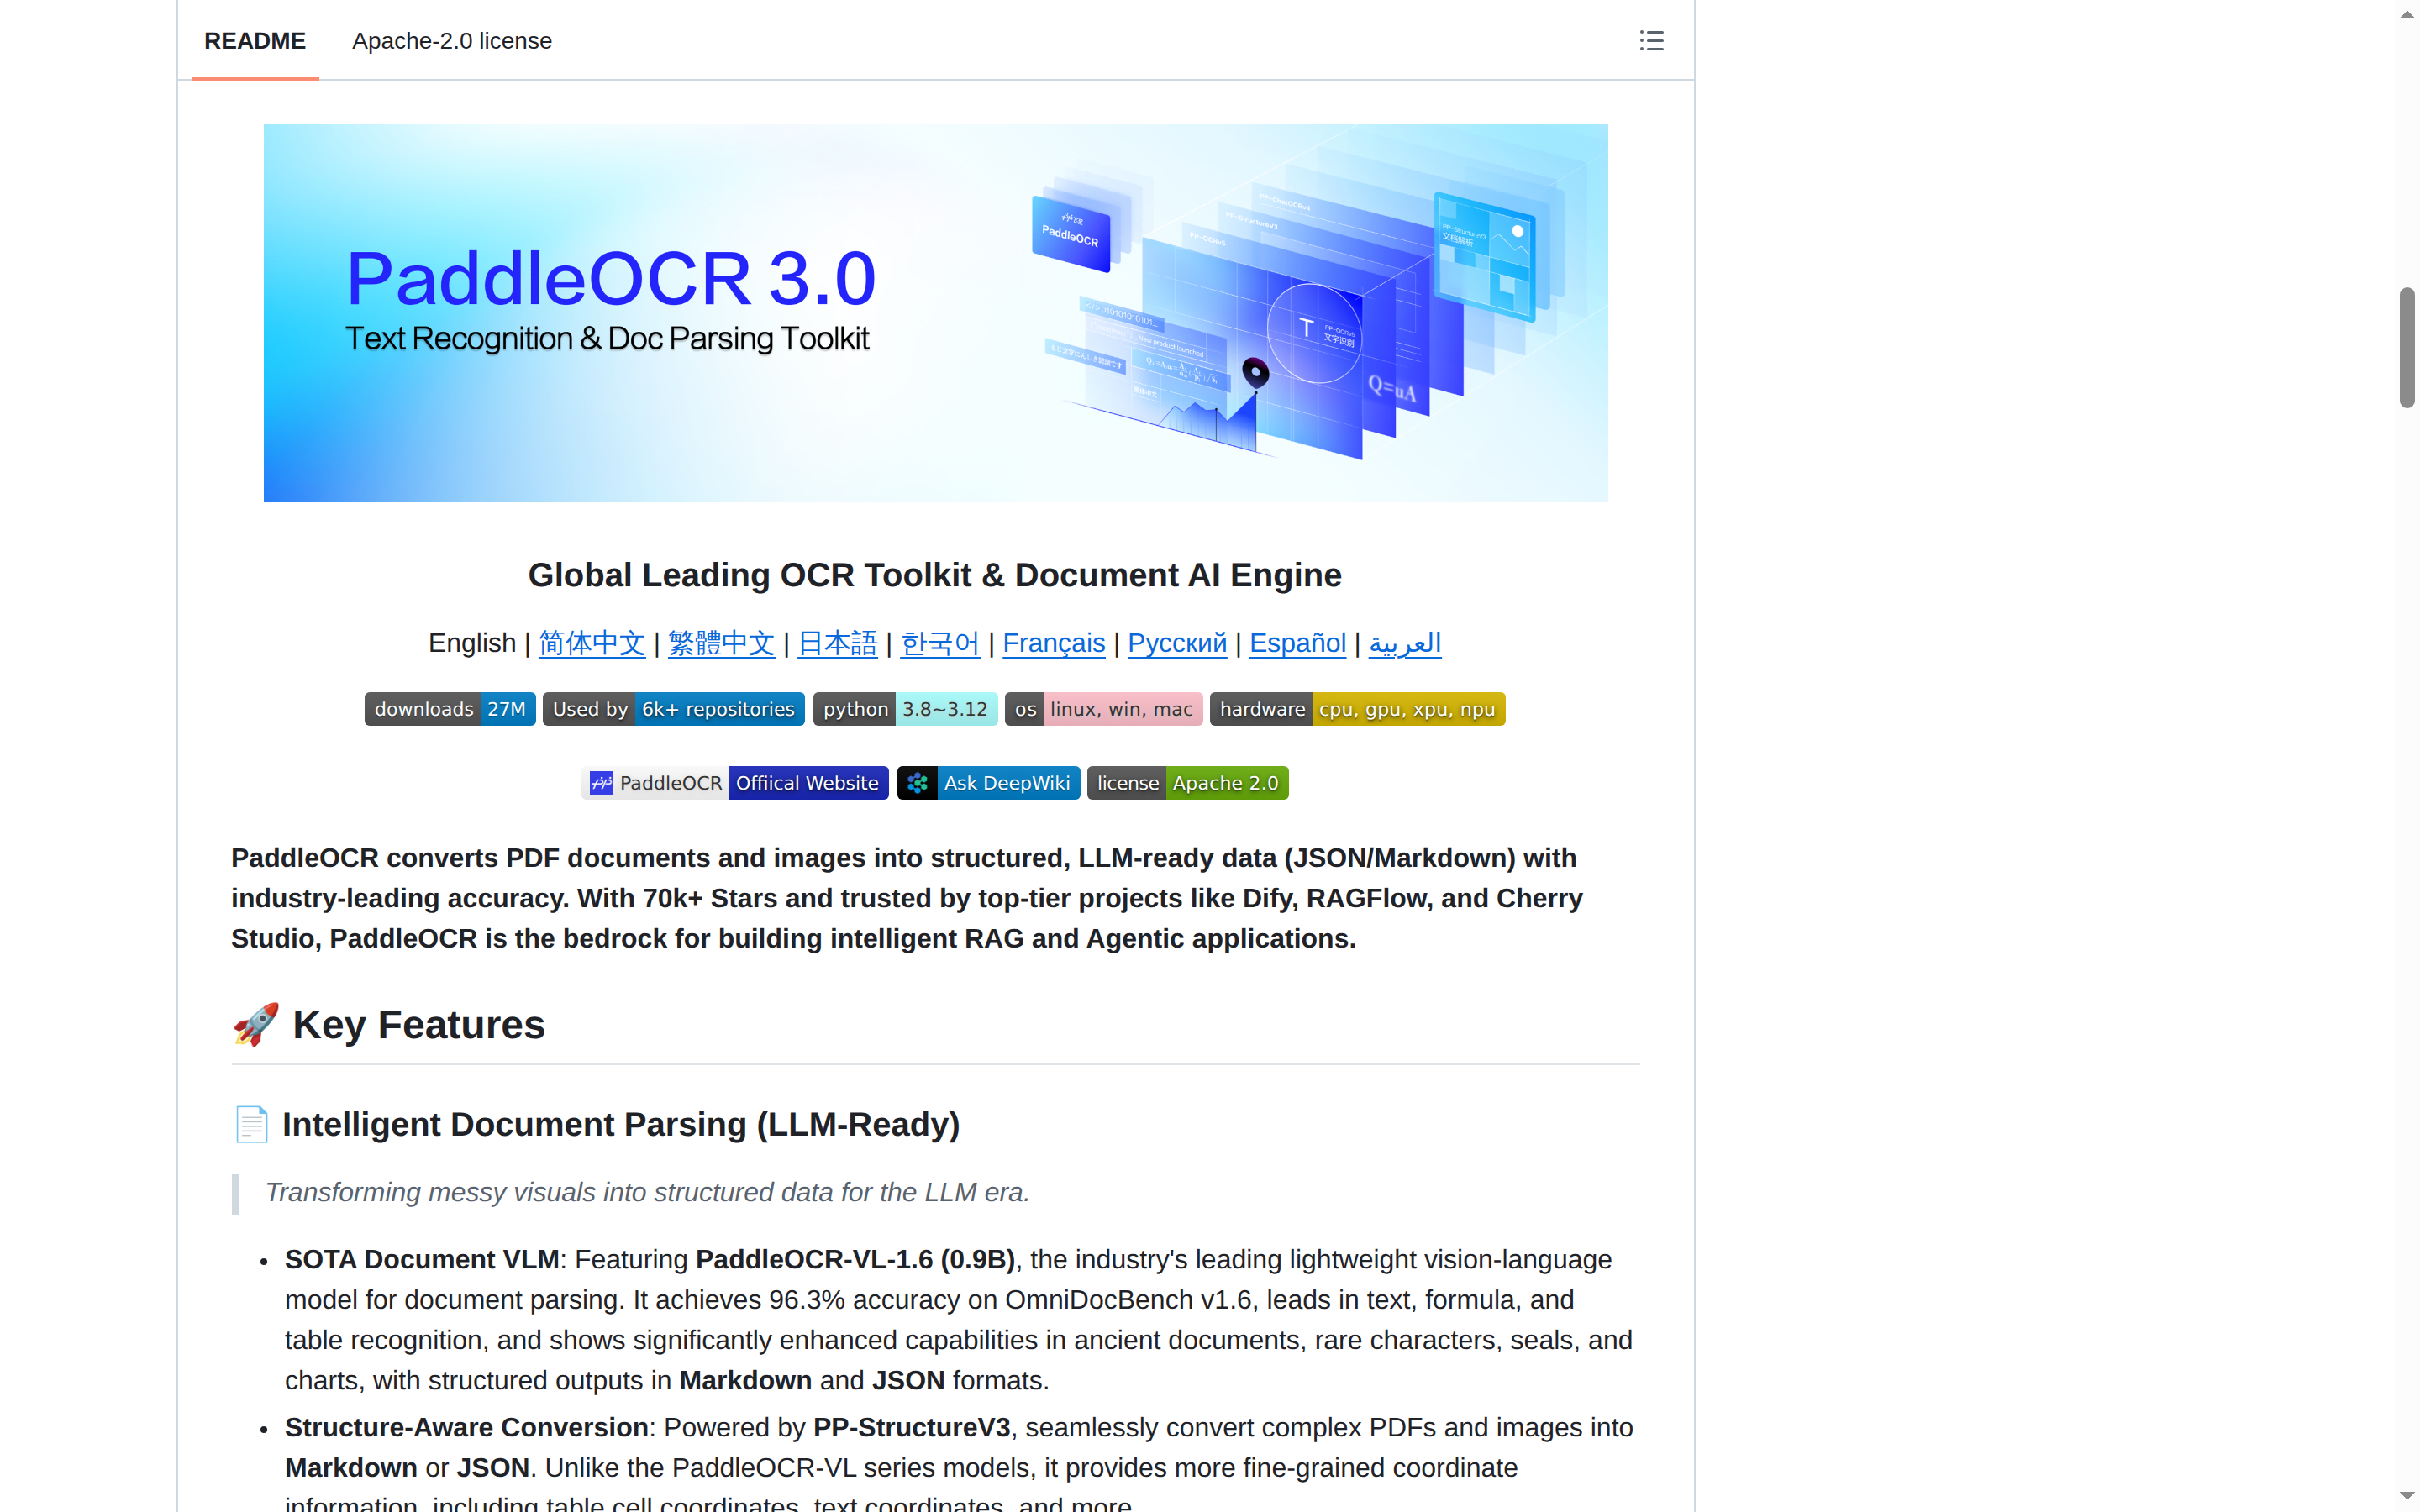
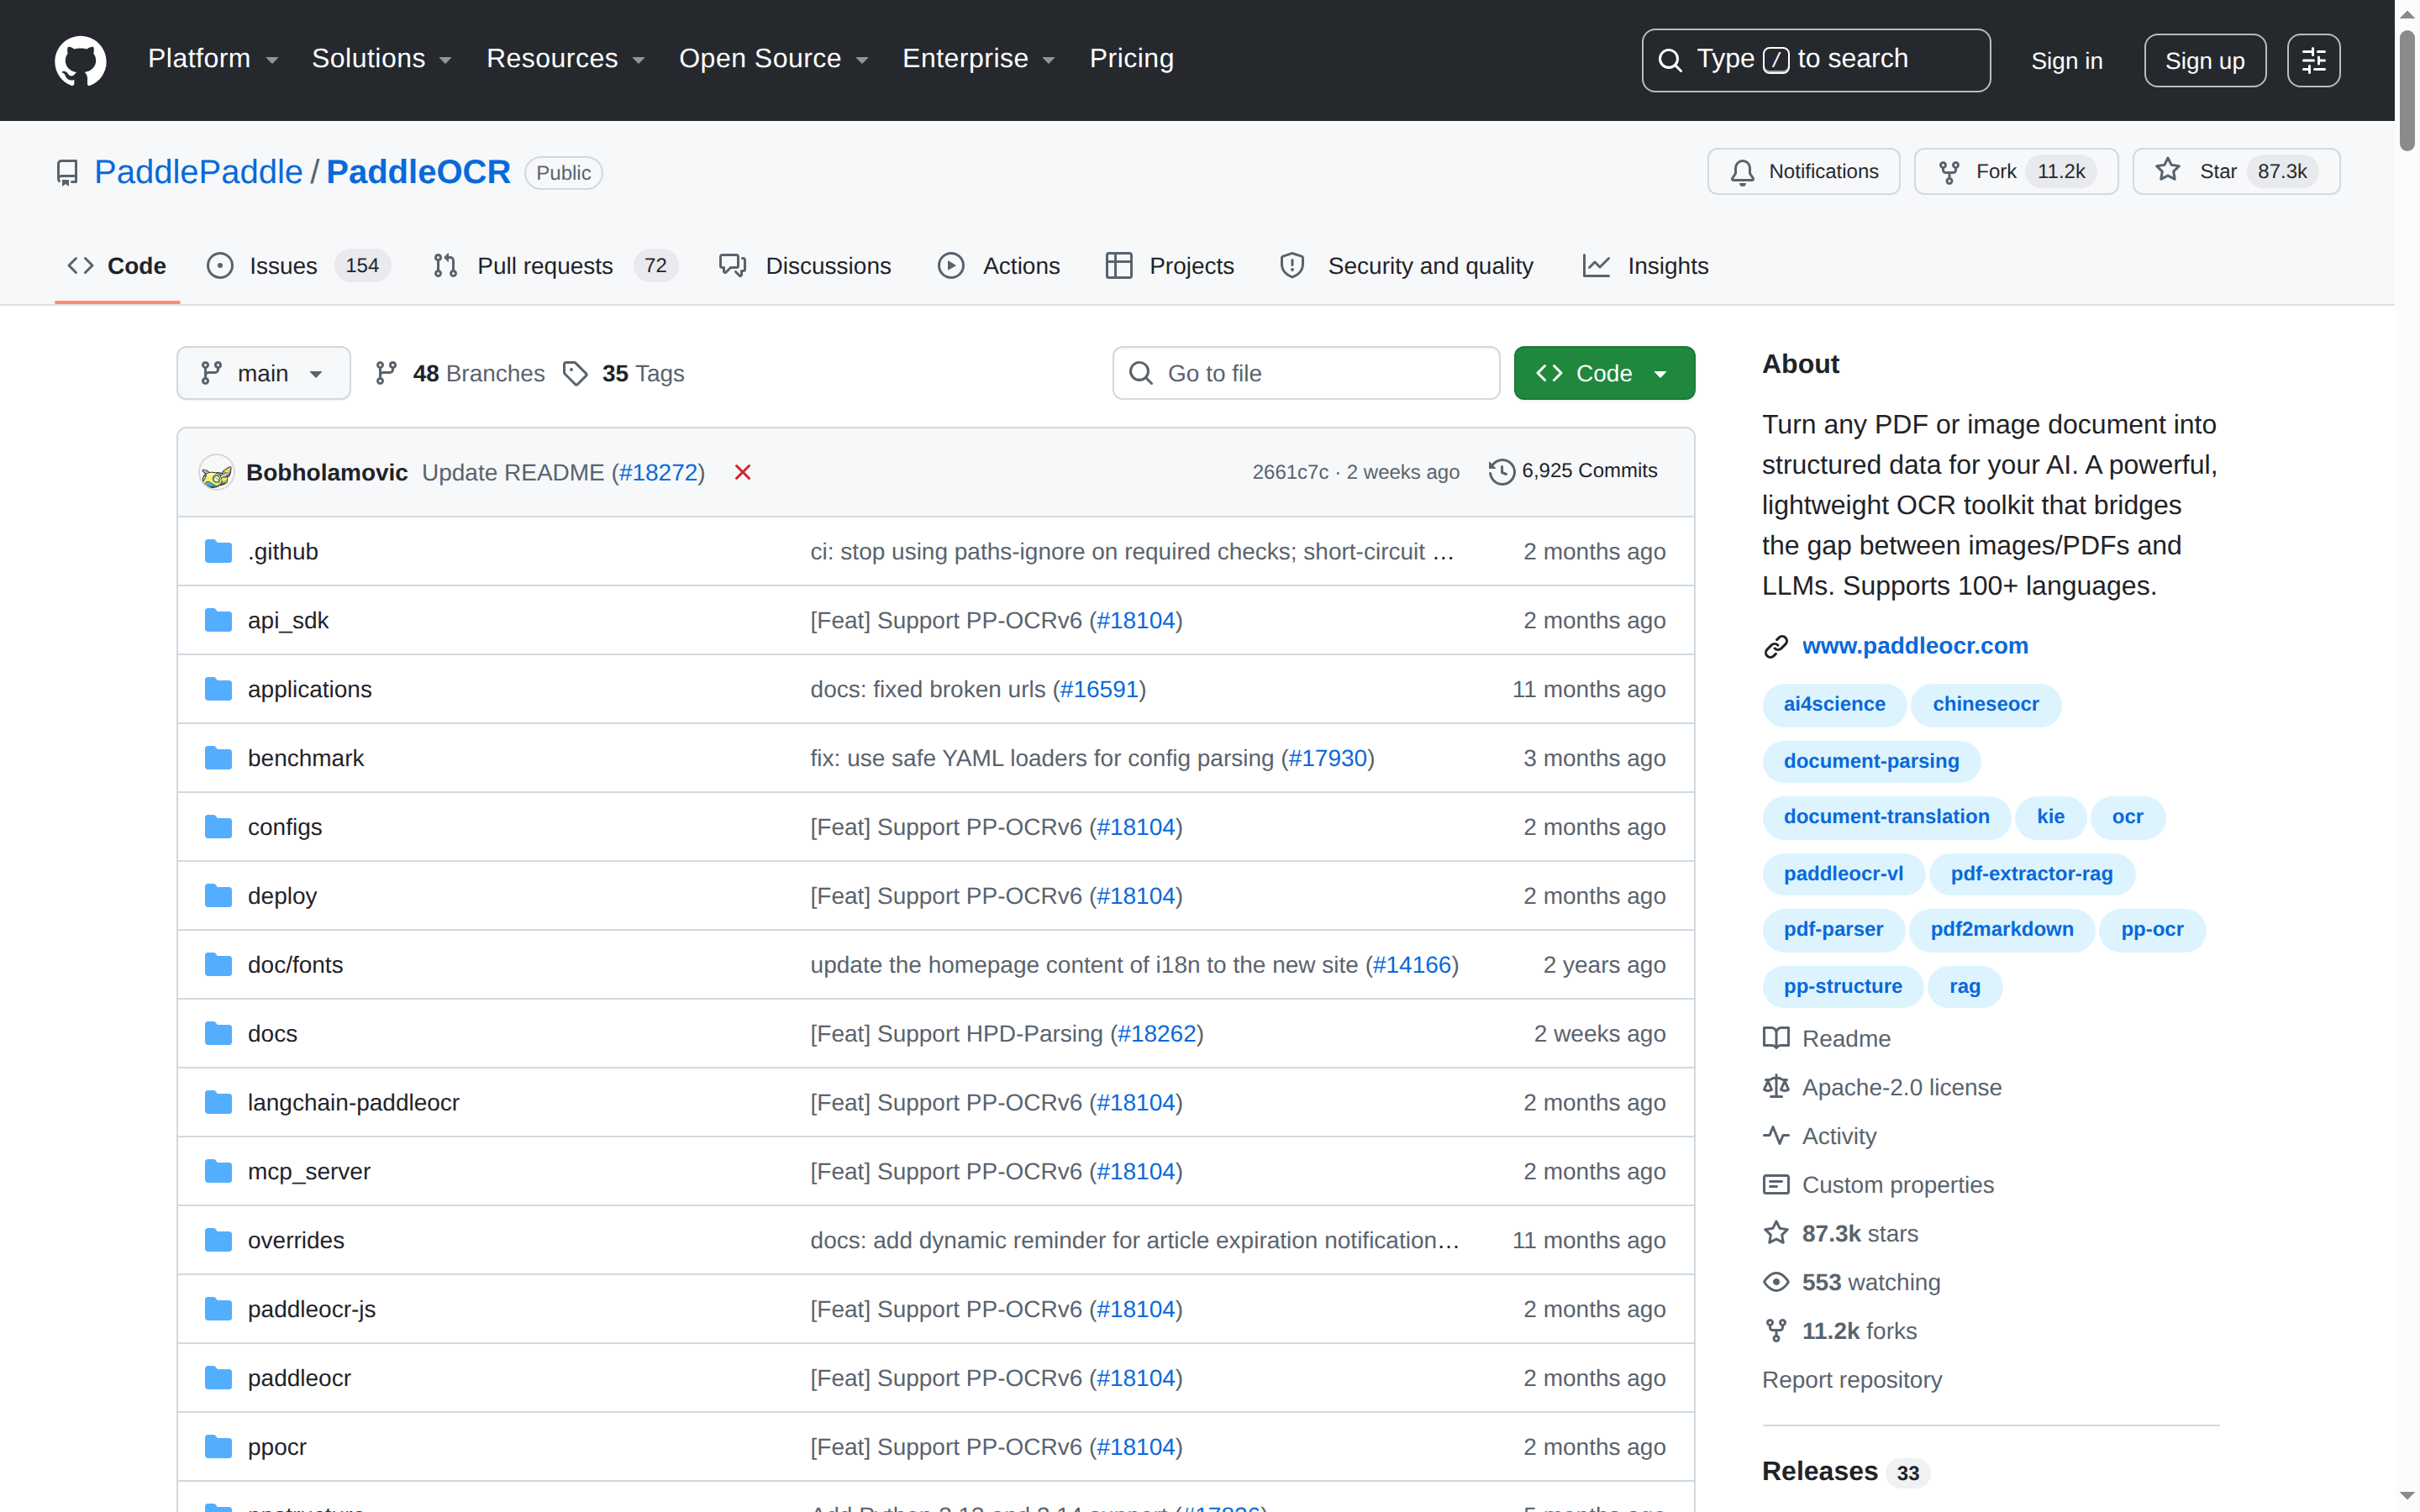
PaddleOCR 是百度開源的全球領先 OCR 與文檔解析引擎,在 GitHub 上獲得超過 87,000 顆星標與 11,000 多次復刻,其核心能力是將 PDF 文件與圖片轉換為大型語言模型可直接使用的結構化數據(Markdown 與 JSON 格式),支援 100 種以上語言,並深度整合 Dify、RAGFlow 等主流 AI 應用,是當前文檔解析領域最具影響力的開源項目之一。
PaddleOCR 是百度開源的全球領先 OCR 與文檔解析引擎,GitHub 星標超過 87,000 顆;可將 PDF 與圖片轉換為 LLM 可直接讀取的 Markdown 與 JSON 結構化數據,支援 100 種以上語言,採用 Apache 2.0 許可證免費商用。
PaddleOCR 是什麼?
PaddleOCR 由百度 PaddlePaddle 團隊於 2020 年 5 月開源,最初定位為高效的多語言文字辨識工具,歷經六年迭代,已從單一的場景文字辨識(Scene OCR)演進為完整的文檔 AI 引擎。項目涵蓋兩大核心管線:其一是通用文字辨識,支援自然場景中的身份證、街景、書本與工業元件等複雜文字偵測;其二是智能文檔解析,可將複雜的 PDF 與圖片轉換為帶結構資訊的 Markdown 或 JSON,輸出內容包含表格單元座標、文字座標等精細資訊,直接對接檢索增強生成(RAG)與代理式應用(Agentic Application)的數據需求。
PaddleOCR 是百度開源的文檔 AI 引擎,2020 年發布,涵蓋場景文字辨識與智能文檔解析兩大管線;可輸出帶座標的 Markdown 與 JSON 結構化數據,直接對接 RAG 與代理式應用的數據需求,支援 100 種以上語言。
PaddleOCR 有哪些核心技術亮點?
技術亮點集中在三個層面。第一是輕量視覺語言模型 PaddleOCR-VL 系列,旗艦版本 VL-1.6 僅 9 億參數,卻在 OmniDocBench v1.6 基準測試中取得 96.3% 準確率,在文字、公式與表格辨識上同時領先開源與閉源方案,輸出直接採用 Markdown 與 JSON 結構。第二是 PP-OCRv6 統一模型,以單一模型覆蓋中文、英文、日文與 46 種拉丁語系語言共 50 種語言,無需切換模型即可處理多語文件,中型模型僅 3,450 萬參數,在偵測與辨識準確率上分別較上一代提升 4.6% 與 5.1%,並超越 Qwen3-VL-235B 與 GPT-5.5 等主流視覺語言模型。
核心亮點有三:PaddleOCR-VL-1.6 僅 9 億參數即在 OmniDocBench 取得 96.3% 準確率;PP-OCRv6 以單一模型覆蓋 50 種語言,3,450 萬參數即超越主流視覺語言模型;PP-StructureV3 提供含表格座標的結構化轉換能力。
第三是結構感知轉換引擎 PP-StructureV3,與視覺語言模型路線互補,提供更精細的座標資訊,包括表格單元座標與文字座標,適合需要版面還原與精確定位的生產場景。性能表現同樣突出,PP-OCRv6 在 CPU 上獲得 5.2 倍端對端加速,在 A100 GPU 上單張推理僅需 0.13 秒,並提供 tiny、small、medium 三種規模(分別為 150 萬、770 萬與 3,450 萬參數),對應邊緣裝置、流動裝置與伺服器部署需求。
PP-StructureV3 提供含表格單元座標與文字座標的精細結構輸出,適合版面還原場景;PP-OCRv6 在 CPU 獲 5.2 倍加速、A100 單張推理 0.13 秒,提供 tiny、small、medium 三種規模,覆蓋邊緣至伺服器部署。
PaddleOCR 如何將文件轉換為 AI 可用數據?
轉換流程以「解析管線」為核心,開發者只需輸入 PDF 或圖片,系統即輸出對應的 Markdown 或 JSON 結構化數據。視覺語言模型路線擅長整體頁面理解,自動識別標題層級、表格、公式與圖表;PP-StructureV3 路線則提供精確座標,兩者可依場景選用。輸出數據可直接注入檢索增強生成管線作為向量化來源,或作為微調大型語言模型的訓練資料集,形成持續運轉的數據引擎。
PaddleOCR 將 PDF 與圖片轉換為 Markdown 或 JSON 結構化數據:視覺語言模型負責整體頁面理解,PP-StructureV3 提供精確座標;輸出可直接用於 RAG 向量化或語言模型微調,形成數據引擎閉環。
2026 年 7 月推出的 HPD-Parsing 進一步強化高吞吐場景,這款輕量視覺語言模型採用分層並行解碼與漸進式多 Token 預測架構,在公開基準上達到每秒 4,752 Token 的峰值吞吐量,支援 OpenAI 相容服務與自訂 vLLM 執行環境,適合對推理效率與部署吞吐有嚴格要求的文檔解析任務。
HPD-Parsing 是專為高吞吐文檔解析設計的輕量模型,採分層並行解碼架構,峰值吞吐達每秒 4,752 Token;支援 OpenAI 相容服務與 vLLM 執行環境,適合高併發生產場景。
PaddleOCR 在 AI 生態系統中扮演什麼角色?
PaddleOCR 已成為 AI 應用生態的底層基礎設施之一,被超過 6,000 個儲存庫依賴使用,並深度整合 Dify、RAGFlow、Pathway 與 Cherry Studio 等主流 AI 應用平台。在 RAG 架構中,文檔解析品質直接決定檢索效果,PaddleOCR 的結構化輸出能力使其成為許多知識庫系統的預設解析引擎。官方亦提供 PaddleOCR.js 瀏覽器推理 SDK,支援直接在瀏覽器運行 PP-OCRv5,進一步降低整合門檻。
PaddleOCR 被超過 6,000 個儲存庫依賴,深度整合 Dify、RAGFlow、Pathway 與 Cherry Studio;其結構化輸出能力使其成為 RAG 知識庫的預設解析引擎,PaddleOCR.js 更支援瀏覽器直接推理。
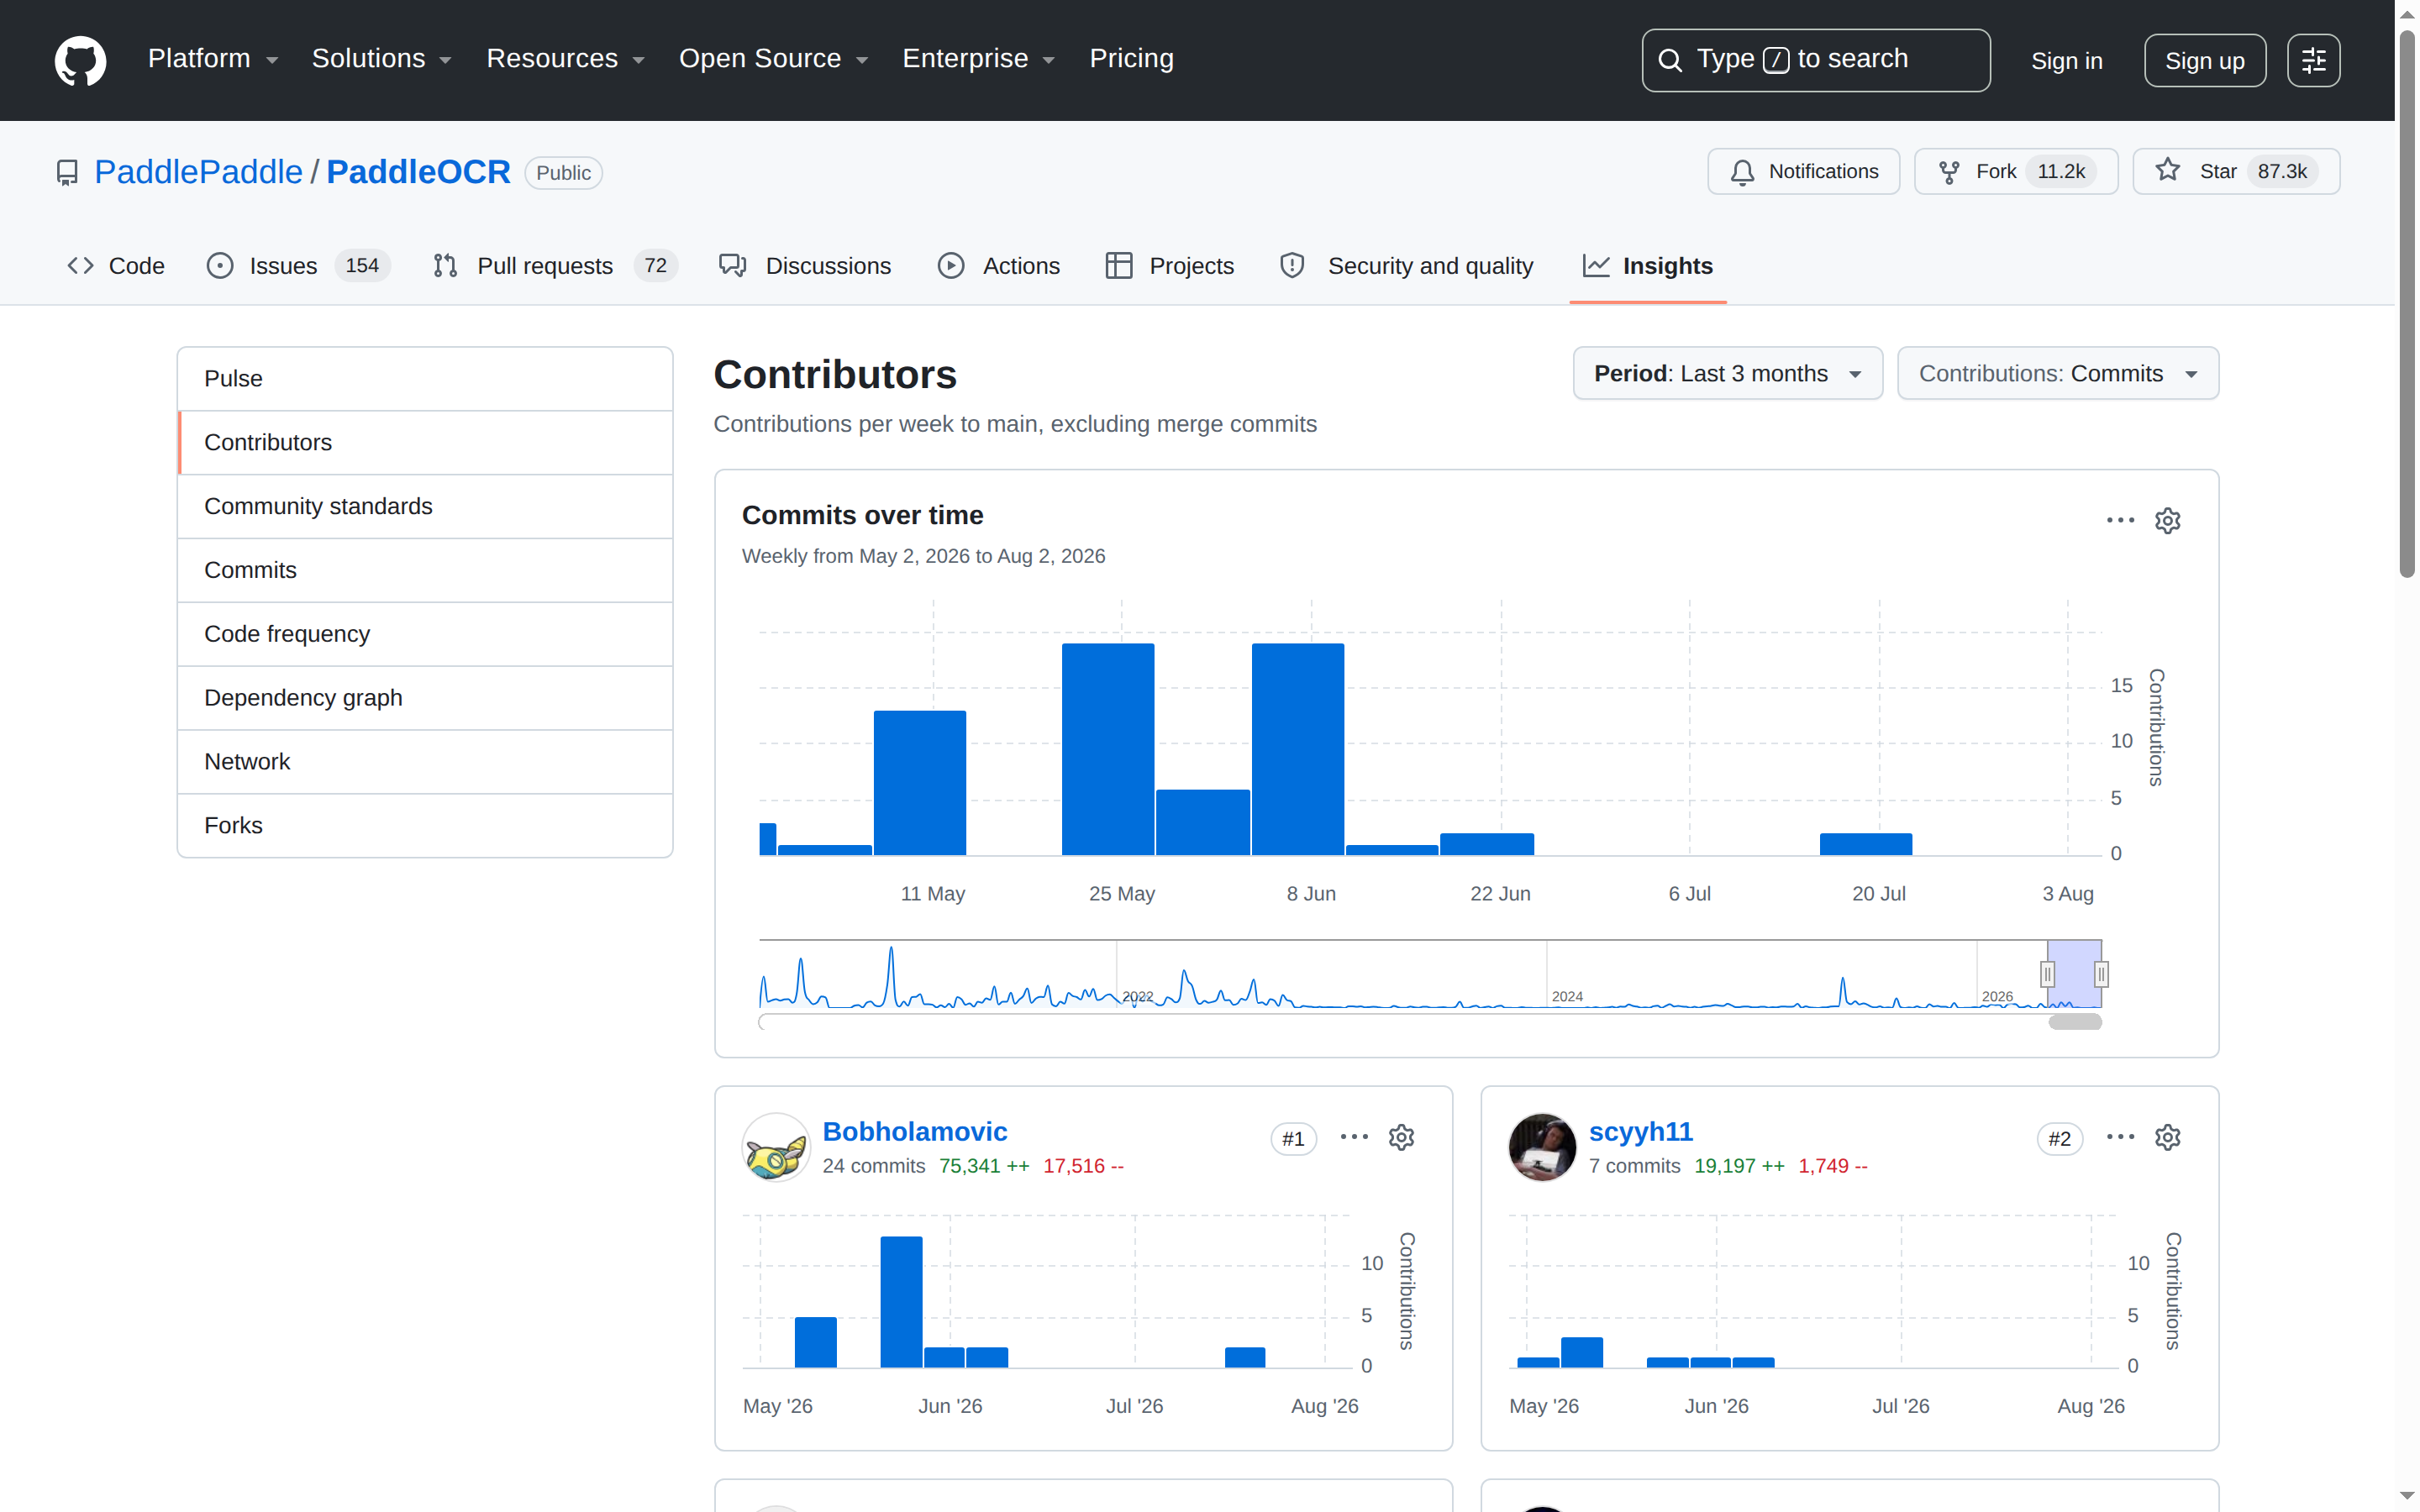
與同類開源方案相比,PaddleOCR 的差異化在於「輕量高效」路線:以 9 億參數的視覺語言模型達成超越大規模閉源模型的文檔解析準確率,同時維持 Apache 2.0 開源許可證與 CPU、GPU、XPU、NPU 多種硬件後端支援。項目由百度持續投入,2026 年上半年已發布 3.4、3.5、3.6、3.7 四個主要版本,迭代節奏穩定,並在 Hugging Face 與 ModelScope 同步發布模型,降低全球開發者的取用門檻。
差異化在於輕量高效路線:9 億參數模型達成超越大規模閉源模型的解析準確率,Apache 2.0 許可證開放商用;支援 CPU、GPU、XPU、NPU 多種硬件後端,2026 上半年發布四個主要版本,迭代穩定。
如何快速開始使用 PaddleOCR?
快速上手有三種途徑。第一是線上體驗,官方網站提供互動體驗中心與 API,無需安裝即可測試文檔解析效果;第二是本機部署,透過 pip 安裝 PaddleOCR 套件並調用預設管線,即可對單張圖片或 PDF 執行文字辨識與結構化輸出;第三是服務化部署,項目支援 Docker 映像、C++ 與 Java 等多語言 SDK,並可透過 OpenVINO、ONNX Runtime 與 TensorRT 加速推理,適合生產環境整合。
快速上手有三種途徑:官方網站線上體驗中心免安裝即測;pip 安裝後以 Python 管線直接處理圖片與 PDF;生產環境可用 Docker、C++/Java SDK 部署,並支援 OpenVINO、ONNX Runtime 與 TensorRT 加速推理。
PaddleOCR 值得一試嗎?
對於需要處理 PDF、掃描文件或圖片文字的開發團隊,PaddleOCR 提供了一條低成本高品質的技術路徑。項目以 Apache 2.0 許可證完全開源,商用無需授權費用,支援超過 100 種語言與多種硬件平台,無論是構建 RAG 知識庫、自動化文檔流程還是訓練專屬模型,都能找到對應能力。考慮到超過 87,000 顆星標、持續的版本迭代與百度團隊的長期維護,PaddleOCR 是文檔解析領域風險最低的開源選擇之一。
值得一試:Apache 2.0 許可證完全開源免費,支援 100 種以上語言與多種硬件平台;無論是 RAG 知識庫、文檔自動化或模型訓練皆可應用,87,000 顆星標與百度團隊長期維護顯示項目穩健。
出處連結有哪些?
- GitHub 儲存庫:PaddlePaddle/PaddleOCR
- 官方網站:PaddleOCR 官方網站
- 官方文件:PaddleOCR Documentation
- 技術報告:PaddleOCR 3.0 Technical Report(arXiv)