
Pathway 是由 Pathway 團隊於 2022 年底開源的即時資料框架,在 GitHub 累積 62,243 顆星標與 1,682 次複製,採用 Business Source License 授權。此框架以 Python 對外提供 API,底層交由 Rust 引擎執行基於差異化資料流(Differential Dataflow)的增量計算,讓同一份程式碼可同時跑批次任務、串流處理與 LLM 管線,最新版本為 v0.32.1。
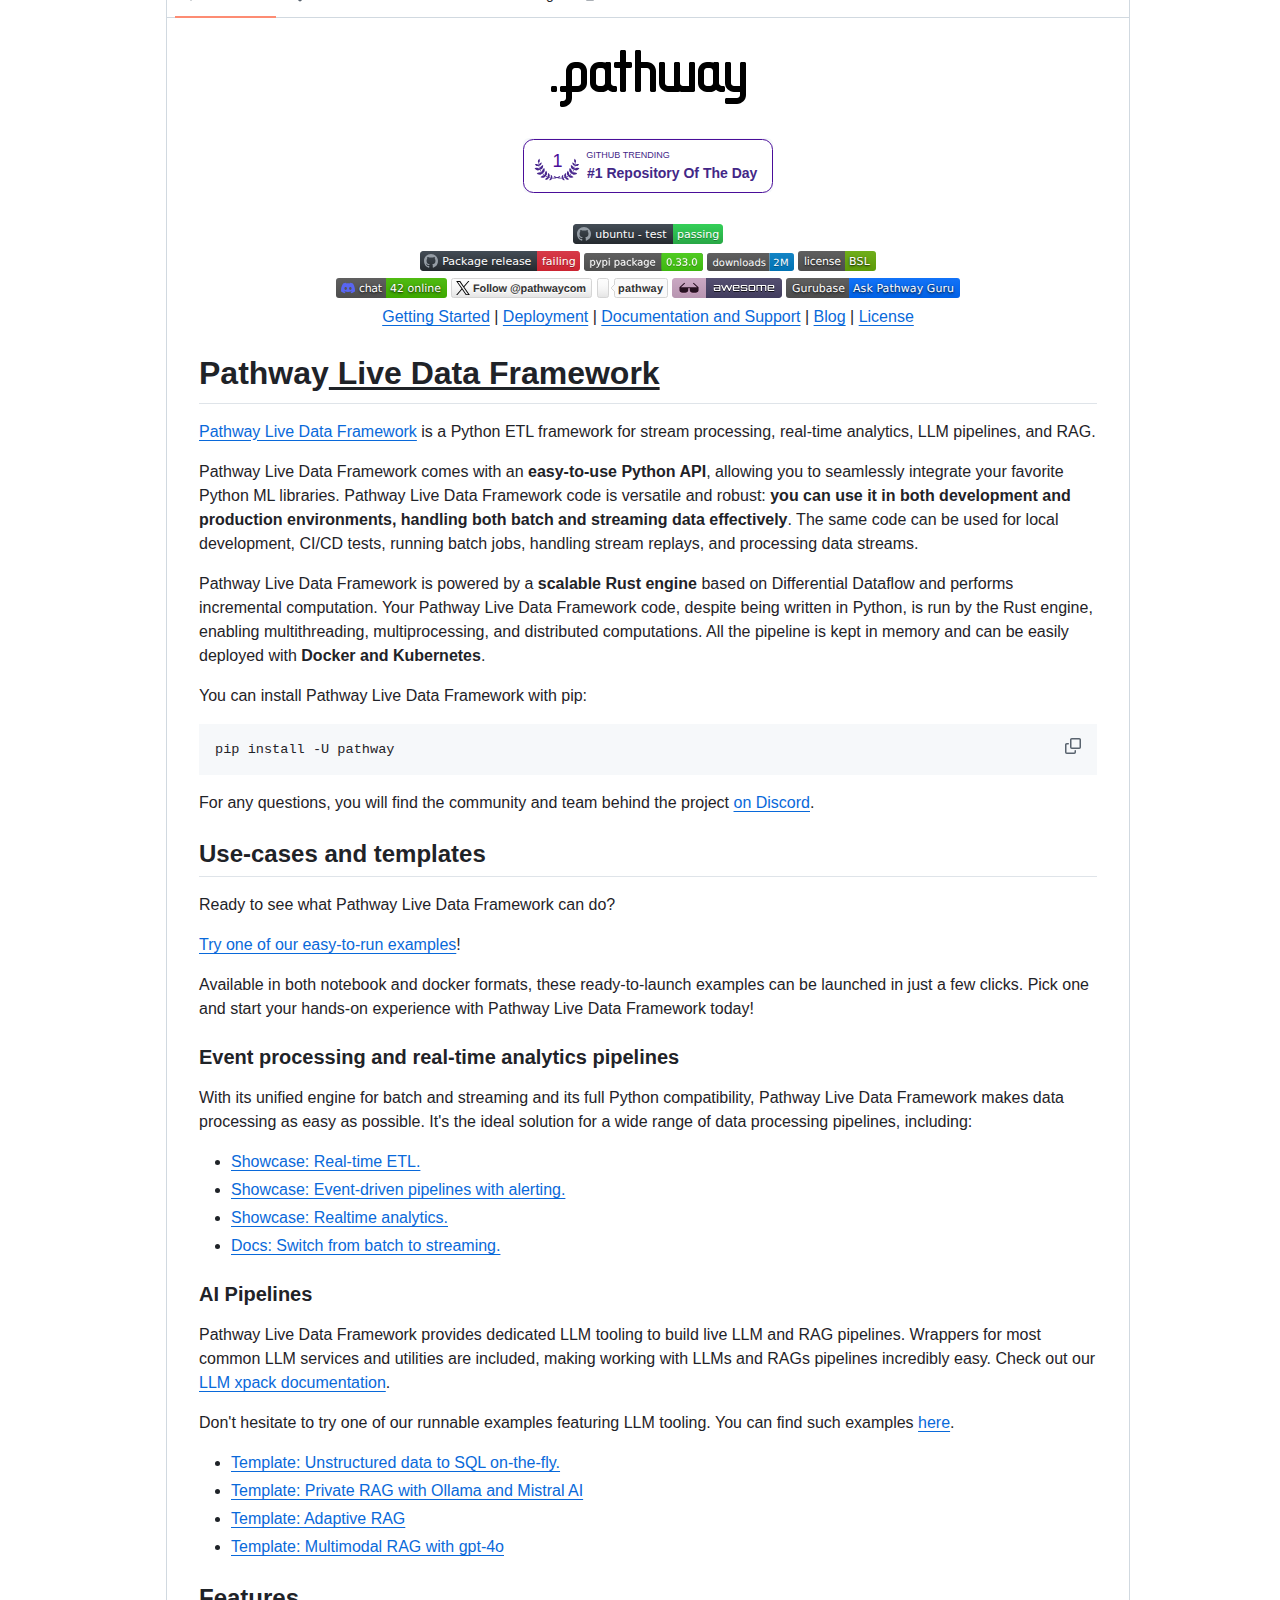
Pathway 是以 Python 撰寫的即時資料框架,底層由 Rust 引擎驅動,能同時處理批次與串流,並內建 LLM 與 RAG 工具鏈,可連接 Kafka 等資料源。
資料工程的長期痛點在於批次與串流被拆成兩套技術棧。離線分析用 Spark 或 pandas,即時管線用 Flink 或 Kafka Streams,同一段商業邏輯往往要維護兩份實作,測試與除錯成本也隨之倍增。Pathway 試圖用單一抽象抹平這道界線,開發者只需要描述資料如何流動,引擎自行處理增量更新。
Pathway 是什麼?
Pathway 是 Python 的即時資料框架,把資料視為持續更新的資料表。開發者以 Python 定義轉換與連接器,運算交由 Rust 引擎,涵蓋批次、串流與 AI。
此框架在概念上沿用資料流模型。使用者把外部來源接成資料表,再透過 filter、join、reduce 等操作描述轉換,最後寫回外部系統。由於引擎以增量方式重算,只有變動的資料點會觸發更新,因此同一份程式碼在批次模式下是離線運算,在串流模式下則持續輸出最新結果。
入門門檻相對低。官方範例以 CSV 讀入、過濾正數、加總後寫出 JSON Lines,全部以 Python 完成,僅需呼叫 pw.run() 啟動。框架亦提供監控儀表板,可觀察各連接器的訊息數量與系統延遲,並支援多執行緒啟動。
Pathway 的專案背景與維護模式是什麼?
Pathway 儲存庫建立於 2022 年 11 月 27 日,由 Pathway 團隊主導開發,累計約 2,270 頁提交,目前開啟議題約 38 個,並同時維護社群版與企業版。
專案起始於 2022 年底,定位從一開始就放在即時資料處理而非單純的 ETL 工具。維護工作由 Pathway 團隊主導,程式碼以 Business Source License 釋出,允許非商業用途免費使用,商業化路徑則建立在上層的企業版本。
企業版本補足了社群版缺少的能力。社群版提供「至少一次」的一致性保證,企業版則升級至「恰好一次」,並支援雲端分散式運算、Kubernetes 部署與外部持久化設定。這種「開源核心加企業加值」的結構,與近年基礎軟體專案的主流路徑一致,反映即時資料處理市場對可靠性等級的明確分層需求。
版本節奏維持穩定。最近三個版本分別於 2026 年 5 月、6 月與 8 月發布,最新的 v0.32.1 於 2026 年 8 月 1 日推出,儲存庫在 2026 年 9 月下旬仍有提交,顯示開發活動並未停滯。
Pathway 的核心技術架構有何特別?
Pathway 的引擎以 Rust 實作,基於差異化資料流做增量計算。狀態性轉換如 join、視窗與排序由 Rust 原生處理,開發者仍可用任意 Python 函式擴充。
最具辨識度的是增量運算模型。傳統串流框架要求開發者明確處理狀態與水位線,Pathway 則把整條管線保存在記憶體中,資料點進入或遲到時只重算受影響的部分。這讓時間處理由引擎統一負責,也讓亂序資料不必額外撰寫修正邏輯。
Rust 引擎承擔了原本會受 Python 效能限制的工作。多執行緒、多行程與分散式運算都在引擎層完成,使用者以 Python 撰寫的函式仍可自由呼叫機器學習函式庫。官方指出此架構能實作部分其他串流框架較難支援的演算法,例如時序 join、迭代式圖形演算法與機器學習例行程序,並附上與 Flink、Spark、Kafka Streams 對比的基準測試。
連接器生態是其落地關鍵。內建連接器涵蓋 Kafka、Google Drive、PostgreSQL 與 SharePoint,並可透過 Airbyte 連接器觸及超過 300 種資料源;若既有連接器不足,開發者可依 Python 介面自行實作。
Pathway 有哪些 LLM 與 RAG 應用場景?
Pathway 內建 LLM 擴充套件,提供模型封裝、解析器、嵌入器與切分器,並含記憶體內即時向量索引,可整合 LangChain 與 LlamaIndex 建立即時 RAG。
框架把 LLM 管線視為一般資料流的一部分。官方提供的工具包含 LLM 服務封裝、輸出解析器、嵌入模型與文件切分器,並內建記憶體內的即時向量索引。當來源文件更新時,索引隨資料流同步更新,回覆用的檢索結果因此維持在最新狀態,不需要另外執行批次重建索引的排程。
官方範例覆蓋數種常見情境,包括把非結構化資料即時轉為結構化 SQL、以 Ollama 與 Mistral 建立的私有 RAG、依查詢難度調整策略的自適應 RAG,以及結合影像與文字的多元模態 RAG。這些範例同時提供 notebook 與 Docker 版本,可縮短從評估到驗證的時間。
對 RAG 系統而言,即時性往往比模型選擇更難處理。多數實作以離線索引搭配定時重建,文件異動與可檢索狀態之間存在時間差;Pathway 的做法是把這段落差納入資料流本身,讓索引與來源維持一致。
Pathway 的效能與部署方式如何?
Pathway 以增量計算與 Rust 引擎追求效能,官方提供與 Flink、Spark 對比的基準測試。部署支援本機、Docker 與企業分散式版。
效能主張有其明確對照對象。官方在專案說明中直接點名 Flink、Spark 與 Kafka Streaming,並提供獨立的基準測試儲存庫供實際重現,測試內容包含常見的詞頻統計等工作負載。這種把效能數字公開可驗證的做法,在資料框架領域並不多見。
部署選項涵蓋多種規模。開發階段只需以 pip 安裝後執行 Python 腳本,或以 pathway spawn 指定執行緒數;容器化情境可直接使用官方 Docker 映像,或改用標準 Python 映像安裝套件。要擴展到分散式運算時,則需搭配企業版於 Kubernetes 上部署。
平台支援範圍需留意。框架支援 Python 3.10 以上版本,但目前僅提供 macOS 與 Linux 版本,其他作業系統的官方建議是先透過虛擬機執行,再部署到目標環境。
Pathway 的數據規模如何?
- 62,243Stars
- 1,682Forks
- BSLLicense
- Python / Rust主要語言
- v0.32.1最新版本
- 2026-09-24最近更新
Pathway 在 GitHub 累積 62,243 顆星標與 1,682 次複製,採 BSL 授權,以 Python 為主要語言、Rust 為運算核心,最新版 v0.32.1。
出處連結有哪些?
本文資訊整理自 Pathway 的 GitHub 儲存庫與官方文件。專案原始碼、範例與基準測試資料均可於官方倉庫查閱,網站位於 pathway.com。
專案原始碼與完整說明位於 github.com/pathwaycom/pathway,開發者文件與 API 參考則發布於 pathway.com。
總結:Pathway 適合什麼團隊?
Pathway 適合需要同時處理批次與串流、又希望以 Python 維持單一程式碼庫的團隊,尤其是要把 LLM 檢索即時化的資料工程與 AI 應用團隊。
Pathway 的價值在於收斂技術棧。當團隊同時要維護離線報表與即時告警,往往得在兩套框架間複製商業邏輯;此專案以單一資料流模型與 Rust 引擎承接兩端,並把即時向量索引納入同一條管線,為需要即時檢索的 AI 應用提供現成基礎。
選擇前需要評估兩點。其一,授權採 BSL,若屬商業用途需先確認適用條款,恰好一次一致性亦需企業版支援;其二,平台目前限於 macOS 與 Linux。對於以 Python 為主要開發語言、且即時性要求明確的團隊,此專案值得列入評估清單。