
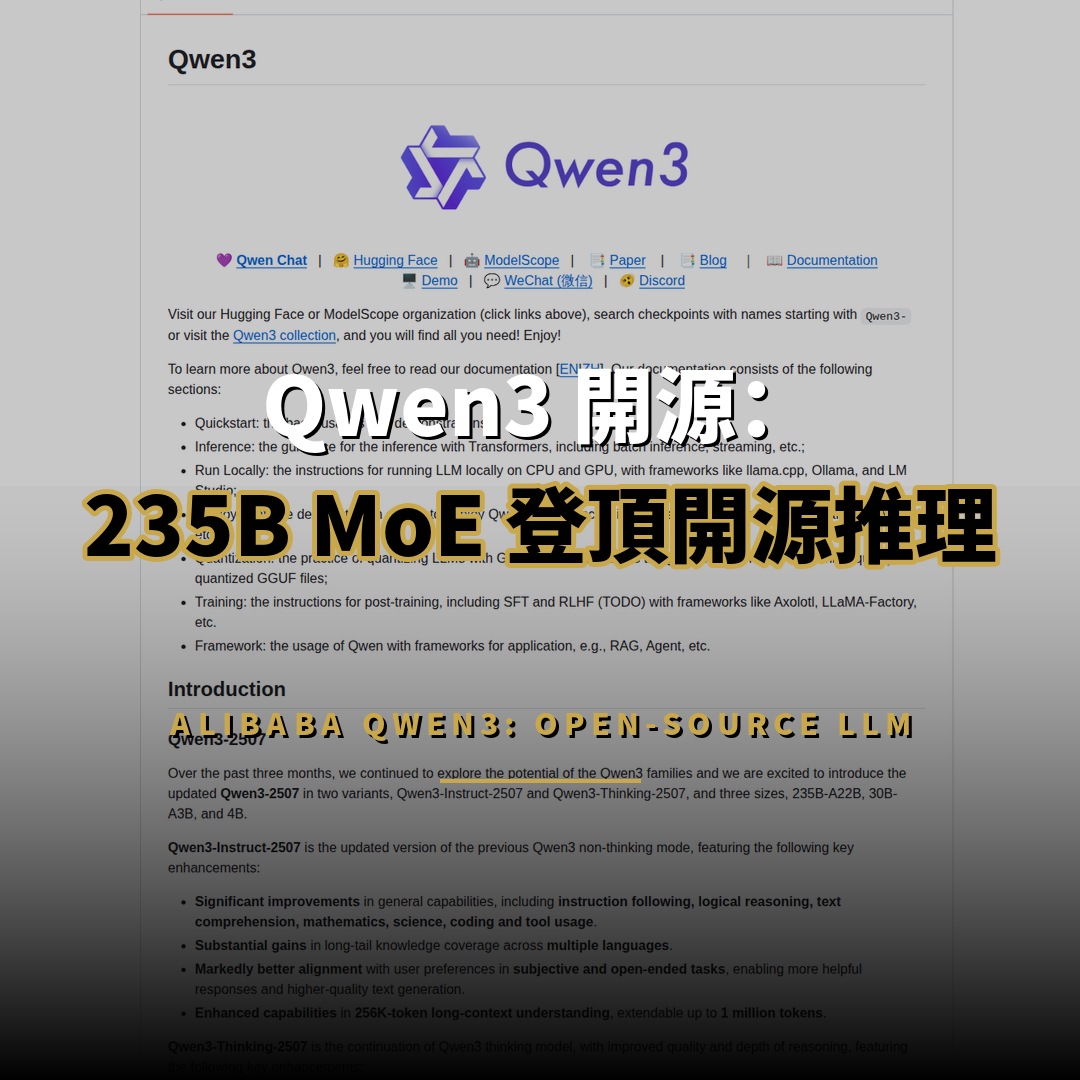
Qwen3 是阿里巴巴雲端旗下 Qwen 團隊開發的新一代開源大語言模型系列,目前在 GitHub 上累積超過 2.7 萬顆星標,並持續獲得社群關注。該系列涵蓋從 0.6B 到 235B-A22B 的多種參數規模,首度將「思考模式」與「非思考模式」整合於同一模型,並以 Apache 2.0 授權完全開放權重,成為開源模型生態中架構最完整的系列之一。
Qwen3 是阿里巴巴的開源大語言模型系列,涵蓋 0.6B 至 235B-A22B 規模,支援思考與非思考模式切換。
Qwen3 是什麼?
Qwen3 是阿里巴巴雲端 Qwen 團隊於 2025 年 4 月正式發布的開源大語言模型系列,延續 Qwen、Qwen1.5、Qwen2 與 Qwen2.5 的技術脈絡,是該團隊迄今最完整的模型家族。系列同時提供稠密(Dense)與混合專家(MoE)兩種架構,參數規模覆蓋 0.6B、1.7B、4B、8B、14B、32B、30B-A3B 與 235B-A22B,從輕量端側部署到大型伺服器推理皆有對應選擇。
Qwen3 提供稠密與 MoE 兩種架構、七種以上規模,並以 Apache 2.0 完全開放權重,允許免費商用。
與前代 Qwen2.5 相比,Qwen3 最大的結構性變革在於引入統一的「混合思考」設計。模型預設先進行思考再回應,使用者亦可透過參數或指令關閉思考流程,切換為快速直出模式。這種設計讓同一模型同時勝任複雜推理與高效率對話兩種截然不同的使用情境。
Qwen3 的技術架構有什麼創新?
Qwen3 的核心創新在於將思考模式與非思考模式整合進單一模型。思考模式下,模型會生成完整的推理鏈,適合數學證明、程式除錯、複雜邏輯分析等任務;非思考模式下則直接輸出答案,延遲更低、吞吐更高,適合一般對話與輕量任務。兩種模式之間可以透過系統提示詞或 API 參數無縫切換,不需重新載入模型。
其架構創新在於單一模型同時支援思考與非思考兩種模式,可依任務複雜度即時切換,並支援 256K 長上下文與多語言能力。
模型採用混合專家的 MoE 設計,其中旗艦版本 235B-A22B 具備 2350 億總參數,每次推理僅啟動 220 億參數,兼顧模型容量與運算效率。官方數據顯示,Qwen3 在數學、程式碼生成、常識推理等基準測試上全面超越前代 QwQ 與 Qwen2.5 Instruct 系列,尤其 MoE 版本在單位運算成本下的表現更具競爭力。
此外,Qwen3 支援 100 種以上語言與方言的指令遵循與翻譯,並在代理(Agent)任務中達到開源模型的領先水準,可整合外部工具進行多步驟操作。2025 年 7 月發布的 Qwen3-2507 更新版進一步強化推理能力,在多項需要人類專家水準的學術基準上取得開放權重思考模型的最佳成績。
Qwen3-2507 更新帶來了什麼?
Qwen3-2507 是 2025 年 7 月至 8 月陸續釋出的系列更新版,分為 Instruct 與 Thinking 兩個變體,提供 235B-A22B、30B-A3B 與 4B 三種規模。Instruct 變體在指令遵循、邏輯推理、文本理解、數學、科學、程式設計與工具使用等全面能力上顯著提升,並強化多語言長尾知識覆蓋與主觀開放式任務的使用者偏好對齊。
Qwen3-2507 是 2025 年更新版,分 Instruct 與 Thinking 兩個變體,強化推理、程式設計與多語言能力。
Thinking 變體則專注於推理品質的深化,在邏輯推理、數學、科學與程式設計等任務上取得開放權重思考模型的領先成績,並支援更長的思考鏈。兩者皆具備 256K token 的長上下文理解能力,官方並於 2025 年 8 月開放 100 萬 tokens 的極長輸入支援,可直接處理整本技術書籍或大型程式碼庫。
Qwen3 支援哪些部署框架?
Qwen3 的部署生態相當完整,官方文件涵蓋 Transformers、llama.cpp、Ollama、LM Studio、MLX、OpenVINO 與 ExecuTorch 等本地執行方案,以及 vLLM、SGLang、TensorRT-LLM 等高效能伺服器框架。使用者可以根據硬件配置選擇從輕量 GGUF 量化檔案到全精度 MoE 部署的不同路徑。
支援 Transformers、llama.cpp、Ollama、LM Studio 等本地框架,以及 vLLM、SGLang 等伺服器框架。
透過 Ollama 或 llama.cpp,一般開發者只需數行指令即可在本機執行 8B 等中輕量版本,Apple Silicon 用戶則可使用 MLX 取得優化效能。企業級部署方面,vLLM 與 SGLang 均提供 OpenAI 相容 API,TensorRT-LLM 則針對 NVIDIA GPU 進行深度優化,支援自訂 attention kernel 與量化加速。
Qwen3 的許可證與商業化路徑如何?
Qwen3 全系列模型均以 Apache 2.0 授權釋出,允許商用、修改與再發布,是開源模型生態中許可證最寬鬆的選擇之一。阿里巴巴同步提供雲端 API 服務與 ModelScope 模型平台,中國大陸使用者可透過 ModelScope 快速下載,海外則以 Hugging Face 為主要發佈渠道。
全系列以 Apache 2.0 釋出,允許免費商用與修改;阿里同時提供雲端 API,形成開源權重與託管服務並行的雙軌商業模式。
這種「開放權重+雲端託管」的策略,與 OpenAI、Anthropic 等封閉模型路線形成鮮明對比,也讓 Qwen3 在開源社群與企業自建部署市場中佔有獨特位置。對於需要完全掌控資料隱私或希望降低推理成本的團隊,Apache 2.0 授權意味著可以自由將模型整合進商業產品,無需支付授權費用。


出處連結有哪些?
本篇文章的資料來源為 Qwen3 官方 GitHub 儲存庫,包含完整的模型介紹、技術文件、部署指南與更新紀錄。讀者可以直接前往儲存庫查看原始內容,並追蹤後續模型版本的發布動態。
Qwen3 的官方資料來源為 GitHub 儲存庫 QwenLM/Qwen3,內含完整 README、部署文件與版本更新紀錄,是查閱模型細節的第一手渠道。
總結:Qwen3 適合什麼團隊?
Qwen3 適合三類團隊使用:需要長上下文處理的研究機構,可運用其 256K 至 100 萬 tokens 的輸入能力進行大型文件分析;追求成本效益的商業團隊,可利用 MoE 架構以較低運算成本取得旗艦級能力;以及需要完全控制部署環境的企業,可依 Apache 2.0 授權自由整合與客製。
適合需長上下文、成本效益或自主部署的團隊:Apache 2.0 免除商用限制,MoE 架構降低推理成本,並可完整本地運行。
隨著 Qwen3-2507 持續更新與生態框架逐步完善,Qwen3 已成為開源大語言模型領域最具代表性的系列之一,其技術路線與商業模式亦為後續開源模型專案提供了重要參考。