
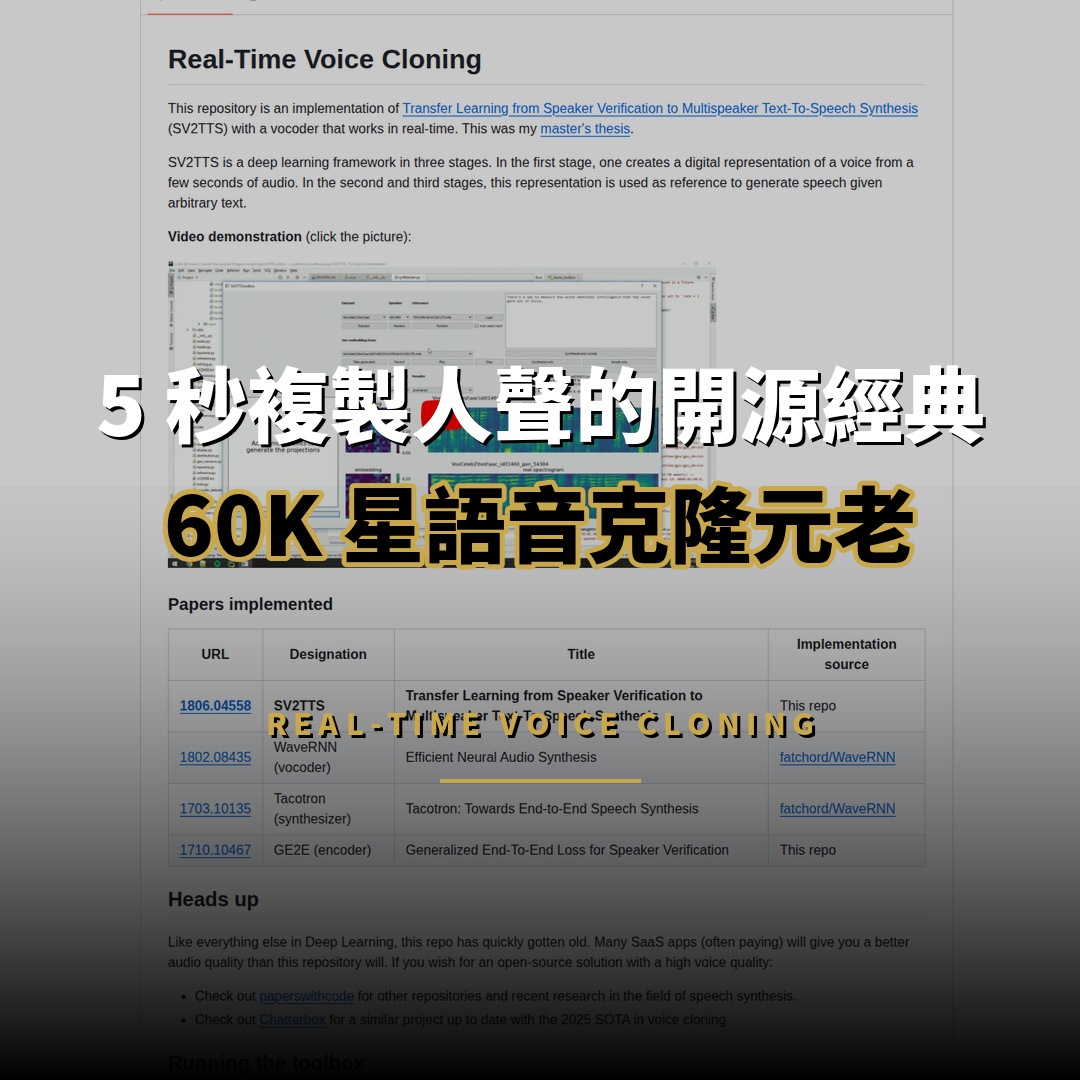
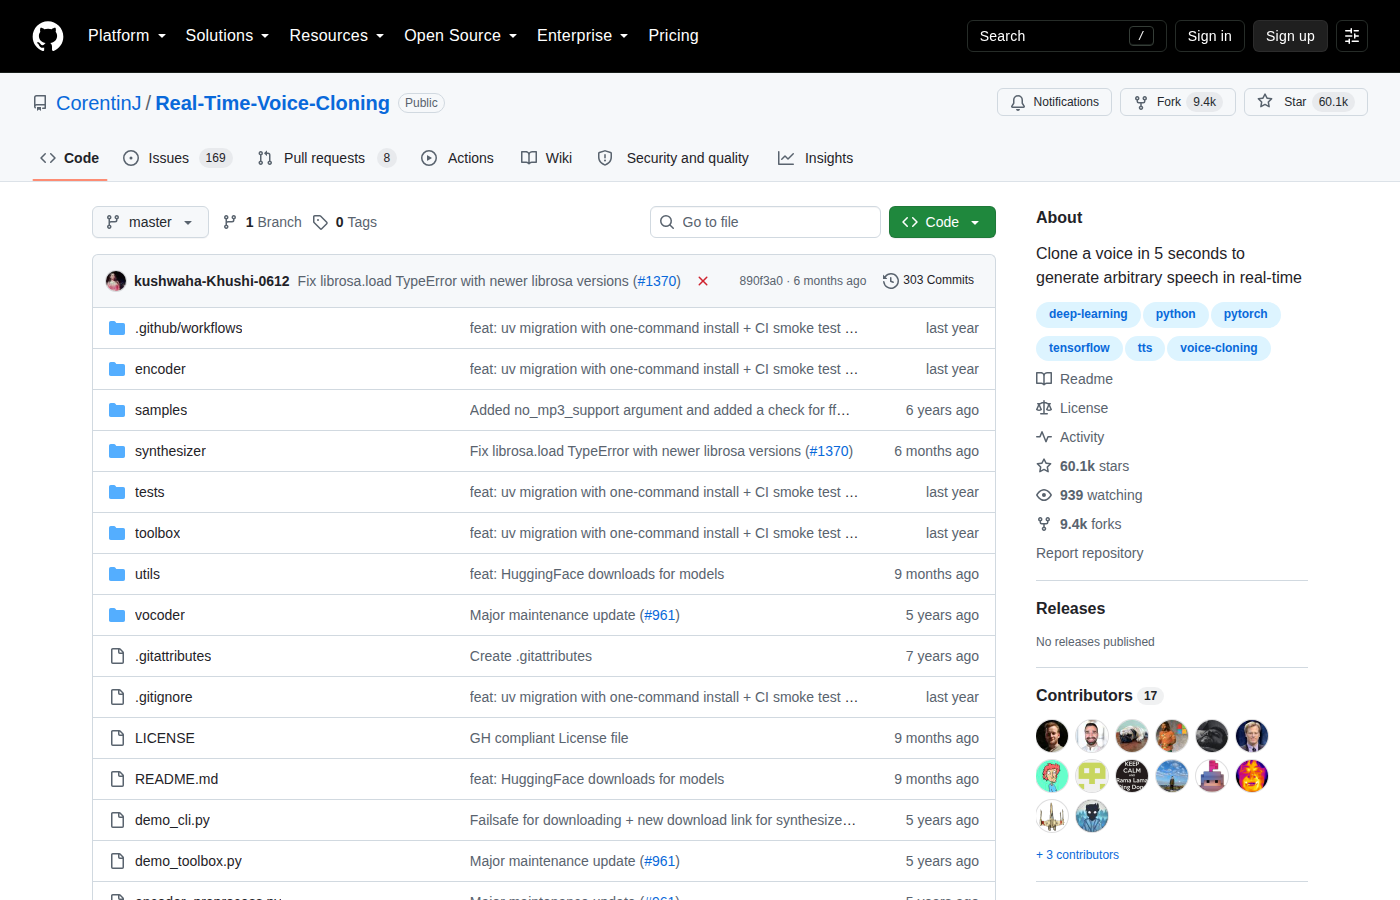
Real-Time-Voice-Cloning 是一套以「5 秒音檔複製人聲」著稱的開源語音克隆工具,由開發者 CorentinJ 基於 SV2TTS(Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis)架構實作,目前於 GitHub 擁有 60,126 星標與 9,390 個複製分支,是語音合成領域最具代表性的經典項目之一。
Real-Time-Voice-Cloning 是 SV2TTS 語音克隆工具,5 秒音檔即可複製人聲並即時合成,星標 60,126,屬經典開源項目。
Real-Time-Voice-Cloning 是什麼?
Real-Time-Voice-Cloning 是基於 SV2TTS 論文實作的開源語音克隆項目,由 CorentinJ 發佈,用數秒音檔即可複製人聲。
該項目最初是開發者 CorentinJ 在比利時列日大學的碩士論文實作,將《Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis》這篇論文的方法完整落地,再整合即時神經聲碼器,令語音克隆不再局限於離線批次處理,而是可以即時生成。2019 年發佈後迅速成為 GitHub 熱門項目,至今仍維持逾 6 萬星標,長期位居語音合成開源工具的第一梯隊。
SV2TTS 架構如何實現 5 秒複製人聲?
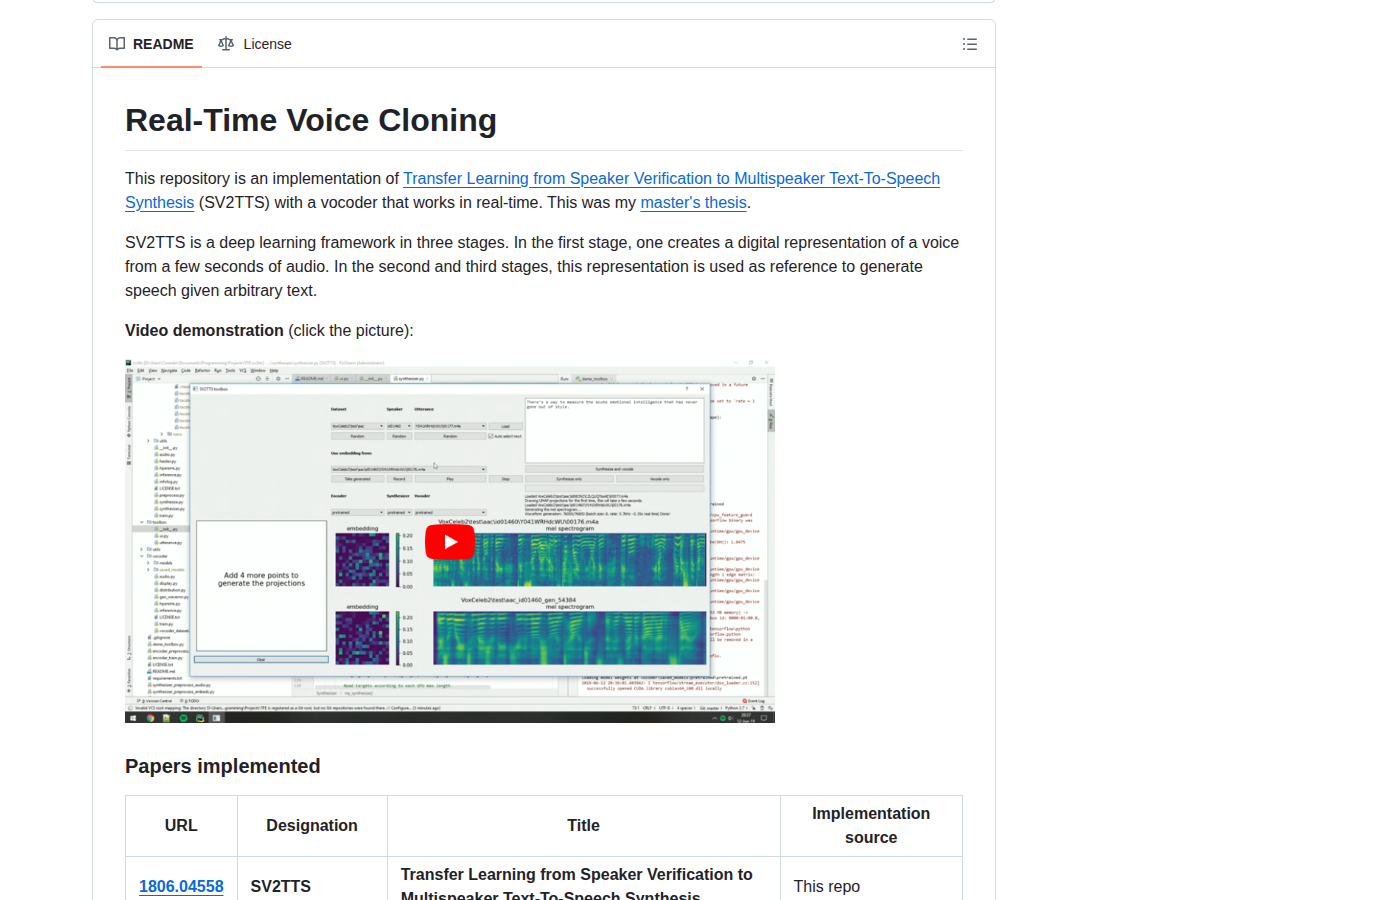
SV2TTS 分三階段:GE2E 編碼器從數秒音檔提取說話者表徵,Tacotron 依文字生成語譜,WaveRNN 聲碼器即時轉為音訊。
SV2TTS 的核心設計是「說話者驗證與語音合成的遷移學習」。第一階段是 GE2E(Generalized End-To-End)說話者編碼器,負責從長度僅數秒的參考音檔中,提取一段足以代表該說話者音色的嵌入向量;第二階段是 Tacotron 合成器,輸入文字內容與該嵌入向量,生成對應的梅爾頻譜;第三階段是 WaveRNN 聲碼器,將頻譜即時轉換為高品質音訊波形。整個流程將「聲音特徵」與「文字內容」分離處理,因此只需要一段短音檔,就能套用到任意新文字上。
這種三階段分工的設計在當時極具前瞻性:說話者編碼器不直接參與文字轉語音的生成,而是以遷移學習方式提供音色條件,令模型無需為每個新說話者重新訓練。這正是「5 秒複製人聲」背後的技術邏輯,也是後來眾多語音克隆方案沿用的基礎框架。
Real-Time-Voice-Cloning 有哪些核心技術亮點?
亮點包括即時 WaveRNN 聲碼器、預訓練模型自動下載免訓練可用、三階段架構成教學範本,並支援 Windows 與 Linux。
第一個亮點是即時合成能力。項目整合 WaveRNN 聲碼器,相較早期需要批次生成的聲碼器,可以在互動介面中即時輸出語音,這是 2019 年同類開源項目中少見的表現。第二個亮點是開箱即用:預訓練模型現已改為自動下載,使用者只需安裝 ffmpeg 與 uv,即可執行工具箱或命令列介面,不必自行訓練模型。第三個亮點是教學價值,README 中完整列出 SV2TTS、WaveRNN、Tacotron 與 GE2E 四篇論文對照表,將論文實作與原始文獻一一對應,令該項目長年作為語音合成課程的參考實作。
如何快速開始使用 Real-Time-Voice-Cloning?
安裝只需三步:先裝 ffmpeg,再裝 uv 套件管理器,然後執行 demo_toolbox.py 或 demo_cli.py,GPU 用 cuda 版,一般裝置用 cpu 版。
官方提供的啟動流程相當簡潔。首先安裝 ffmpeg,用於讀取音訊檔案;其次安裝 uv 作為 Python 套件管理器;最後執行 uv run --extra cuda demo_toolbox.py(NVIDIA GPU)或 uv run --extra cpu demo_toolbox.py,即可開啟圖形化工具箱;若不需介面,可改用 demo_cli.py 以命令列方式執行。uv 會自動建立虛擬環境並安裝依賴,預訓練模型亦會於首次執行時自動下載,整體安裝成本遠低於同期的語音克隆方案。
Real-Time-Voice-Cloning 的音質表現如何?
以 2026 年標準衡量,其音質已落後於商業方案;README 亦建議追求高品質的使用者參考 Chatterbox 等新項目。
項目作者在 README 中毫不避諱地指出,深度學習領域變化迅速,這個儲存庫「已經老去」,許多付費 SaaS 服務能提供更好的音質。對於追求高品質語音的使用者,作者建議參考 paperswithcode 的語音合成研究進展,或改用具備 2025 年最新技術水準的 Chatterbox 項目。這種誠實的自我定位,反而讓該項目在教學與研究價值上更加清晰:它保留了三階段語音克隆最完整的參考實作,適合理解原理與演算法演進,而非追求當前最佳音質的生產環境。
Real-Time-Voice-Cloning 擁有 60,126 星標與 9,390 分支,2019 年發佈,Python 撰寫,基於 SV2TTS,5 秒音檔即可複製人聲。
Real-Time-Voice-Cloning 適合什麼團隊?
該項目適合學習語音合成原理的學生與研究者、想理解 SV2TTS 的開發者,以及需要離線基礎語音克隆的個人使用者。
從生態定位來看,Real-Time-Voice-Cloning 的價值在於經典與教學。對學生與研究者而言,它是理解語音克隆三階段架構的最佳實作範本,論文與程式碼一一對應,學習路徑清晰;對開發者而言,讀懂這套程式碼,幾乎等於掌握現代語音克隆的核心概念;對需要離線、免付費基礎語音克隆的個人使用者,它依然可用。反觀追求最新音質與多語言能力的生產團隊,則應考慮 Chatterbox、GPT-SoVITS 或商業雲端服務。
出處連結有哪些?
本文資訊來源為 CorentinJ/Real-Time-Voice-Cloning 的 GitHub 儲存庫,包括其 README、論文對照表、安裝說明與維護紀錄。
本文章內容整理自 Real-Time-Voice-Cloning 官方儲存庫與相關論文。有興趣的讀者可前往以下連結獲取原始資料:
- GitHub 儲存庫:https://github.com/CorentinJ/Real-Time-Voice-Cloning
- SV2TTS 論文:https://arxiv.org/pdf/1806.04558.pdf
- 預訓練模型:https://huggingface.co/CorentinJ/SV2TTS
總結:如何評價 Real-Time-Voice-Cloning 的歷史地位?
Real-Time-Voice-Cloning 以 60,126 星標奠定語音克隆開源元祖地位,SV2TTS 架構影響深遠;音質雖非頂尖,價值依然無可取代。
總結而言,Real-Time-Voice-Cloning 是語音克隆開源史繞不開的名字。它以一篇論文、一位碩士生與一套三階段架構,證明了「少量音檔即時複製人聲」的可行性,並以逾六萬星標留下長尾影響力。對今日的開發者來說,它未必是音質最優的選擇,卻是理解這項技術來龍去脈時,最值得閱讀的第一份原始碼。