
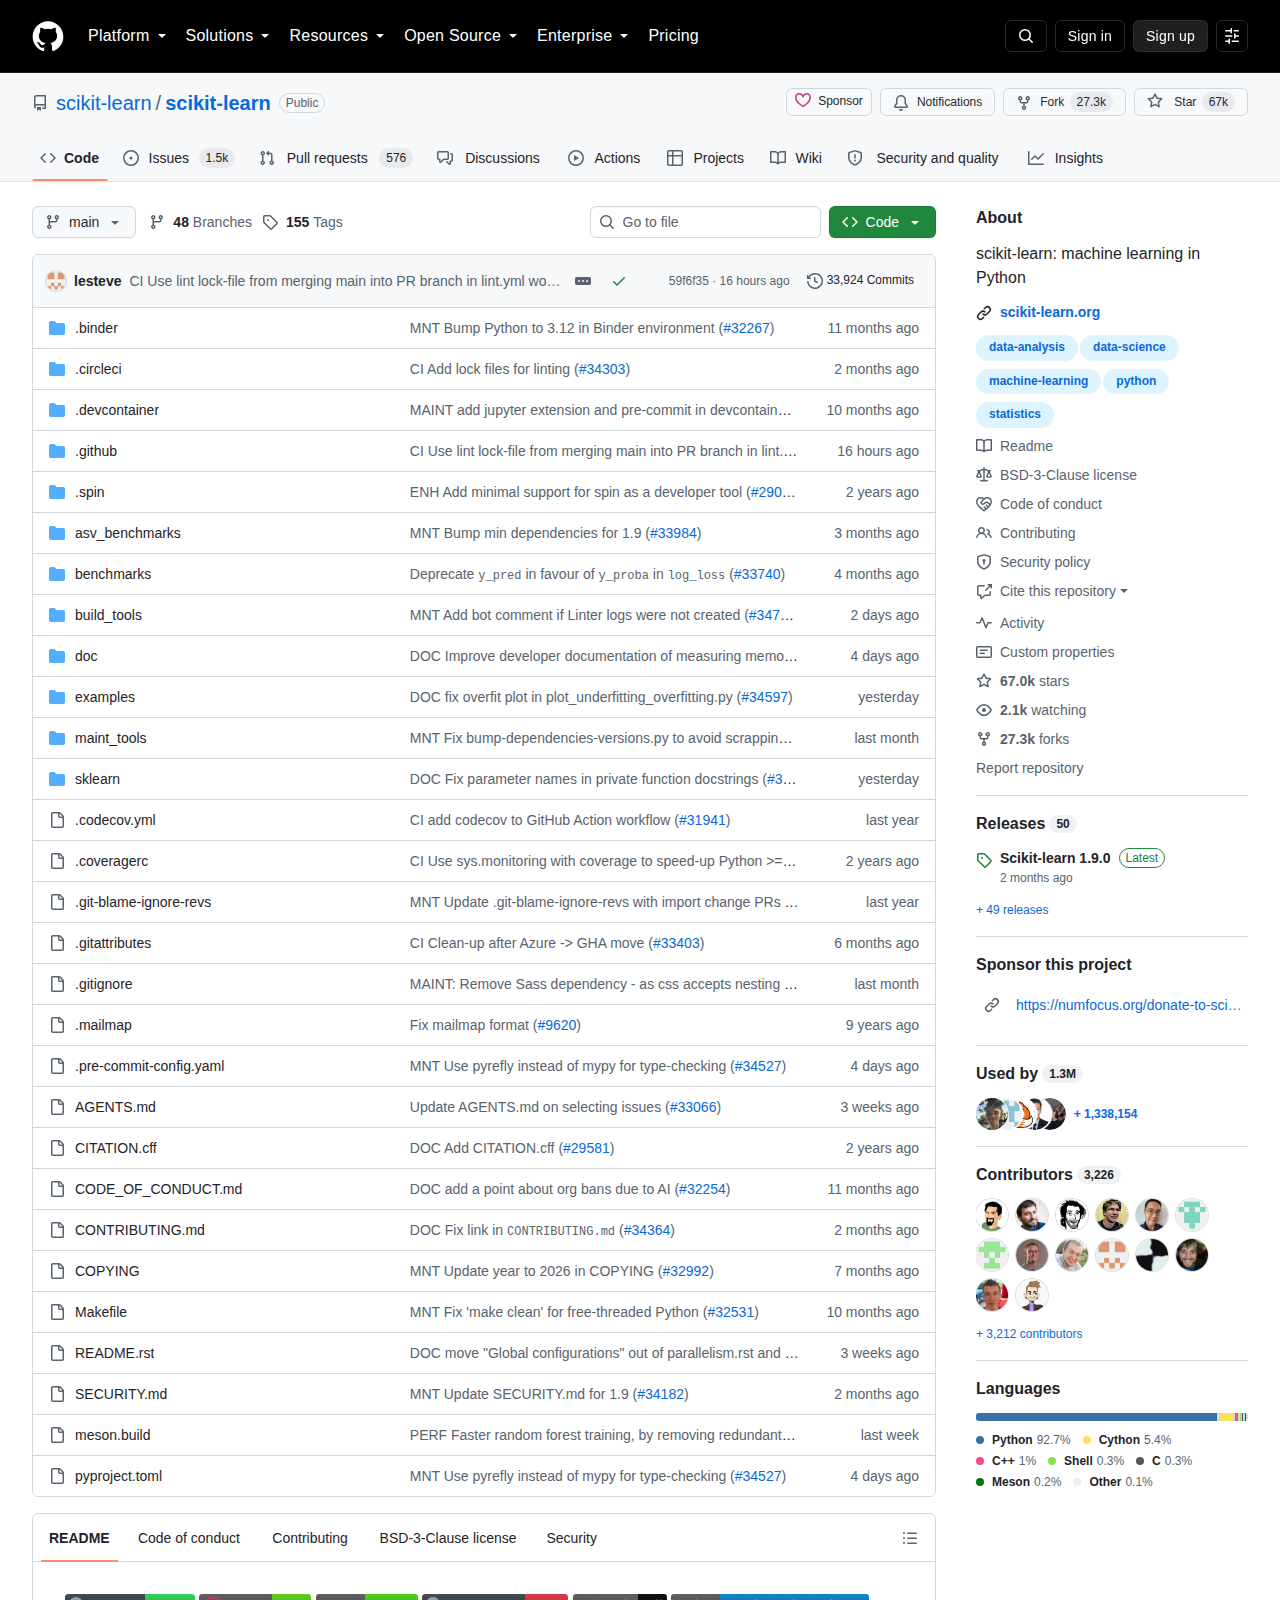
scikit-learn 是 Python 生態中最具影響力的開源機器學習函式庫,截至 2026 年 8 月累積 66,978 個星標與 27,288 個 Fork,以 BSD 3-Clause 授權開放,提供分類、回歸、聚類、降維、模型選擇與預處理等完整機器學習流程的統一 API。該項目始於 2007 年 David Cournapeau 發起的 Google Summer of Code 專案,2010 年正式在 GitHub 開源,並於 2026 年 6 月發布 1.9.0 版本,加入實驗性 Callbacks 機制與 Narwhals 資料框架互操作層,持續鞏固其作為 Python 機器學習標準工具庫的地位。
scikit-learn 是什麼?為何被譽為機器學習標準庫?
scikit-learn 是基於 SciPy 建構的 Python 開源機器學習函式庫,提供分類、回歸、聚類、降維與模型選擇的統一 API,以 BSD 3-Clause 授權免費開放,GitHub 累積逾 6.7 萬星標,是 Python 資料科學與機器學習生態中最廣泛使用的標準工具。
scikit-learn 的定位是「機器學習的標準工具庫」:開發者透過一致的 fit、predict 與 transform 介面,即可完成從資料預處理、模型訓練到評估部署的完整流程。與深度學習框架不同,scikit-learn 專注於傳統機器學習演算法與統計建模,涵蓋支援向量機、隨機森林、梯度提升、K 平均聚類與主成分分析等數十類演算法,並提供交叉驗證、網格搜尋與管線(Pipeline)機制,讓模型開發過程具備高度的標準化與可重現性。
該函式庫的影響力體現在其滲透範圍。從學術論文的方法實作、Kaggle 競賽的標準流程,到企業生產環境的模型服務,scikit-learn 幾乎無所不在。其統一的 API 設計哲學不僅降低了學習門檻,更成為後續眾多機器學習工具模仿的對象,例如多數深度學習框架與 AutoML 工具都參考了 scikit-learn 的介面慣例,這使其被譽為機器學習領域的「標準庫」實至名歸。
scikit-learn 有哪些核心技術亮點?
scikit-learn 的核心亮點包括:以 SciPy 科學計算棧為基礎的統一演算法 API、完整的模型選擇與評估工具鏈、Pipeline 管線機制,以及對 NumPy、SciPy、joblib 等底層函式庫的深度整合,讓傳統機器學習流程具備高效能與高可重現性。
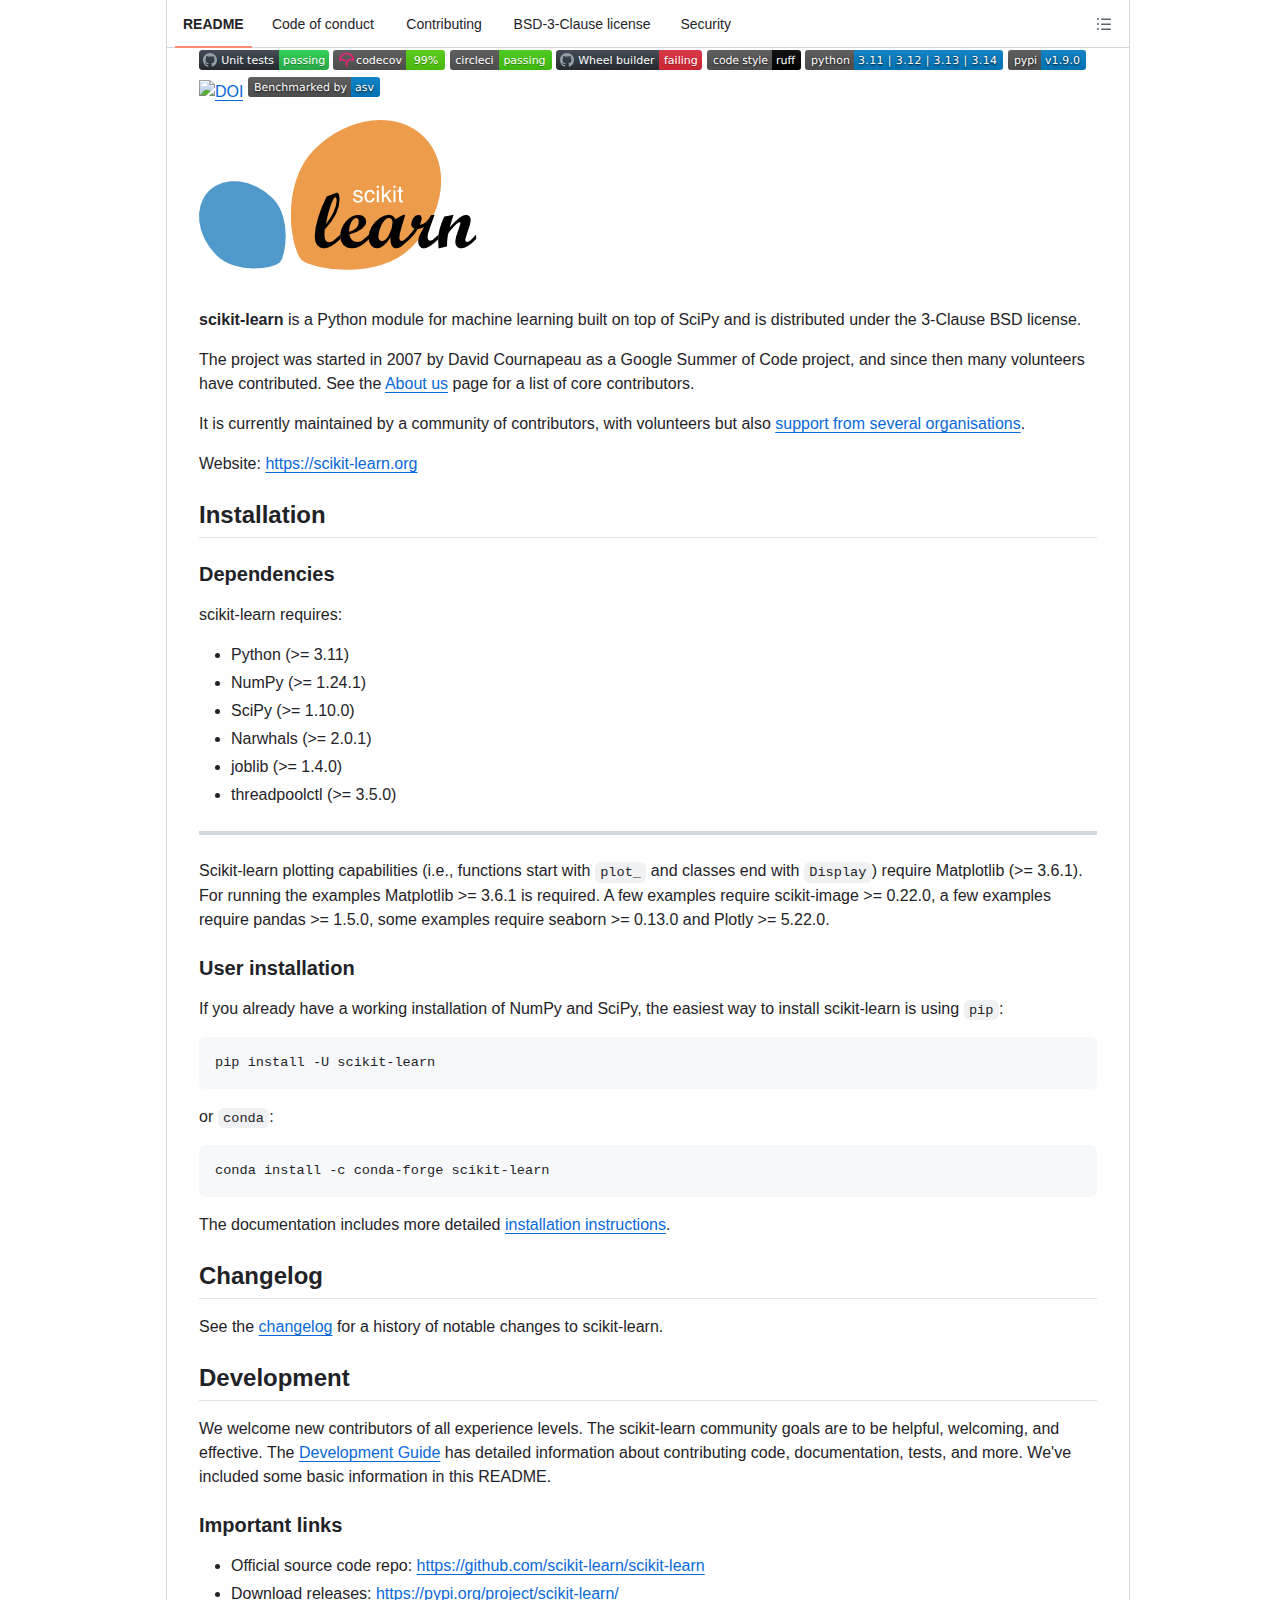
從技術架構來看,scikit-learn 構建在 Python 科學計算的基石之上。其核心依賴包括 NumPy 1.24.1 以上版本提供陣列計算基礎、SciPy 1.10.0 以上版本提供線性代數與最佳化演算法,以及 joblib 與 threadpoolctl 負責平行化執行與執行緒控制。這種「薄封裝」設計讓 scikit-learn 得以聚焦於機器學習演算法本身,同時善用底層函式庫經過高度最佳化的數值運算能力,在效能與開發效率之間取得平衡。
在功能面上,scikit-learn 覆蓋機器學習流程的每個環節。資料預處理層提供標準化、編碼、缺失值處理與特徵選擇工具;模型層提供監督式學習(分類與回歸)與非監督式學習(聚類與降維)的數十種演算法;評估層則提供交叉驗證、各種評分指標與混淆矩陣分析。其 Pipeline 機制允許將預處理與模型串接為單一物件,配合 GridSearchCV 網格搜尋即可系統化地調校超參數,這套工作流程已成為機器學習專案的業界標準模式。
值得一提的是,scikit-learn 對程式碼品質與測試的要求極高。該專案維持龐大的自動化測試矩陣,涵蓋多個 Python 版本與作業系統組合,並以 asv 基準測試工具持續追蹤效能表現,確保演算法實作的正確性與穩定性。這種嚴謹的工程文化是其得以在近二十年間維持可信度的關鍵。
scikit-learn 1.9.0 帶來了哪些新功能?
scikit-learn 1.9.0 引入實驗性 Callbacks 機制,透過 set_callbacks 註冊回呼物件以監控訓練過程,內建 ProgressBar 進度條與 ScoringMonitor 評分監控,並新增 Narwhals 依賴強化資料框架互操作性,同時支援 Python 3.11 至 3.14。
2026 年 6 月發布的 1.9.0 版本是 scikit-learn 近年最重要的功能更新之一,最引人注目的變化是實驗性 Callbacks 機制的引入。開發者可以透過 set_callbacks 方法在估計器(Estimator)上註冊回呼物件,這些物件會在 fit 訓練過程的關鍵步驟開始與結束時被呼叫,實現對訓練流程的即時監控。該版本提供兩項內建回呼:ProgressBar 用於顯示訓練進度條,ScoringMonitor 則負責計算並記錄評分指標,兩者可組合使用,且同樣適用於 GridSearchCV 等估計器組合場景。
第二項重大更新是 Narwhals 資料框架互操作層的引入。Narwhals 作為新的核心依賴,提供跨資料框架的統一介面,讓 scikit-learn 的資料輸入不再局限於 NumPy 陣列與 pandas DataFrame,未來可平滑支援 Polars 等新興資料框架,這項基礎建設反映了函式庫對現代資料生態的適應策略。
此外,1.9.0 版本將支援的 Python 版本擴展至 3.11 至 3.14,並在平行化、記憶體使用與演算法實作上進行大量修正與最佳化。版本說明強調此次更新包含眾多錯誤修正與效能改進,建議使用者透過 pip install -U scikit-learn 或 conda install -c conda-forge scikit-learn 升級至最新版本,以獲得完整的效能與穩定性改善。
scikit-learn 在開源生態中的地位如何?
scikit-learn 處於 Python 科學計算生態的核心位置,向下串接 NumPy、SciPy 等底層函式庫,向上支撐 pandas、scikit-image、seaborn 與深度學習框架的互動,其 API 慣例更成為機器學習工具的事實標準,影響力橫跨學術與產業。
scikit-learn 在開源生態中的角色是「承先啟後」的樞紐。向下,它依賴並反饋於 NumPy 與 SciPy 這兩個科學計算基石;向上,它與 pandas、scikit-image、seaborn、Plotly 等資料科學工具形成完整的協作生態,官方文件明確列出各相依函式庫的最低版本,展現對生態相容性的嚴謹管理。這種層級分明的設計讓 Python 得以成為資料科學領域的通用語言。
在競爭格局中,scikit-learn 與深度學習框架形成互補而非對立關係。TensorFlow、PyTorch 等框架擅長端對端深度學習,而 scikit-learn 則專注於傳統機器學習與模型評估,兩者在實務上經常搭配使用——開發者以 scikit-learn 進行特徵工程、基準模型與最終評估,再以深度學習框架處理複雜的結構化資料任務。這種分工使其在深度學習時代依然保有不可取代的地位。
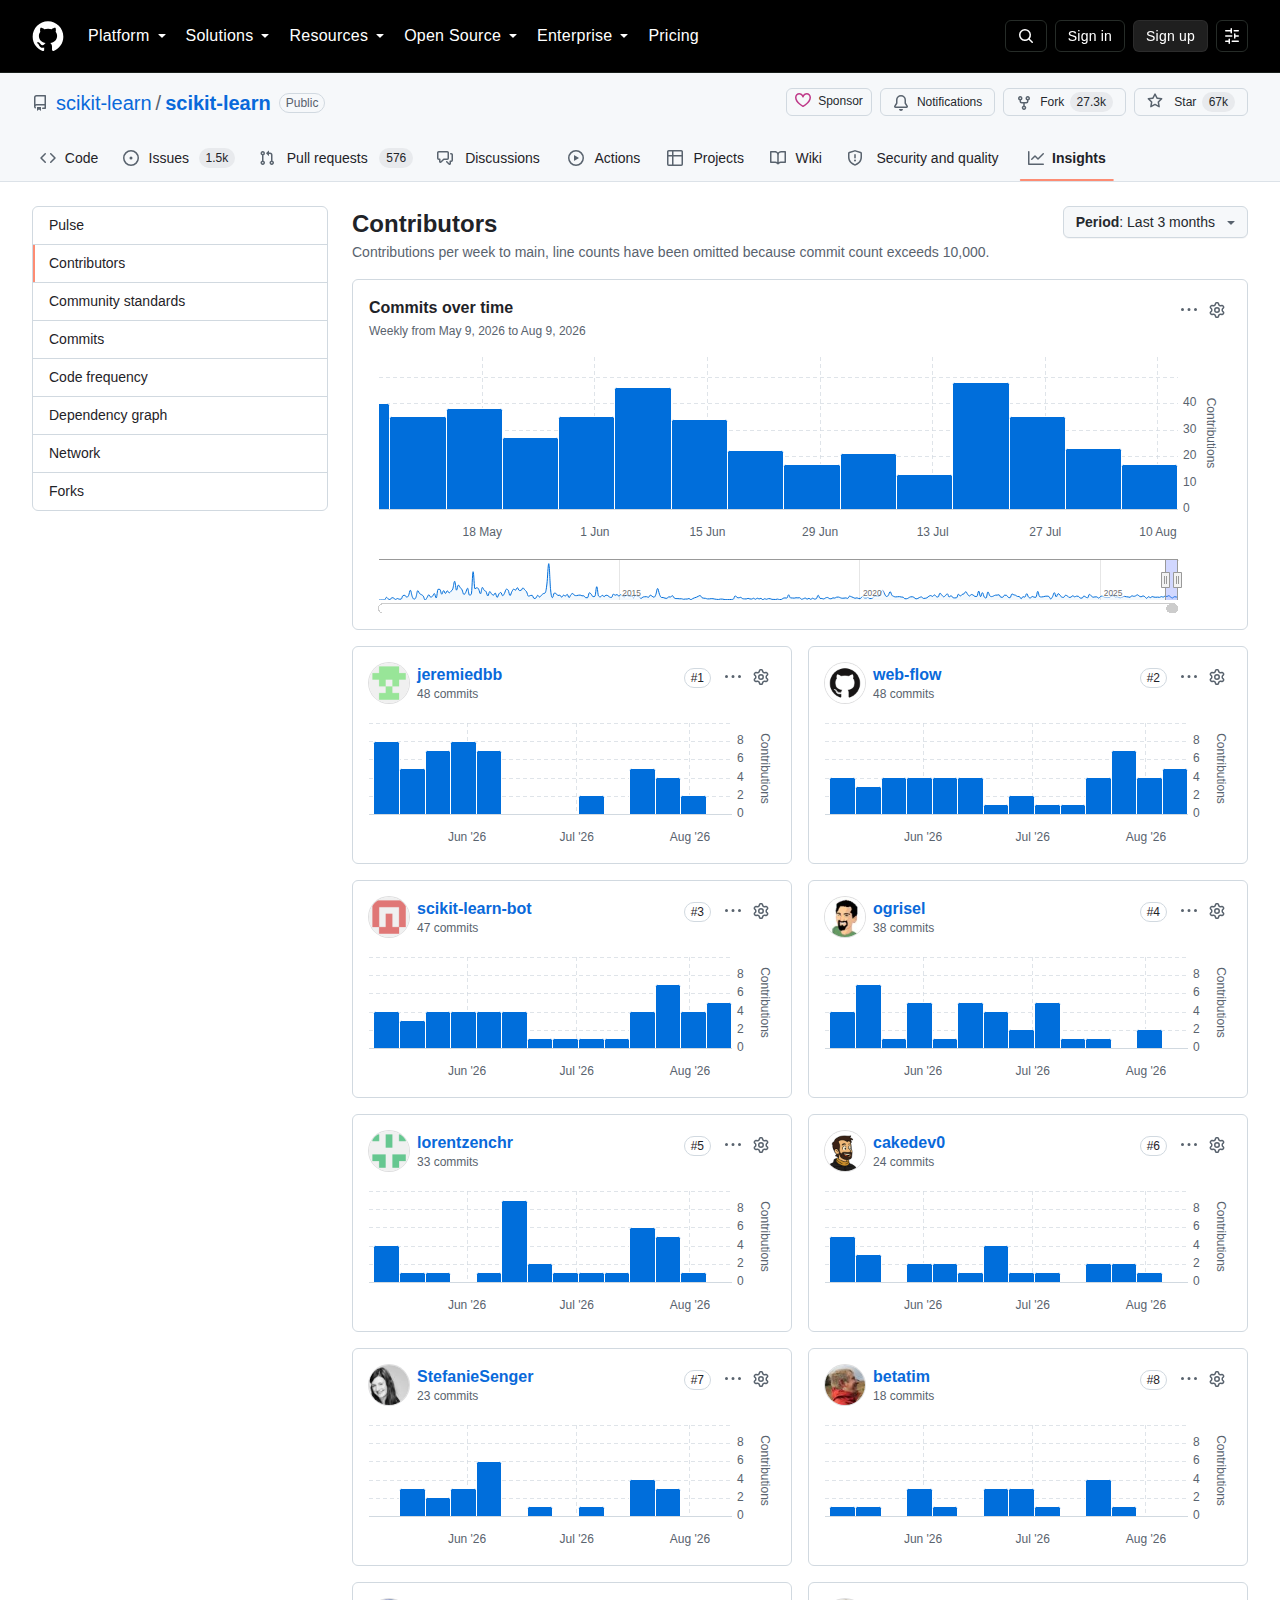
從商業化路徑來看,scikit-learn 由社群志願者與多家機構共同維護,包括法國國家資訊與自動化研究所(INRIA)等學術機構的長期支持,並獲得企業贊助。其 BSD 授權允許商業使用與修改,這使眾多企業得以將函式庫嵌入商業產品而無需公開原始碼,進一步擴大了其商業採用範圍,也解釋了為何該專案能持續吸引大量貢獻者投入維護。
如何快速開始使用 scikit-learn?
開始使用 scikit-learn 只需透過 pip install -U scikit-learn 或 conda install -c conda-forge scikit-learn 安裝,再以 from sklearn.ensemble import RandomForestClassifier 等語法匯入模組,即可在既有 NumPy 與 SciPy 環境中建構第一個模型。
開始使用 scikit-learn 的門檻相當低。若系統已安裝 NumPy 與 SciPy,只需執行 pip install -U scikit-learn 或 conda install -c conda-forge scikit-learn 即可完成安裝;若尚未具備 Python 科學計算環境,官方文件建議先安裝 Anaconda 或 Miniconda 發行版,再以 conda 指令安裝,可一次取得完整的科學計算依賴。官方文件提供詳細的安裝指南,涵蓋 Windows、macOS 與 Linux 各平台。
安裝完成後,使用流程遵循統一的模式:以 from sklearn.datasets import load_iris 載入資料集,以 from sklearn.model_selection import train_test_split 分割訓練與測試資料,再以 from sklearn.ensemble import RandomForestClassifier 匯入模型並呼叫 fit 與 predict 方法。這種一致性的 API 設計讓開發者只需熟悉一種模式,即可操作所有演算法,大幅降低學習成本。
對於剛接觸機器學習的讀者,官方網站 scikit-learn.org 提供完整的教學課程(Tutorials)與超過千個可執行範例,涵蓋從基礎分類到複雜管線的各類應用場景。官方文件更以「Getting Started」指引引導新手逐步建立第一個模型,並提供大量視覺化範例,幫助學習者理解演算法的行為與參數的影響,是系統化學習機器學習的最佳起點之一。
scikit-learn 值得一試嗎?
scikit-learn 值得一試。它以成熟的演算法實作、統一的 API、嚴謹的測試文化與 BSD 開源授權,兼顧教學學習與生產應用需求,尤其適合希望建立機器學習基礎、進行快速原型驗證或建構傳統機器學習管線的開發者與團隊。
綜合評估,scikit-learn 的價值建立在「成熟、標準、開放」三項特質之上。作為歷經近二十年發展的專案,其演算法實作經過大量學術與產業場景驗證,穩定性與正確性皆有保障;統一的 API 慣例降低了學習與協作成本,讓團隊能以一致的語言溝通模型設計;BSD 授權則確保了商業使用的自由,使企業可以安心地將其嵌入生產系統。
當然,scikit-learn 並非萬能工具。對於需要端對端深度學習、大規模分散式訓練或即時推理的場景,仍需搭配 TensorFlow、PyTorch、Spark MLlib 等專用框架;其資料處理能力亦不如 pandas 與 SQL 生態靈活。但作為機器學習的「瑞士軍刀」,scikit-learn 在傳統機器學習與模型評估領域的地位短期內難以被取代,是每一位 Python 開發者都值得掌握的基礎工具。
出處連結有哪些?
本文章內容整理自 scikit-learn 官方開源項目 scikit-learn/scikit-learn,以 BSD 3-Clause 授權開放,星標與版本資訊會隨時間變動,讀者可前往官方 GitHub 頁面與文件網站查閱最新內容。
本文章內容整理自 scikit-learn 官方開源項目:scikit-learn/scikit-learn(BSD 3-Clause License),官方文件位於 scikit-learn.org。數據截至 2026 年 8 月 14 日,星標數與版本資訊會隨時間變動,建議前往官方頁面查閱最新資訊。