
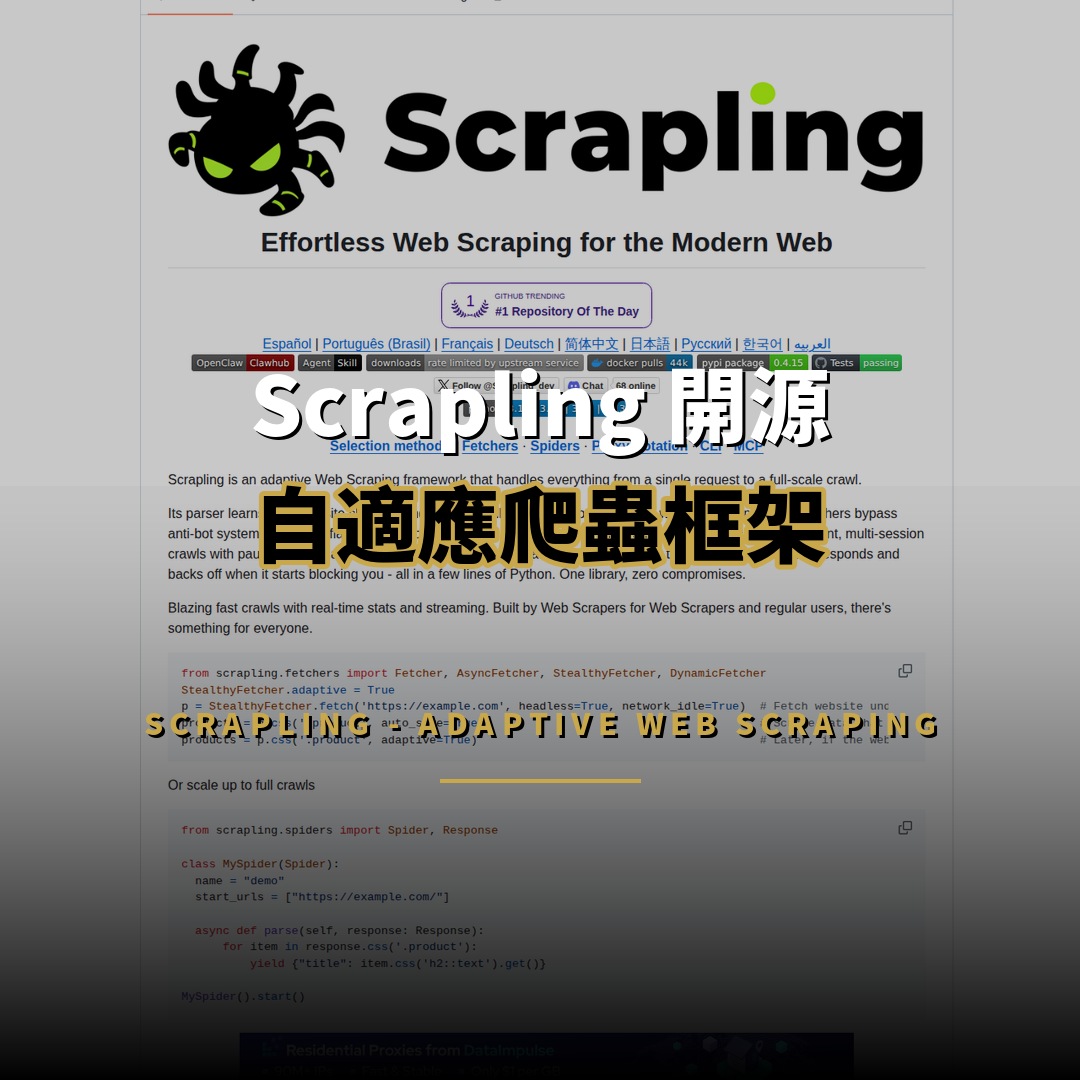
Scrapling 是一個以 BSD-3-Clause 授權發布的自適應網頁爬蟲框架,截至 2026 年 9 月初在 GitHub 累積超過 7.8 萬星標,是當前 Python 爬蟲生態中增長最快的新興工具。該框架的最大特點在於其「自適應」能力:當目標網站更改版面結構時,它能夠透過智能相似度演算法自動重新定位原本選取的網頁元素,開發者無須手動重寫 CSS 選擇器。此外,它內建的多種抓取器可繞過 Cloudflare Turnstile 與 Interstitial 等反機器人驗證,並提供完整的爬蟲框架、AI 代理整合與 RAG 資料管線能力,官方宣稱已具備 92% 的測試覆蓋率。
Scrapling 是 BSD-3 授權的開源自適應爬蟲框架,擁有逾 7.8 萬 GitHub 星標,網頁改版後自動重定位選擇器,內建繞過 Cloudflare 驗證的抓取器。
Scrapling 是什麼?
Scrapling 是由開發者 D4Vinci 於 2024 年 10 月創建的開源專案,定位為「從單一請求到全規模爬蟲」的一站式解決方案。其官方描述指出,該框架的目標是讓開發者以少量 Python 程式碼完成從單頁抓取、動態頁面渲染到全站並行爬取的完整工作流程,並同時處理代理輪換、反封鎖與速度調節等繁雜細節。

從架構上來看,Scrapling 將功能劃分為三個層次。第一層是抓取器(Fetcher)系列,包括標準 HTTP 請求的 Fetcher、支援瀏覽器自動化的 DynamicFetcher,以及具備指紋偽裝與反偵測能力的 StealthyFetcher;第二層是解析器,提供與 Scrapy 及 BeautifulSoup 相近的 API,支援 CSS、XPath、正則表達式等多種選擇方式;第三層則是完整的 Spider 爬蟲框架,支援並發限制、網域節流、暫停續爬與串流輸出。三層設計讓使用者可以根據任務規模,選擇最精簡的解決方案,而不必為小型任務引入過重的架構。
Scrapling 由 D4Vinci 於 2024 年 10 月創立,採三層架構:抓取器涵蓋 HTTP、瀏覽器與隱身模式,解析器支援多種選擇語法,Spider 提供並行續爬。
Scrapling 有哪些核心技術亮點?
Scrapling 的技術亮點主要集中在四個面向。第一是自適應選擇器,其解析器會記錄元素在頁面中的位置特徵,當網站更新版面後,透過智能相似度演算法自動尋找對應的新元素位置,官方將此功能命名為 Smart Element Tracking;第二是反封鎖能力,StealthyFetcher 可偽裝瀏覽器 TLS 指紋、模擬真實使用者行為,並宣稱能繞過 Cloudflare Turnstile 與 Interstitial 驗證,同時內建 DNS-over-HTTPS 防止 DNS 洩漏;第三是高效能設計,官方數據顯示其 JSON 序列化速度比 Python 標準函式庫快十倍,並透過延遲載入與最佳化資料結構降低記憶體佔用;第四是穩健的工程品質,全專案具備完整型別標註,並在每次變更時以 PyRight 與 MyPy 進行靜態掃描。

在進階功能方面,該框架支援背景 API 捕捉(capture_xhr),開發者可指定 URL 模式,讓框架自動收集頁面載入期間發出的 XHR 與 fetch 回應,無須逆向工程即可取得網站內部 API 資料。此外,它支援連線遠端瀏覽器(CDP)、廣告與網域封鎖(內建約 3,500 個廣告與追蹤網域清單),以及完整的非同步支援,這些設計都指向「生產環境可用的爬蟲工具」這一核心定位。
Scrapling 核心亮點:改版後自動重定位元素;StealthyFetcher 繞過 Cloudflare 驗證防 DNS 洩漏;JSON 序列化快十倍;具型別標註。
Scrapling 如何繞過反爬蟲機制?
Scrapling 的反封鎖策略採用多層防禦設計。在傳輸層,其表示層模擬(Fetcher)可偽裝瀏覽器的 TLS 指紋與 HTTP 標頭,並支援 HTTP/3 協定,讓請求在網路層面難以被辨識為自動化工具;在行為層,StealthyFetcher 則透過維持完整瀏覽器執行環境、模擬滑鼠與頁面互動模式,來通過 Cloudflare Turnstile 這類需要瀏覽器環境驗證的防護機制。
在代理管理方面,框架提供內建的 ProxyRotator,支援循環與自訂輪換策略,開發者可針對不同網域設定不同的代理來源。更值得注意的是其 AutoThrottle 機制:系統會根據目標網站回應速度自動調節請求延遲,當網站開始封鎖或限流時自動加倍等待時間(或遵循 Retry-After 回應),網站恢復正常後再加速,讓爬蟲在「不會被封鎖」與「不會過慢」之間取得平衡。加上內建的封鎖請求偵測與重試邏輯,整體設計已相當接近商業級爬蟲服務的行為模式。
Scrapling 以多層策略繞過反爬蟲:模擬 TLS 指紋與 HTTP/3,瀏覽器應對 Turnstile,內建代理輪換與 AutoThrottle,遇封鎖降速重試。
Scrapling 與 Scrapy 等其他框架有何不同?
Scrapy 長期以來是 Python 爬蟲生態的標準框架,而 Scrapling 的定位並非取代,而是互補。兩者最顯著的差異在於自適應能力:Scrapy 的選擇器在網站改版後需要開發者手動更新,Scrapling 則提供 Smart Element Tracking 自動重定位;此外,Scrapling 將反封鎖能力直接內建,而 Scrapy 通常需要額外整合 middleware 與第三方服務。
值得注意的是,Scrapling 明確設計了與 Scrapy 的相容層。開發者可以使用 scrapling_response 裝飾器,直接以 Scrapling 的解析器處理 Scrapy 已經抓取的回應,無須重寫既有程式碼。對已經投資 Scrapy 專案的團隊而言,這降低了遷移門檻;對新專案而言,Scrapling 的單一函式庫設計則省去了拼湊多個套件的成本。此外,其完整型別標註與 IPython 互動外殼(支援將 curl 命令轉換為 Scrapling 請求)也提升了開發體驗,這是傳統爬蟲框架較少提供的功能。
Scrapling 與 Scrapy 不同:自適應與反封鎖內建,改版後自動重定位選擇器,並提供 scrapling_response 裝飾器兼容既有專案。
Scrapling 有哪些 AI 整合功能?
Scrapling 是少數將 AI 代理生態納入核心設計的爬蟲框架,其整合分為三個層面。第一是 MCP 伺服器:框架提供官方 Model Context Protocol 伺服器,讓 Claude、Cursor 等 AI 代理可以透過單次或會話式工具直接執行抓取,涵蓋 HTTP 請求、瀏覽器抓取與隱身抓取三種模式,並在交給 AI 閱讀前以 CSS 選擇器收窄頁面內容、移除提示注入(prompt injection)文字,避免代理被隱藏文字劫持,同時降低 token 成本。
第二是 Agent Skill:官方提供可安裝的 Agent Skill 檔案,教導編碼代理整個函式庫的正確 API 用法,讓 AI 生成的程式碼符合目前版本介面而非憑空猜測。第三是 RAG-ready Markdown 輸出:開發者只需一行 page.markdown() 即可將任意頁面轉換為乾淨、消毒過且適合 LLM 閱讀的 Markdown,而 SiteToMarkdownSpider 範本可將整個網站轉換為 Markdown 語料庫,全程無需 LLM 參與,直接作為 RAG 系統的輸入來源。
Scrapling 提供三層 AI 整合:MCP 伺服器讓 AI 代理抓取並移除提示注入文字;Agent Skill 教 API 用法;一行可將網頁轉為 RAG 可用 Markdown。
Scrapling 的發展速度與市場定位如何?
Scrapling 自 2024 年 10 月發布以來,在不到兩年內累積超過 7.8 萬星標與 7,887 個 fork,並持續維持每日活躍更新。其 README 獲得包括 The Web Scraping Club 在內的行業媒體專文評測,並吸引大量代理服務商成為贊助夥伴,包括住宅代理、資料中心代理與反封鎖 API 供應商,顯示該專案已在爬蟲產業供應鏈中建立起商業化生態。

從市場定位來看,Scrapling 與其他開源工具的區隔在於「生產就緒」的完整度:內建代理輪換、暫停續爬、串流輸出、開發模式(首次執行快取回應、後續重播,避免反覆打擾目標伺服器)與現成的 Docker 映像檔,這些通常是企業級商業服務才提供的功能。其贊助商陣容橫跨代理、VPS 與反封鎖 API 領域,反映出開源工具透過生態合作獲取收入的典型商業化路徑。
Scrapling 上線不到兩年累積逾 7.8 萬星標,更新頻繁。其完整度近商業服務,內建代理輪換、暫停續爬與串流輸出,並吸引代理與反封鎖服務商贊助。
出處連結有哪些?
本文資訊來源為 Scrapling 的官方 GitHub 儲存庫,讀者可前往查看完整原始碼、文件與釋出紀錄。
本文資訊整理自 D4Vinci/Scrapling 的 GitHub 官方儲存庫,包含完整原始碼、文件與版本紀錄,讀者可前往查閱。
- GitHub 儲存庫:https://github.com/D4Vinci/Scrapling
- 官方文件:https://scrapling.readthedocs.io
總結:Scrapling 適合什麼團隊?
Scrapling 適合需要穩定、可擴充網頁資料管線的開發團隊,特別是那些受困於網站改版導致爬蟲失效、或經常遭遇 Cloudflare 等反機器人機制封鎖的專案。其自適應選擇器直接解決了「維護成本隨網站改版持續攀升」的核心痛點,而 MCP 伺服器與 RAG 輸出則讓資料工程團隊可以將爬蟲能力直接交付給 AI 代理與檢索系統使用。
對於個人開發者與小型團隊,BSD-3-Clause 授權意味著可以自由用於商業專案而無需付費或公開衍生程式碼;對於大型組織,完整型別標註、92% 測試覆蓋率與現成 Docker 映像降低了導入與維運風險。綜合而言,這是一個在功能完整度、授權彈性與生態成熟度三者之間取得良好平衡的開源爬蟲框架,值得在規劃下一代的資料蒐集架構時列入評估。
Scrapling 適合需穩定資料管線的團隊:自適應選擇器與反封鎖能力解決改版與驗證痛點;BSD-3 授權允許自由商用,92% 測試覆蓋率減維運風險,個人與企業適用。