
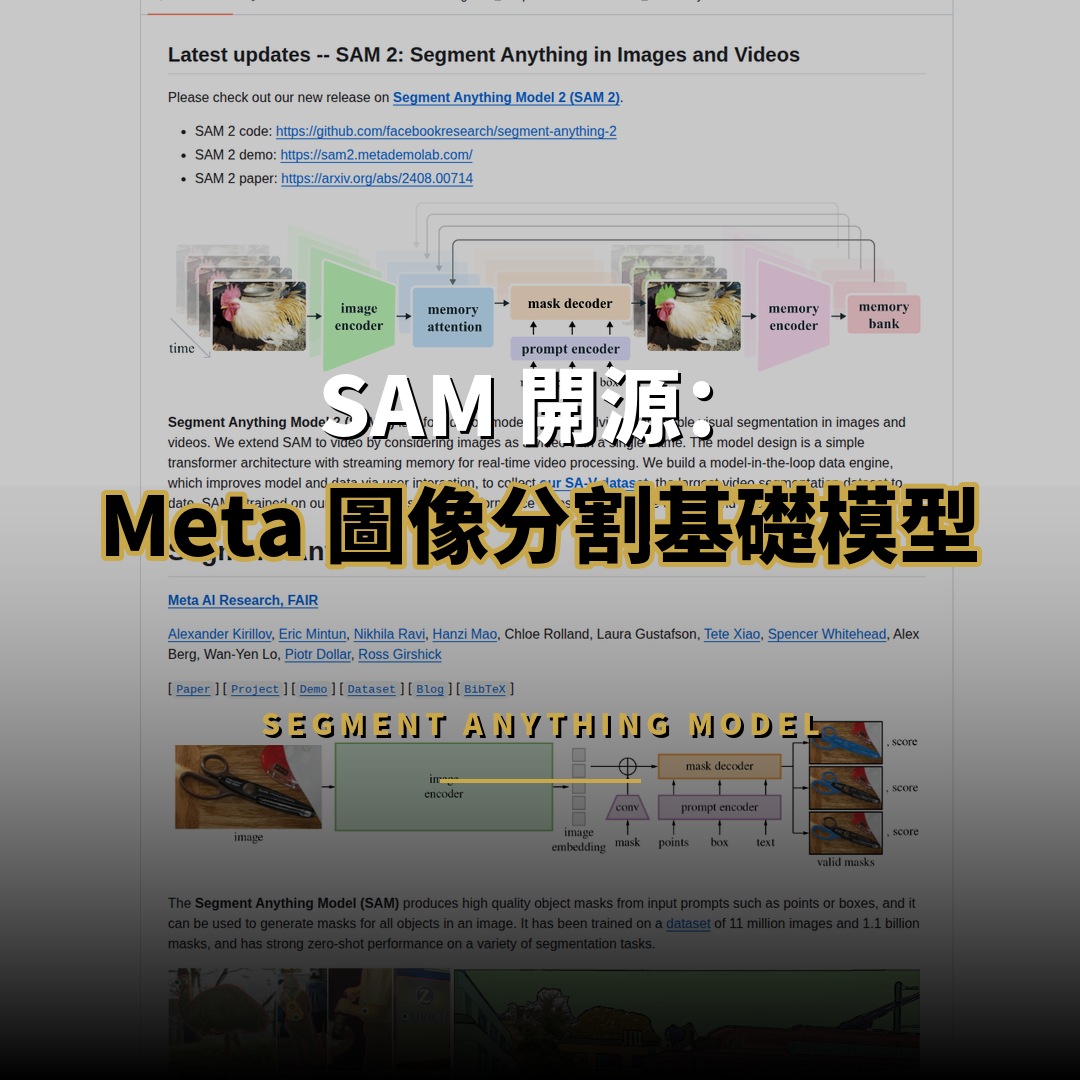
Segment Anything Model(SAM)是 Meta AI 研究院(FAIR)於 2023 年推出的開源圖像分割基礎模型,截至 2026 年 9 月,其官方儲存庫在 GitHub 上累積約 5.48 萬星標與 6,350 個 fork,以 Apache 2.0 授權開放。SAM 接受點、框或文字等提示輸入,即可產生高品質物件遮罩,並對未曾訓練過的圖片展現零樣本分割能力,研究團隊以 1,100 萬張圖片與 11 億個遮罩訓練出此模型。本文從項目背景、核心技術、應用場景與後續版本四個層面,分析 SAM 對計算機視覺生態系統的影響。
Segment Anything Model 是什麼?
SAM 是 Meta AI 開發的提示式圖像分割基礎模型,以點、框或文字指定目標即輸出物件遮罩。它用 1,100 萬張圖片與 11 億個遮罩訓練,具備零樣本泛化能力。
SAM 的定位並非單一任務的專用分割器,而是圖像分割領域的「基礎模型」,類似 GPT 之於自然語言處理的角色。傳統分割模型只能在特定資料集上辨識固定類別的物件,SAM 則透過「提示」機制將分割任務重新定義為可互動的通用能力,任何類別的物體都能透過一個點或一個框被切分出來。這項設計使 SAM 成為後續大量視覺應用的底層基礎設施,涵蓋影像編輯、醫學影像分析與自動駕駛感知等領域。
SAM 的核心技術亮點有哪些?
SAM 的核心是提示式分割架構,由圖像編碼器、提示編碼器與遮罩解碼器組成,支援點、框與文字提示。圖像特徵可重複使用,搭配提示即時輸出遮罩,也可匯出 ONNX。
SAM 的架構由三部分構成:基於 ViT(Vision Transformer)的圖像編碼器負責提取全域特徵,提示編碼器將點或框轉換為向量,輕量遮罩解碼器則結合兩者輸出最終遮罩。圖像編碼器只需執行一次,後續任何提示都能即時回應,這是 SAM 能做到即時互動分割的關鍵。模型提供 ViT-H、ViT-L、ViT-B 三種 backbone 尺寸,讓使用者按硬體條件在精度與速度之間取捨。
在部署層面,SAM 的遮罩解碼器可匯出為 ONNX 格式,配合 ONNX Runtime 在任何支援的環境運行,官方更提供基於 React 的網頁 Demo,將模型完整搬進瀏覽器執行,降低使用門檻。此外,研究團隊公開了 SA-1B 資料集建置流程與遮罩的 COCO RLE 儲存格式,使後續研究能沿用統一的資料規範。
SAM 與傳統分割模型有什麼差異?
傳統分割模型只能輸出預先定義的類別,遇新物體即失效。SAM 以提示驅動,未見過的物體也能透過點或框指定並分割,具備零樣本泛化能力,可一次產生全圖遮罩。
傳統語意分割模型以「類別」為單位,模型輸出層對應固定的物件種類,訓練資料之外的新類別無法處理;實例分割模型雖能區分同類物體,仍受限於預定義類別集合。SAM 將任務顛倒過來,不再要求模型理解「這是什麼」,而是回應「使用者想要哪個」,把分割從辨識問題轉化為定位問題,這使其在開放世界場景中擁有傳統模型難以比擬的泛化能力。
在資料規模上,SA-1B 資料集包含 1,100 萬張高解析度圖片與 11 億個遮罩,由模型輔助人工驗證的資料引擎迭代生成,是當時規模最大的分割資料集之一。這套「模型參與資料生產」的資料引擎模式,後來也被延伸運用於 SAM 2 的影片資料收集。
SAM 有哪些實際應用場景?
SAM 應用涵蓋影像編輯、醫學影像、自動駕駛與農業監測等領域。開發者可按提示分割任意物件,或一次分割全圖,再串接下游分類或測量任務。
在影像編輯領域,SAM 常與生成模型搭配,先精準分割主體再進行替換背景、移除物件或局部重繪,顯著降低過去依賴手動去背的成本。在醫學影像分析中,研究團隊利用 SAM 的零樣本能力對 CT、MRI 等影像進行初步結構分割,再以少量專業標註微調,緩解醫療資料標註稀缺的問題。
對開發者而言,SAM 的價值在於可程式化整合。官方提供的 SamPredictor 與 SamAutomaticMaskGenerator 兩組介面,分別支援提示導向分割與全圖自動分割;命令行工具 scripts/amg.py 則能批次處理資料夾內的所有圖片。這使得 SAM 能快速嵌入 RAG 以外的各類視覺工作流,例如自動駕駛資料集的自動標註、農業無人機影像的作物監測,以及零售場景的商品辨識與計數。
SAM 2 帶來了哪些升級?
SAM 2 是 SAM 的下一代,將分割能力從圖片延伸到影片,以串流記憶架構實現即時分割,並收集最大規模的影片資料集 SA-V,同一模型處理圖片與影片任務。
SAM 2 於 2024 年由 Meta 發布,核心突破是將提示式分割從圖片推展至影片。模型採用具串流記憶的 Transformer 架構,能即時處理影片每一幀,並在幀與幀之間保持物件身分的連續性,解決傳統影片分割方法需要整段影片離線處理的限制。研究團隊同時建立 SA-V 資料集,透過模型輔助的資料引擎收集超過 50 萬段影片,成為當時規模最大的影片分割資料集。
在官方敘述中,SAM 2 將圖片視為只有單一幀的影片,因此同一套模型與權重同時涵蓋圖片與影片兩種任務,使用者無需維護兩套分割系統。這項設計大幅簡化視覺應用的技術棧,也使 SAM 2 成為即時視訊分析、內容創作與機器人感知領域的新基準。
數據一覽:SAM 的關鍵統計資料有哪些?
SAM 儲存庫獲約 5.48 萬星標與 6,350 個 fork,Apache 2.0 授權,以 1,100 萬張圖片與 11 億遮罩訓練,提供 ViT-H/L/B 三種尺寸。


出處連結有哪些?
本文資訊來源為 Meta AI 官方開源的 Segment Anything 儲存庫,涵蓋模型程式碼、SA-1B 資料集與範例筆記本。
- GitHub 儲存庫:facebookresearch/segment-anything
- SAM 2 儲存庫:facebookresearch/segment-anything-2
- 官方論文:Segment Anything(arXiv:2304.02643)
- 官方專案頁面:https://segment-anything.com/
總結:SAM 適合什麼團隊使用?
SAM 適合需要通用圖像分割能力的團隊,包括影像編輯開發者、醫學影像與自動駕駛研究團隊。影片分割需求可直接採用 SAM 2,靜態圖片沿用輕量 SAM。
對研究團隊而言,SAM 是視覺基礎模型研究的關鍵參考實作,其資料引擎與提示架構已成為後續大量論文的比較基準。對產品團隊而言,SAM 的 Apache 2.0 授權允許商業使用,配合 ONNX 部署路線可以相對低成本接入現有產品。整體而言,SAM 與 SAM 2 構成了從圖片到影片的完整分割解決方案,任何需要「精準切分視覺內容」的應用,都可在此基礎上快速起步。