
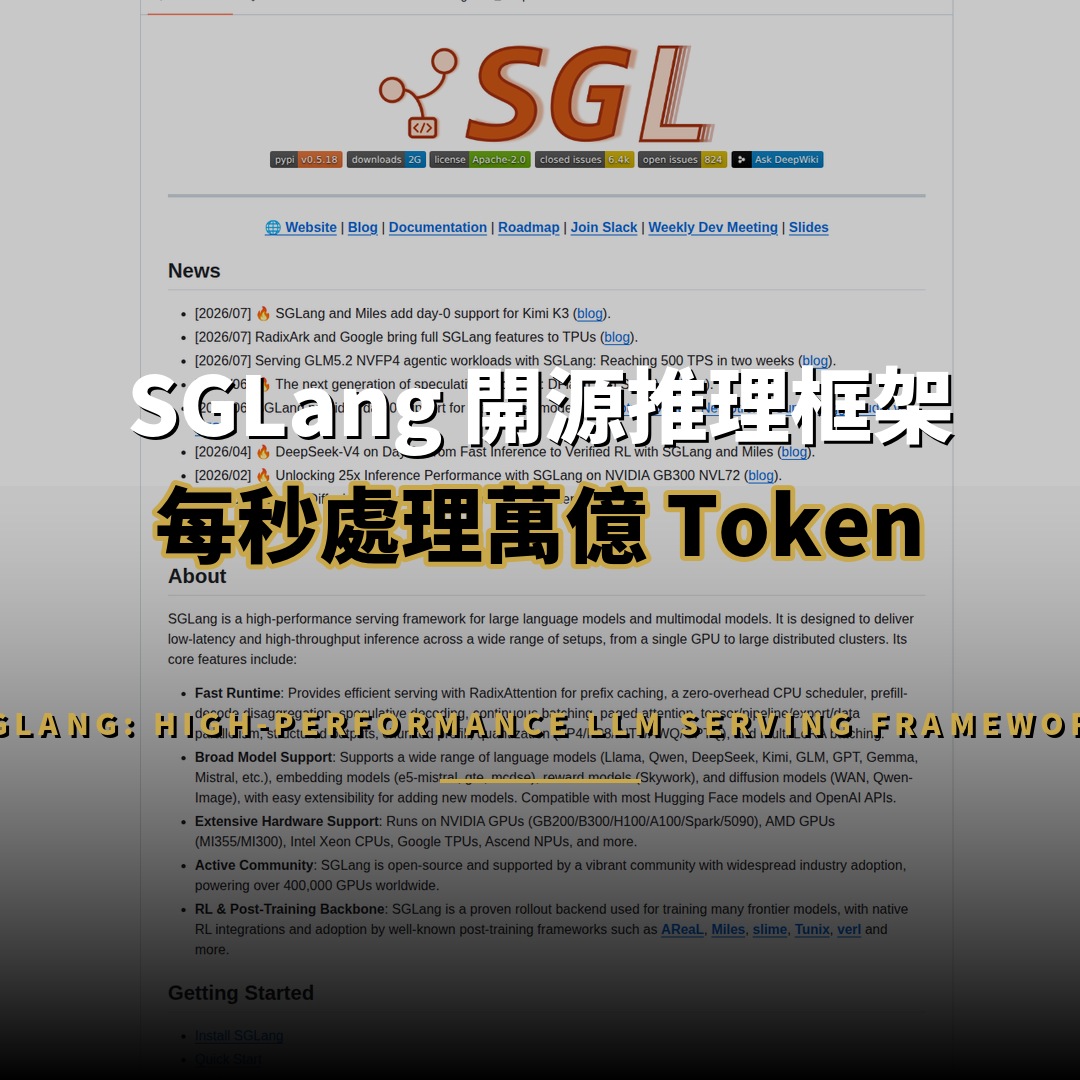
SGLang 是 LMSYS 旗下一個高效能的大語言模型與多模態模型服務框架,截至 2026 年 8 月在 GitHub 上累積超過 32,900 顆星標,全球部署超過 40 萬顆 GPU,每日生產萬億級 Token。它由加州大學柏克萊分校等學術機構主導的 LMSYS 組織維護,已成為 AI 推理基礎設施領域的事實標準之一。
SGLang 是什麼?
SGLang 是一套開源的大語言模型與多模態模型高效能服務框架,目標是提供低延遲、高吞吐量的推理服務。它支援從單張 GPU 到大型分散式叢集的部署,並相容多數 Hugging Face 模型與 OpenAI API,被 xAI、NVIDIA、Cursor 等企業採用。
SGLang 的定位相當明確:它是一個介於模型與生產環境之間的服務層,讓開發者可以將語言模型以標準 API 形式對外提供服務。與 vLLM、TensorRT-LLM 等框架相比,SGLang 的差異化落在「極致效能」與「彈性部署」兩端,無論是單卡開發環境或是橫跨上百顆 GPU 的生產叢集,都能以一致的體驗運行。
該專案由 sgl-project 組織維護,核心團隊來自 LMSYS 這個以 Chatbot Arena 評測平台聞名的非營利開源組織。專案自 2024 年 1 月創立以來,透過持續的版本迭代與學術界合作,累積了超過 1,000 名貢獻者,其中主要維護者包括 merrymercy、hnyls2002 與 fzyzcjy 等長期投入的工程師。
SGLang 有哪些核心技術亮點?
SGLang 的核心亮點包括 RadixAttention 前綴快取、零開銷 CPU 排程器、推斷解耦與推測解碼等技術。它亦支援連續批次處理、分頁注意力、多種平行化策略與量化格式,並內建多 LoRA 批次處理能力,適合高併發生產環境。
SGLang 的運作核心建立在一個名為 RadixAttention 的前綴快取機制上,它將共享的提示詞前綴以樹狀結構快取,大幅降低重複計算的開銷,使多用戶場景下的吞吐量顯著提升。官方數據顯示,該技術在早期版本即實現最高五倍的推理加速,至今仍是框架最主要的效能賣點。
在排程層面,SGLang 導入零開銷 CPU 排程器,將批次調度與 GPU 計算分離,避免靜態等待造成的資源浪費。搭配推斷解耦(Prefill-Decode Disaggregation)架構,框架可以將前置計算與生成階段分配到不同資源,進一步最佳化長上下文任務的延遲表現。推測解碼(Speculative Decoding)則允許模型以小模型預測大模型的輸出,在保持正確性的前提下減少生成步驟。
SGLang 同時提供豐富的量化支援,涵蓋 FP4、FP8、INT4、AWQ 與 GPTQ 等主流格式,讓用戶可以在效能與記憶體之間取得平衡。多 LoRA 批次處理功能則讓單一伺服器可以同時服務多個微調模型,對多租戶場景特別有價值。
SGLang 如何實現高效推理?
SGLang 透過前綴快取、連續批次、分頁注意力與多層平行化(張量、管線、專家、資料平行)實現高效推理,並支援推斷解耦與推測解碼。在 NVIDIA GB300 NVL72 上,官方宣稱可解鎖 25 倍的推理效能提升。
高效推理的關鍵在於減少 GPU 空閒時間與重複計算。SGLang 的連續批次處理(Continuous Batching)機制讓 GPU 在任何時刻都有任務可執行,避免等待最慢請求完成的傳統批次瓶頸。分頁注意力(Paged Attention)則以分頁方式管理 KV 快取記憶體,降低記憶體碎片化,讓長上下文請求得以在有限資源內運行。
在大型叢集場景,SGLang 支援張量平行、管線平行、專家平行與資料平行等多種策略,可以依據模型架構與硬體拓撲靈活組合。以 DeepSeek 系列模型為例,官方部落格顯示,在 96 顆 H100 GPU 上透過 PD 分離與大規模專家平行,可獲得顯著的延遲與吞吐量改善。
SGLang 亦積極與硬體廠商合作,涵蓋 NVIDIA 的 GB200、B300、H100 系列,AMD 的 MI300 系列,以及 Google TPU、昇騰 NPU 等平台。2026 年 7 月,SGLang 與 Google 合作將完整功能帶到 TPU,並在兩週內達成 GLM5.2 代理工作負載 500 TPS 的成績,顯示其跨硬體最佳化能力。
SGLang 在市場上有什麼影響力?
SGLang 已成為產業事實標準,部署超過 40 萬顆 GPU,每日生產萬億 Token。採用者包括 xAI、NVIDIA、AMD、Intel、LinkedIn、Cursor、Oracle Cloud、Google Cloud 等企業與 MIT、史丹佛等學術機構,並獲得 a16z 開源 AI 補助金。
SGLang 的市場影響力可以從三個維度觀察。首先是企業採用廣度,其部署客戶涵蓋 xAI、NVIDIA、AMD、Intel、LinkedIn、Cursor、Oracle Cloud、Google Cloud、Microsoft Azure 與 AWS 等主流雲端與 AI 廠商,代表不同規模的推理需求都能在該框架上落地。其次是生態位置,SGLang 被多個知名後訓練框架(如 AReaL、Miles、slime、Tunix 與 verl)選為 rollout 後端,成為強化學習與模型後訓練流程的關鍵基礎設施。
第三是資本市場的認可。2025 年 6 月,SGLang 獲得 a16z 頒發的第三批開源 AI 補助金,肯定其在開源社群與產業應用的雙重價值。作為非營利組織 LMSYS 旗下的專案,SGLang 的發展路線不以商業化為唯一目標,而是以學術開放與產業落地並進的方式推進。
與競品比較,vLLM 同樣是高效能推理框架的熱門選擇,兩者在效能與生態上各有擅長。SGLang 的優勢在於與 LMSYS 評測體系的緊密連結,以及對新模型的「Day-0 支援」能力——包括 DeepSeek-V4、Kimi K3、GLM5.2、Nemotron 3 系列等前沿模型都在發佈當日即可透過 SGLang 部署,這對追求最新模型的團隊極具吸引力。
SGLang 的數據表現如何?
SGLang 在 GitHub 擁有 32,900 顆星標、8,393 個 Fork,主要語言為 Python,採用 Apache 2.0 許可證。專案每日活躍更新,最新版本 v0.5.18 於 2026 年 8 月釋出,全球部署超過 40 萬顆 GPU。


出處連結有哪些?
本文資訊來源為 SGLang 的 GitHub 儲存庫(sgl-project/sglang),包含專案說明、新聞公告與效能數據。該儲存庫同時提供官方網站、文件與 Roadmap 連結,供讀者進一步查閱。
SGLang 的完整原始碼與技術文件可在 GitHub 儲存庫取得:sgl-project/sglang。官方網站為 sglang.io,文件位於 docs.sglang.io,開發藍圖與社群討論則分別在 Roadmap 與 Slack 頻道進行。
總結:SGLang 適合什麼團隊?
SGLang 適合需要高效能、低延遲推理服務的企業與研究團隊,尤其是部署大型語言模型或多模態模型的場景。具備 GPU 叢集與 Kubernetes 經驗的團隊可以充分發揮其效能,而尋求快速部署最新模型的團隊亦能受惠於 Day-0 支援。
總結而言,SGLang 已從一個學術專案成長為 AI 推理基礎設施的重要角色,其 40 萬顆 GPU 的部署規模與多元企業採用足以證明技術成熟度。對需要自建推理服務的團隊,SGLang 提供了與商業推理平台競爭的效能表現;對研究機構而言,其開放架構與活躍社群則降低了實驗門檻。選擇 SGLang 與否,最終取決於團隊的硬體資源與對最新模型支援速度的需求——而在這兩方面,SGLang 目前的表現都位居開源框架的前段班。