
Stable Diffusion 是 GitHub 上星標超過 73,000 顆的開源潛在擴散模型,由慕尼黑大學 CompVis 團隊與 Stability AI、Runway 合作開發,2022 年 8 月發布後徹底改變 AI 繪圖產業面貌,讓文字生圖首次可以在消費級 GPU 上運行,成為 AI 繪圖革命的開端。
Stable Diffusion 是 GitHub 星標逾 7.3 萬的開源潛在擴散模型,由 CompVis 團隊與 Stability AI 合作開發,在消費級 GPU 實現文字生圖,開啟 AI 繪圖革命。
Stable Diffusion 是什麼?為何成為 AI 繪圖的里程碑?
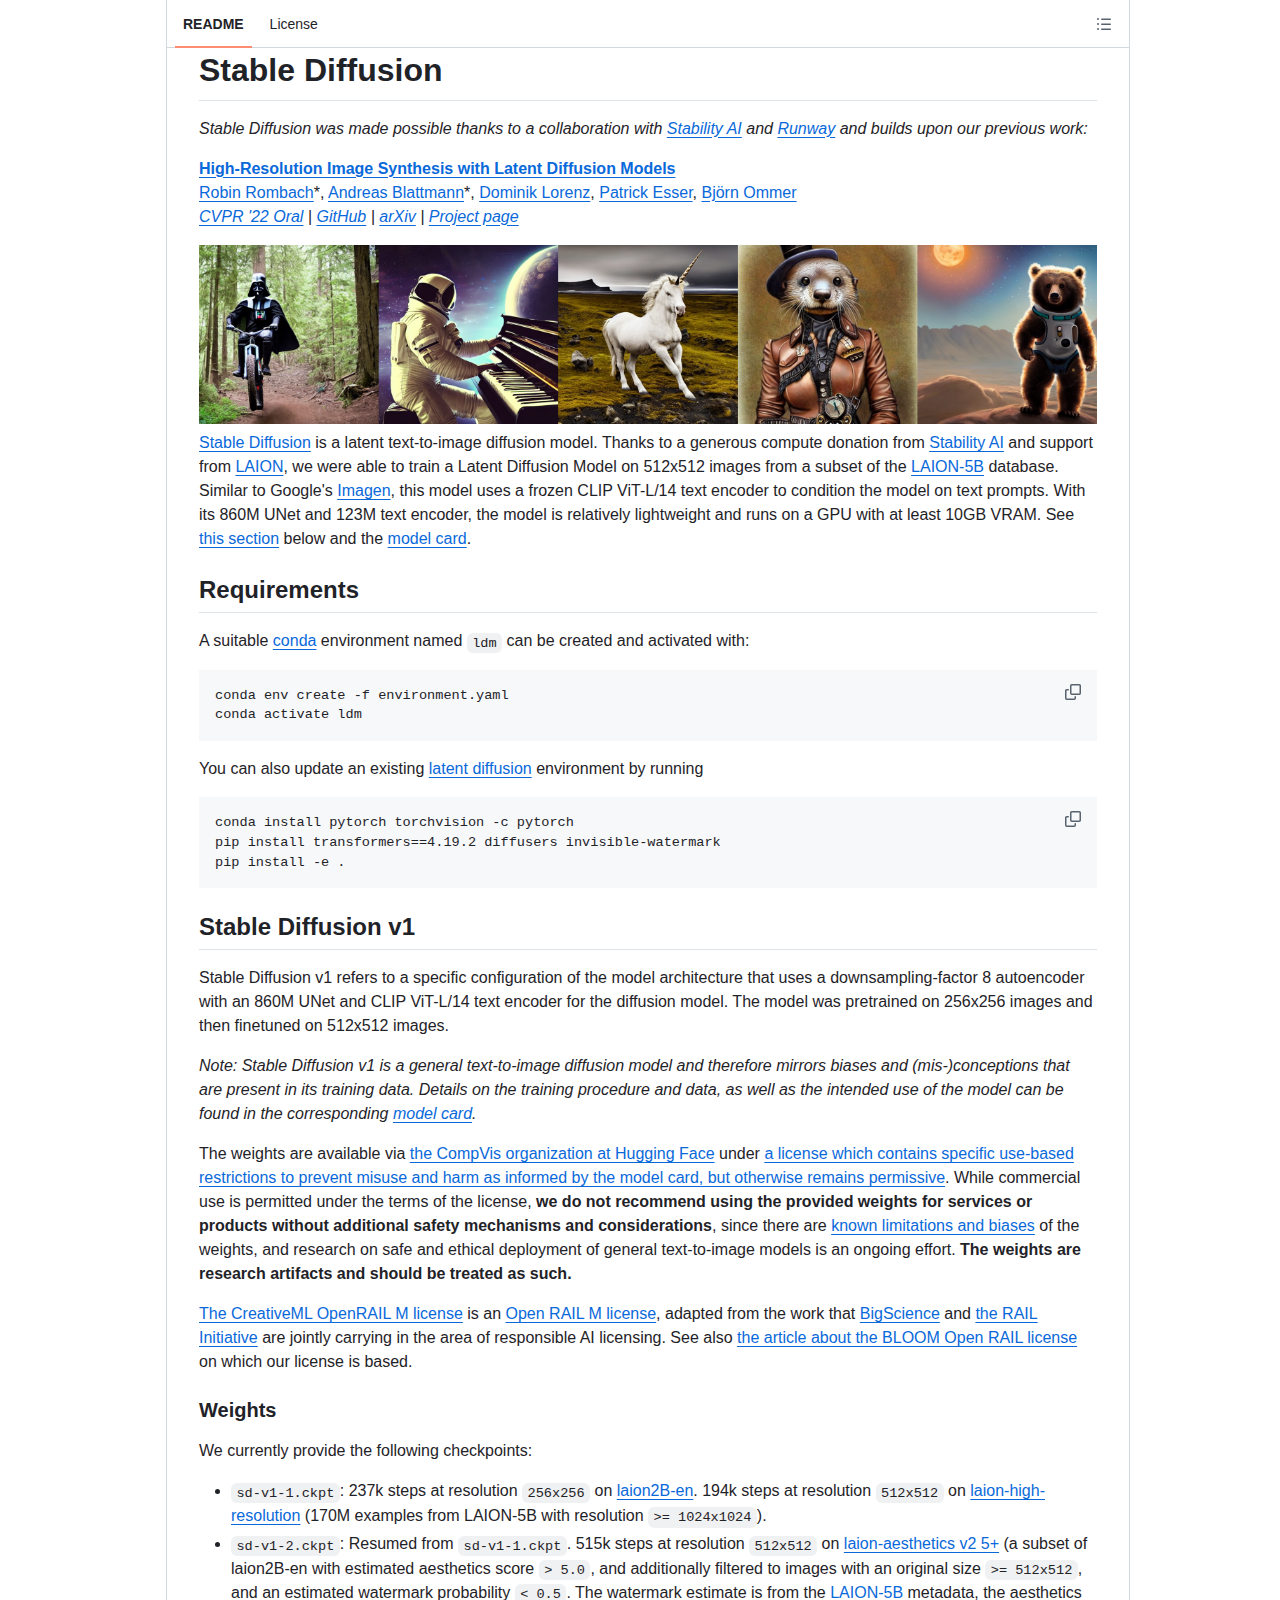
Stable Diffusion 是一個以潛在擴散(Latent Diffusion)技術為核心的文字生圖模型,由慕尼黑大學 CompVis 研究團隊主導開發,並獲得 Stability AI 的運算資源捐贈與 LAION 資料集支援。項目於 2022 年 8 月 10 日公開,其研究論文「High-Resolution Image Synthesis with Latent Diffusion Models」獲選為 CVPR 2022 口頭報告,作者包括 Robin Rombach、Andreas Blattmann、Dominik Lorenz、Patrick Esser 與 Björn Ommer 等學者。
Stable Diffusion 是 CompVis 團隊與 Stability AI、Runway 合作的開源文字生圖模型,在低維潛在空間去噪生成圖像,2022 年發布,論文獲 CVPR 2022 口頭報告。
此模型的歷史意義在於將擴散模型的運算需求大幅降低。傳統擴散模型需要在像素空間直接處理高解析度圖像,運算成本極高;Stable Diffusion 改為先在低維潛在空間進行去噪過程,再透過自動編碼器還原為圖像,令整體參數量與記憶體需求大幅下降。模型僅以 860M 的 UNet 骨幹配合 123M 的 CLIP ViT-L/14 文字編碼器組成,最低只需約 10GB 顯示記憶體的 GPU 即可運行,這在 2022 年屬於突破性的效率表現。
Stable Diffusion 的核心技術亮點有哪些?
Stable Diffusion 的第一項技術亮點是潛在擴散架構。模型使用下採樣因子為 8 的自動編碼器,將 512x512 圖像壓縮至潛在空間再進行擴散去噪,大幅節省運算資源,並沿用 OpenAI ADM 與 denoising-diffusion-pytorch 的程式碼基礎。模型先在 256x256 解析度預訓練,再以 LAION-5B 資料庫的高解析度子集微調至 512x512,形成完整的訓練流程。
Stable Diffusion 的核心亮點包括潛在擴散架構、CLIP 文字條件控制與多版本權重,僅需約 10GB VRAM 即可在低維潛在空間去噪還原圖像。
第二項亮點是穩健的文字條件控制。模型使用凍結的 CLIP ViT-L/14 文字編碼器,將文字提示轉換為條件向量引導擴散過程,實現精確的語意對齊。參考取樣腳本內建安全檢查模組,降低產生不當內容的機率,同時加入不可見浮水印機制,協助觀眾辨識機器生成圖像。
第三項亮點是完整的多任務支援。除了一般的文字生圖(txt2img),模型亦支援圖像編輯(img2img),透過 SDEdit 去噪機制實現文字引導的圖像轉換與放大,用戶可以輸入草圖或既有圖片,配合 strength 參數控制變異程度。官方同時提供 diffusers 程式庫整合,令開發者可以幾行程式碼完成模型載入與取樣。
Stable Diffusion 如何快速開始使用?
用戶可以透過多種方式快速開始使用 Stable Diffusion。最直接的方法是使用官方參考取樣腳本,先建立 conda 環境並安裝 PyTorch 與 transformers 依賴,再下載對應權重檔案,最後以一行指令生成圖像,例如以「a photograph of an astronaut riding a horse」為提示詞,預設以 50 步 PLMS 取樣器生成 512x512 圖像。
使用 Stable Diffusion 最快是透過官方 txt2img.py 腳本或 diffusers 程式庫,前者一行指令生成圖像,後者以幾行程式碼完成載入與取樣。
對於不熟悉命令列的用戶,diffusers 整合提供更親和的路徑:安裝 diffusers 程式庫後,以 StableDiffusionPipeline 載入 CompVis/stable-diffusion-v1-4 權重,配合 CUDA 自動混合精度即可生成圖像並直接儲存。官方腳本亦提供完整的參數支援,包括 DDIM 步數、PLMS 取樣、引導尺度、種子值與輸出解析度調整,方便進階用戶進行實驗與重現。
Stable Diffusion 的開源生態與商業化路徑如何?
Stable Diffusion 的開源生態影響深遠,其後出現的 AUTOMATIC1111 WebUI、ComfyUI 等知名繪圖工具皆以相關技術為基礎,Hugging Face 亦將其納入 diffusers 生態系統,形成龐大的衍生社群。項目採用 CreativeML OpenRAIL M 授權,這是一種基於 BigScience 與 RAIL Initiative 合作的負責任 AI 授權模式,容許商業使用,但要求使用者在部署服務或產品時加入額外的安全機制,並正視模型權重的已知限制與偏見。
Stable Diffusion 以 CreativeML OpenRAIL M 授權開源,容許商業使用但要求負責任部署,衍生生態涵蓋 AUTOMATIC1111、ComfyUI 等主流工具。
在商業化路徑上,Stability AI 以該模型為基礎推出商業服務,Runway 亦將相關技術整合至其創意工具,證明開源研究模型可以轉化為可持續的商業產品。模型權重以研究產物定位釋出,官方明確提醒不宜在缺乏安全機制的服務或產品中直接使用,顯示團隊在開放與負責任之間取得平衡。時至今日,該項目仍維持逾 7.3 萬星標與 1 萬個 Fork,顯示其技術影響力持續存在。
出處連結有哪些?
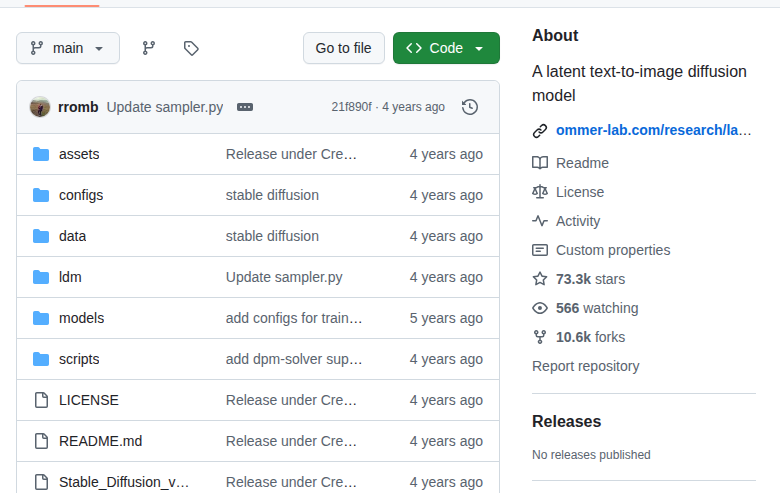
本文的資料來源為 GitHub 上的 CompVis/stable-diffusion 官方儲存庫,包含完整的 README 文件、模型權重說明、取樣腳本與研究論文連結。讀者可以前往 https://github.com/CompVis/stable-diffusion 查看原始程式碼,或參閱論文「High-Resolution Image Synthesis with Latent Diffusion Models」了解更多技術細節。
Stable Diffusion 的原始程式碼、權重說明與取樣腳本存放於 GitHub 的 CompVis/stable-diffusion 儲存庫,研究論文發表於 CVPR 2022。
常見問題有哪些?
Stable Diffusion 需要什麼硬件配置?
官方要求至少 10GB 顯示記憶體的 GPU,配合 conda 環境與 PyTorch 即可運行,模型以 512x512 解析度生成圖像,並支援自動混合精度加速。Stable Diffusion 可以商用嗎?
CreativeML OpenRAIL M 授權容許商業使用,但官方不建議在缺乏安全機制的服務或產品中直接使用權重,要求部署者加入內容安全考量。Stable Diffusion 與其他繪圖模型有何分別?
其核心差異在於潛在擴散架構,模型在低維潛在空間去噪而非像素空間,顯著降低運算需求,令消費級 GPU 也能執行文字生圖,這是其快速普及的主要原因。總結:Stable Diffusion 為何值得關注?
Stable Diffusion 以開源形式將文字生圖技術帶入一般用戶手中,潛在擴散架構影響眾多繪圖模型與工具,是 AI 繪圖發展歷程中最具代表性的研究項目。
Stable Diffusion 以開源形式將先進的文字生圖技術帶入一般用戶手中,其潛在擴散架構至今仍影響著眾多繪圖模型與工具。項目的學術基礎、開源授權與衍生生態,使其成為 AI 繪圖發展歷程中最具代表性的研究項目之一,無論對開發者或用戶而言都具有深遠的參考價值。