
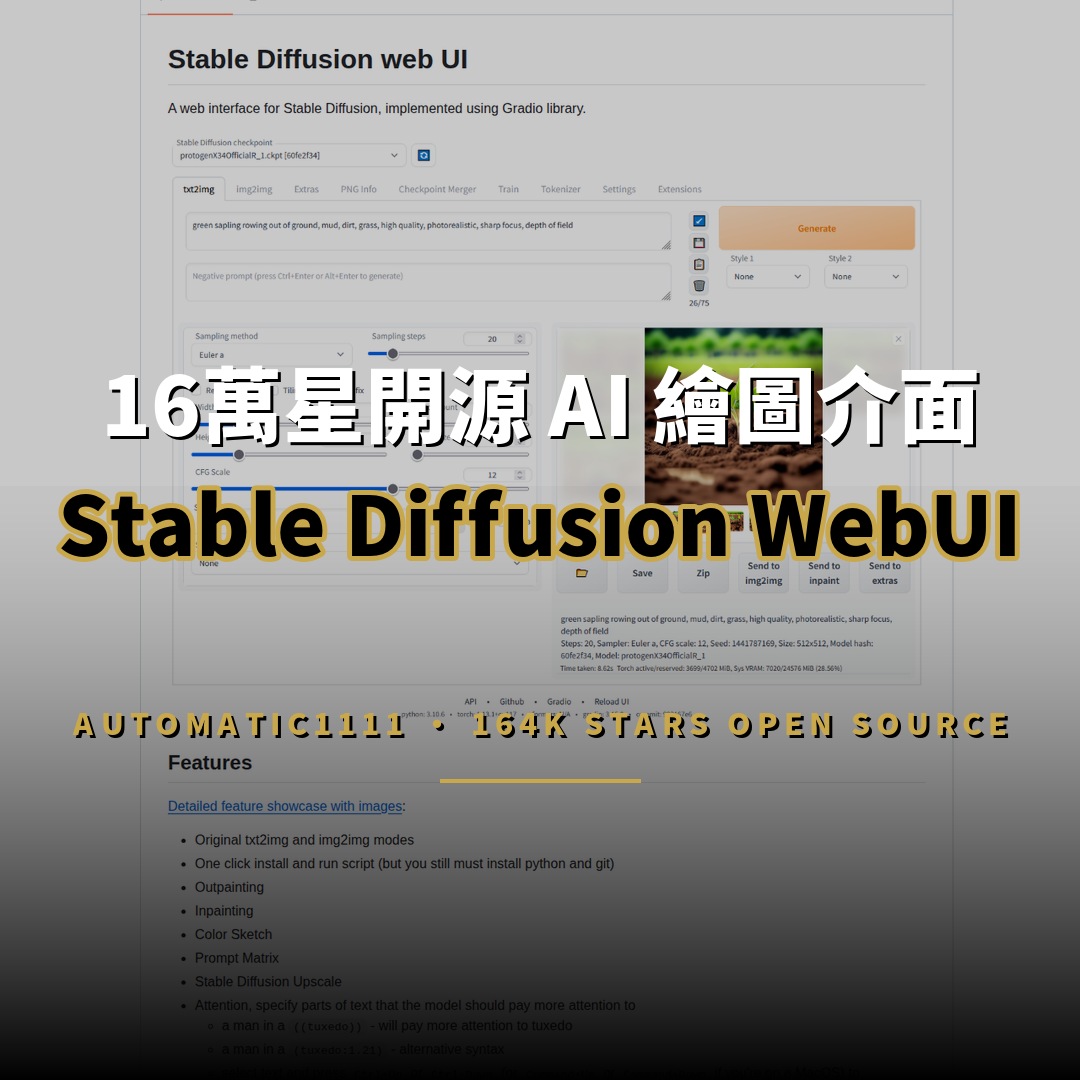
Stable Diffusion WebUI 是 GitHub 上目前累積超過 164,000 顆星標的開源 AI 繪圖網頁介面,由開發者 AUTOMATIC1111 以 Python 和 Gradio 框架建構,將 Stable Diffusion 模型的文字生圖、圖片生圖與模型訓練能力整合為單一瀏覽器介面。該項目以「一鍵安裝、低硬體門檻」聞名,最低 4GB 顯示卡即可運行,被視為本地部署 AI 繪圖工具的標準選擇。
Stable Diffusion WebUI 是 AUTOMATIC1111 以 Gradio 開發的開源 AI 繪圖介面,累積 16.4 萬星標,4GB 顯示卡即可運行。
Stable Diffusion WebUI 是什麼?
Stable Diffusion WebUI 是圍繞 Stable Diffusion 開源模型打造的圖形化操作介面,使用者無需編寫程式碼,即可透過瀏覽器完成提示詞輸入、參數調整、圖片生成與後製處理。項目採用 AGPL-3.0 授權,原始碼完全開放,自推出以來持續更新,最近一次版本維護在 2026 年 9 月仍持續進行。
Stable Diffusion WebUI 是以 Gradio 建構的 Stable Diffusion 圖形介面,在瀏覽器即可完成提示詞輸入與圖片生成。
該項目最早期始於 Stable Diffusion 公開原始碼之後,由於提供比官方指令列更友善的操作方式,迅速吸引大量創作者轉向使用。目前專案擁有約 30,500 個 forks,顯示其不僅是被動使用的工具,更成為眾多衍生專案與擴充功能的基礎。
Stable Diffusion WebUI 有哪些核心功能?
該介面涵蓋完整的生成式繪圖功能鏈,包括文字生圖(txt2img)、圖片生圖(img2img)、局部重繪(inpainting)、向外延伸(outpainting)與高解析度修復(Highres Fix)。使用者可以透過提示詞矩陣一次生成多組參數組合的對比圖,亦可用 X/Y/Z plot 建立三維參數空間的結果比較。
Stable Diffusion WebUI 提供文字生圖、圖片生圖、局部重繪、向外延伸與高解析度修復等功能,並支援提示詞矩陣與 X/Y/Z plot 參數對比。
在模型層面,介面支援 Textual Inversion 嵌入訓練、Hypernetwork 與 LoRA 等輕量微調方式,使用者可在 8GB 顯示卡上訓練自有嵌入,並透過圖形介面選擇要套用的模型組合。訓練頁面同時提供影像預處理,包括自動裁切、鏡像擴增與 BLIP 自動標註,大幅降低資料準備門檻。
Stable Diffusion WebUI 如何安裝與部署?
項目針對主流平台提供對應的自動安裝方案,Windows 使用者只需下載 release 壓縮包或執行 webui-user.bat,Linux 使用者執行 webui.sh,macOS 則提供 Apple Silicon 安裝指南。安裝過程會自動處理 Python 環境、PyTorch 與顯示卡驅動等依賴,官方建議使用 Python 3.10.6 以確保與 torch 相容。
Stable Diffusion WebUI 支援 Windows、Linux 與 macOS 一鍵安裝,執行 webui-user.bat 或 webui.sh 即可啟動。
對於沒有本機 GPU 的使用者,項目亦提供 Google Colab 等線上服務清單,以及 AMD、Intel 與 Ascend NPU 等異構硬體支援說明。介面本身提供詳盡的設定頁,使用者可調整取樣方法、CFG Scale、種子值與圖像尺寸等參數,所有生成參數會隨圖片一併儲存,方便日後重現。
Stable Diffusion WebUI 的硬體需求如何?
該項目的低硬體門檻是其廣受歡迎的關鍵因素,官方標示 4GB 顯示卡即可運行,社群回報亦有 2GB 顯示卡成功運作的案例。透過 xformers 最佳化與半精度浮點運算,顯示卡記憶體較小的使用者依然可以獲得可用的生成速度。
Stable Diffusion WebUI 最低支援 4GB 顯示卡,社群亦有 2GB 運作案例,搭配 xformers 最佳化可降低記憶體需求,中低階顯示卡也能本機生成圖片。
對於記憶體仍不足的場景,項目內建 TAESD 輕量模型產生即時預覽,幾乎不佔用額外 VRAM 或運算資源。放大功能則整合 GFPGAN、CodeFormer 臉部修復與 RealESRGAN、SwinIR 等超解析度模型,使用者可在生成後直接進行畫質增強而無需切換其他工具。
Stable Diffusion WebUI 與其他 AI 繪圖工具相比如何?
相較於官方 Stable Diffusion 指令列工具,WebUI 的最大優勢在於完整的圖形介面與生態系統。項目內建 Checkpoint Merger,可將最多三個模型合併為新模型;Custom Scripts 與擴充功能機制則讓社群貢獻了超過百款外掛,涵蓋影像瀏覽、風格應用與工作流程自動化等領域。
相較官方指令列工具,Stable Diffusion WebUI 提供完整圖形介面、模型合併與 Custom Scripts 擴充機制,社群貢獻逾百款外掛,生態成熟度領先。
在商業化路徑上,該項目保持純開源定位,未引入付費訂閱機制,而是透過開源授權與社群貢獻維持發展。這種模式使其成為 Stable Diffusion 生態中最具代表性的參考實作,許多後續繪圖介面與雲端服務皆以其功能集為基準設計。

Stable Diffusion WebUI 的開源生態有多成熟?
該項目的生態系統圍繞擴充功能與衍生專案構建,超過 30,500 個 forks 中包括大量第三方擴充、模型整合與本地化版本。官方將文件集中於 GitHub Wiki,並提供可供搜尋引擎索引的鏡像版本,方便開發者查閱功能說明與安裝指南。
Stable Diffusion WebUI 生態以擴充功能為核心,擁有超過 30,500 個 forks,官方文件集中於 GitHub Wiki 並提供可索引鏡像。
在擴充面向上,LoRA 選擇介面可預覽嵌入與模型效果,DeepDanbooru 整合為動漫提示詞提供自動標籤,Aesthetic Gradients 則以 CLIP 圖像嵌入實現特定美學風格生成。項目同時支援 Composable Diffusion,允許以 AND 分隔多組提示詞並設定權重,適合組合式創作場景。


Stable Diffusion WebUI 累積約 164,800 顆星標與 30,600 個 forks,以 Python 開發並採用 AGPL-3.0 授權。
出處連結有哪些?
本文資訊整理自 Stable Diffusion WebUI 的 GitHub 官方儲存庫,包括功能說明、安裝指南、硬體需求與擴充文件,讀者可前往以下連結取得原始資料:
- GitHub 專案頁面:
https://github.com/AUTOMATIC1111/stable-diffusion-webui - 官方功能文件:
https://github.com/AUTOMATIC1111/stable-diffusion-webui/wiki/Features
本文資訊來源為 AUTOMATIC1111/stable-diffusion-webui 的 GitHub 儲存庫與功能文件 Wiki,涵蓋功能與安裝指南等完整內容。
總結:Stable Diffusion WebUI 適合什麼團隊使用?
整體而言,Stable Diffusion WebUI 適合希望在本機建立完整 AI 繪圖環境的個人創作者、設計師與開發者,特別是重視隱私、需要大量批次生成或想自行訓練 LoRA 模型的使用者。因應其低硬體門檻與豐富生態,該項目亦常被作為教學素材與企業內部設計工具的基礎。
Stable Diffusion WebUI 適合創作者與開發者在本機部署 AI 繪圖,尤其重視隱私或需要自行訓練 LoRA 的使用者;低門檻生態亦適合作為教學工具。
該項目以完全開源、持續維護與龐大社群基礎,確立了其在 AI 繪圖工具鏈中的代表性地位。對於尚未嘗試本地 AI 繪圖的團隊,此介面提供了成本最低、上手最快的切入點。