
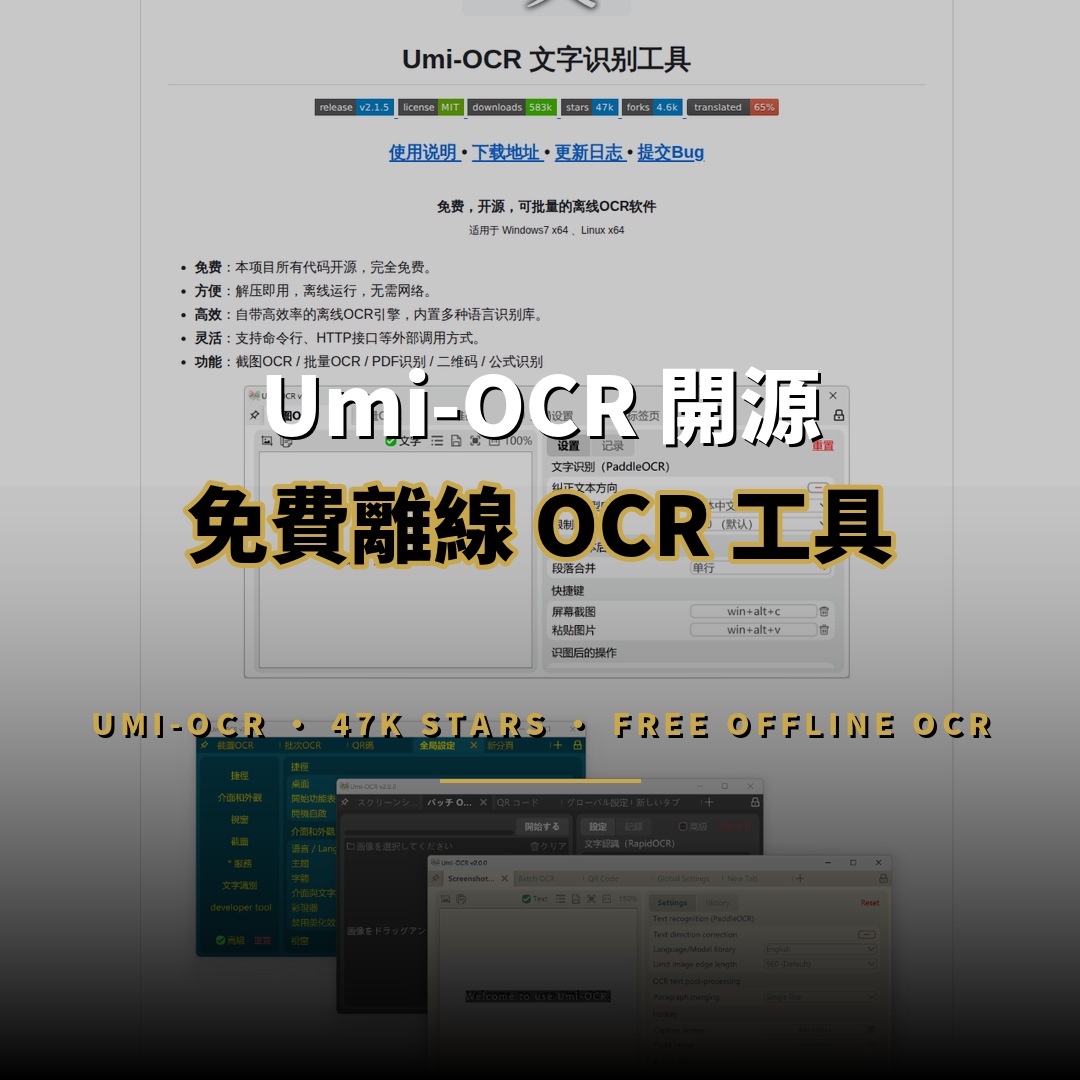
Umi-OCR 是一套免費、開源、可批量處理的離線 OCR 軟體,目前於 GitHub 累積 47,220 星標與 4,617 次複製,由開發者 hiroi-sora 於 2022 年 3 月發起並持續維護至今。該軟體以「免安裝、解壓即用、無需網路」為核心設計原則,內建高效率離線 OCR 引擎與多國語言識別庫,支援 Windows 7 x64 與 Linux x64 平台,提供截圖識別、批量識別、PDF 掃描件轉換、二維碼與公式識別等完整功能,已成為華語開發者與一般使用者進行文件數位化的熱門工具。
Umi-OCR 是免費開源的離線 OCR 軟體,GitHub 星標 47,220,免安裝即可在 Windows 與 Linux 運行,支援截圖、批量、PDF 與公式識別。
Umi-OCR 是什麼?為何能在 GitHub 累積 47K 星標?
Umi-OCR 是主打離線運行與免安裝的 OCR 桌面軟體,以解壓即用、無需上傳檔案、內建多引擎與多語言支援為賣點,因此在開源社群快速累積星標。
Umi-OCR 的定位並非開發者函式庫,而是面向終端使用者的完整桌面應用。多數 OCR 開源專案以命令列工具或程式框架形式存在,使用者需要自行配置環境、安裝依賴模型才能運行;Umi-OCR 則將引擎、模型與圖形介面打包為可直接執行的發行版本,使用者下載壓縮檔後解壓縮、點擊執行檔即可啟動,大幅降低了 OCR 技術的使用門檻。
此專案採用 MIT 開源許可證,所有程式碼完全開放且免費,開發者依靠社群回饋與 Issue 機制持續迭代。從 2022 年發布至今,該專案經歷多次架構重寫,目前以標籤頁形式組織各項功能,並發展出獨立的插件庫與運行庫倉庫,形成一套可擴充的桌面 OCR 生態。其 47,220 星標的累積速度,反映的正是「離線、免費、易用」三項需求在華語使用者社群中的強烈共鳴,尤其對於重視文件隱私與不便使用雲端服務的用戶而言,Umi-OCR 提供了具吸引力的替代方案。
Umi-OCR 的核心功能有哪些?
Umi-OCR 提供截圖識別、批量識別、PDF 掃描件轉雙層可搜索 PDF、二維碼掃描與生成、公式識別五大功能,並支援多種圖片格式與結果匯出格式。
Umi-OCR v2 以標籤頁架構組織功能,使用者可依需求開啟對應頁面,並支援視窗置頂與標籤鎖定,方便日常反覆使用。截圖 OCR 頁面允許使用者透過快捷鍵喚起螢幕截圖即時識別文字,左側圖片預覽欄可直接以滑鼠劃選複製,右側識別記錄欄則可編輯並劃選多筆記錄,亦支援直接貼上剪貼簿圖片進行識別。
批量 OCR 頁面面向大量文件處理場景,支援 jpg、png、webp、bmp、tiff 等九種圖片格式,結果可輸出為 txt、jsonl、md 與 csv 格式,且沒有數量上限,可一次匯入數百張圖片執行任務,並支援完成後自動關機或待機。文件識別頁面則針對 pdf、xps、epub、mobi、fb2、cbz 等電子文件格式,可對掃描件執行 OCR 或提取原有文字,輸出為雙層可搜索 PDF,解決掃描文件無法檢索與複製的痛點。
此外,Umi-OCR 內建二維碼工具,支援 19 種條碼協議的掃描與生成,包括 QRCode、DataMatrix、PDF417 與 EAN13 等常見格式,並可設定錯誤糾錯等級。公式識別功能則可將截圖中的數學公式轉換為可編輯文字,滿足學術與工程領域的特定需求。
Umi-OCR 的引擎架構與排版解析技術有什麼特點?
Umi-OCR 採用插件式引擎架構,內建 Paddle-OCR 與 Rapid-OCR 並可切換,搭配排版解析,能按正確順序輸出多欄與直排文字。
在引擎層面,Umi-OCR 內建 Paddle-OCR 與 Rapid-OCR 兩套離線引擎,前者速度較快,後者相容性較佳,使用者可透過 Scoop 安裝不同版本,亦可從插件庫匯入第三方引擎隨時切換。此插件化設計使專案不依賴單一模型供應商,也讓識別品質與速度可依硬體條件彈性調整。
Umi-OCR 另一項關鍵技術是文字後處理的排版解析方案。OCR 引擎的原始輸出通常只依閱讀順序回傳文字區塊,遇到多欄排版、直排文字或程式碼時容易錯亂;Umi-OCR 提供多欄與單欄的換行策略選項,包括按自然段換行、強制換行、合併單行與保留縮進等模式,其中「單欄保留縮進」專為解析程式碼截圖設計,可完整保留行首縮排與行中空格。系統亦支援直排(由右至左)排版的自動處理,並可搭配「忽略區域」功能,讓使用者以矩形框標記水印、頁眉頁腳等不想要的文字區域,於識別時直接排除,避免干擾結果。
Umi-OCR 與其他開源 OCR 工具相比有何優勢?
相較 Tesseract 需自行配置環境、PaddleOCR 以函式庫為導向,Umi-OCR 提供免安裝圖形介面,離線運行且內建多引擎與文件轉換,對一般使用者更友善。
開源 OCR 領域已有 Tesseract 與 PaddleOCR 等知名專案,Umi-OCR 的差異化在於產品化程度。Tesseract 歷史悠久、支援語言眾多,但原生為命令列工具,圖形介面需仰賴第三方包裝,模型訓練與參數調整對非技術使用者並不友善。PaddleOCR 識別精度領先且支援場景豐富,但定位為程式函式庫,需具備 Python 開發環境方能發揮完整能力。
Umi-OCR 則以「完整桌面產品」的姿態填補兩者之間的空隙:下載即是可執行的應用程式,具備圖形化設定、多國語言介面與主題切換,同時保留了命令列與 HTTP 介面供進階使用者與其他程式整合。在輸出能力上,Umi-OCR 直接整合掃描 PDF 轉雙層可搜索文件的功能,這在純函式庫方案中通常需要另行串接多個元件才能達成。對於追求快速部署、重視隱私且不熟悉程式開發的使用者而言,Umi-OCR 提供了最直接的路徑。
Umi-OCR 有哪些實際應用場景?
Umi-OCR 適用於紙本文件數位化、掃描 PDF 全文檢索、截圖文字快速擷取、程式碼片段複製、含浮水印圖文的批量去雜訊處理,以及離線保密環境下的文件識別需求。
在實際使用情境中,Umi-OCR 首先覆蓋的是紙本文件數位化流程。使用者將合約、書籍、歷史文件掃描為圖片或 PDF 後,透過批量 OCR 頁面一次性匯入,即可輸出為可編輯文字或雙層可搜索 PDF,讓原本只能以影像形式保存的資料具備全文檢索與複製能力,對辦公室檔案整理與個人知識庫建立皆有直接助益。
針對頻繁需要擷取螢幕資訊的使用者,截圖 OCR 功能以快捷鍵喚起、即時回傳結果的工作流程,可應用於視訊會議字幕記錄、線上課程講義整理、軟體操作畫面文字擷取等場合。排版解析方案中的保留縮進模式,則讓開發者能直接從程式碼截圖複製可用文字,省去逐字重新輸入的麻煩。忽略區域功能對需要批量處理含浮水印或頁眉頁腳圖文的用戶尤其實用,例如將公司歷史文件掃描建檔時,可預先框選浮水印位置,確保識別結果不受干擾。
對隱私要求嚴格的機構而言,Umi-OCR 的離線特性亦構成關鍵優勢。文件影像全程在本機處理,無需上傳至雲端服務,符合醫療、法律、金融等行業對資料落地與保密的要求,亦適合網路環境受限的場合使用。
Umi-OCR 的數據表現如何?
Umi-OCR 在 GitHub 有 47,220 星標、4,617 次複製,採 MIT 授權,主要語言為 Python,最後更新時間為 2026 年 9 月 9 日。


出處連結有哪些?
本文資訊來源為 Umi-OCR 的 GitHub 儲存庫(hiroi-sora/Umi-OCR)及 README 文件,包含星標、授權、功能與更新時間等公開資料。
出處連結:Umi-OCR GitHub 儲存庫。該專案另有獨立的插件庫(hiroi-sora/Umi-OCR_plugins)提供多種 OCR 引擎擴充,Windows 與 Linux 運行庫亦分開維護,讀者可經由上述連結查閱原始碼、發行版本與完整使用手冊。
總結:Umi-OCR 適合哪些使用者?
Umi-OCR 適合需要離線、免費且免安裝的文件識別方案的使用者,包括辦公室行政、研究人員、開發者與重視文件隱私的個人,尤其適合需批量處理掃描文件的場景。
Umi-OCR 以 MIT 授權提供完整桌面級 OCR 功能,將引擎配置、模型下載與介面設定等技術門檻打包為解壓即用的發行版本,填補了 Tesseract 與 PaddleOCR 之間「專業但不易用」的空隙。對於需要頻繁處理掃描文件、重視資料隱私、或不具備程式開發環境的使用者而言,此工具提供了零成本且可離線運行的解決方案;對開發者而言,命令列與 HTTP 介面亦保留自動化整合的彈性。整體而言,該項目憑藉持續的社群維護與明確的產品定位,已成為華語世界開源 OCR 工具的代表性選擇。