
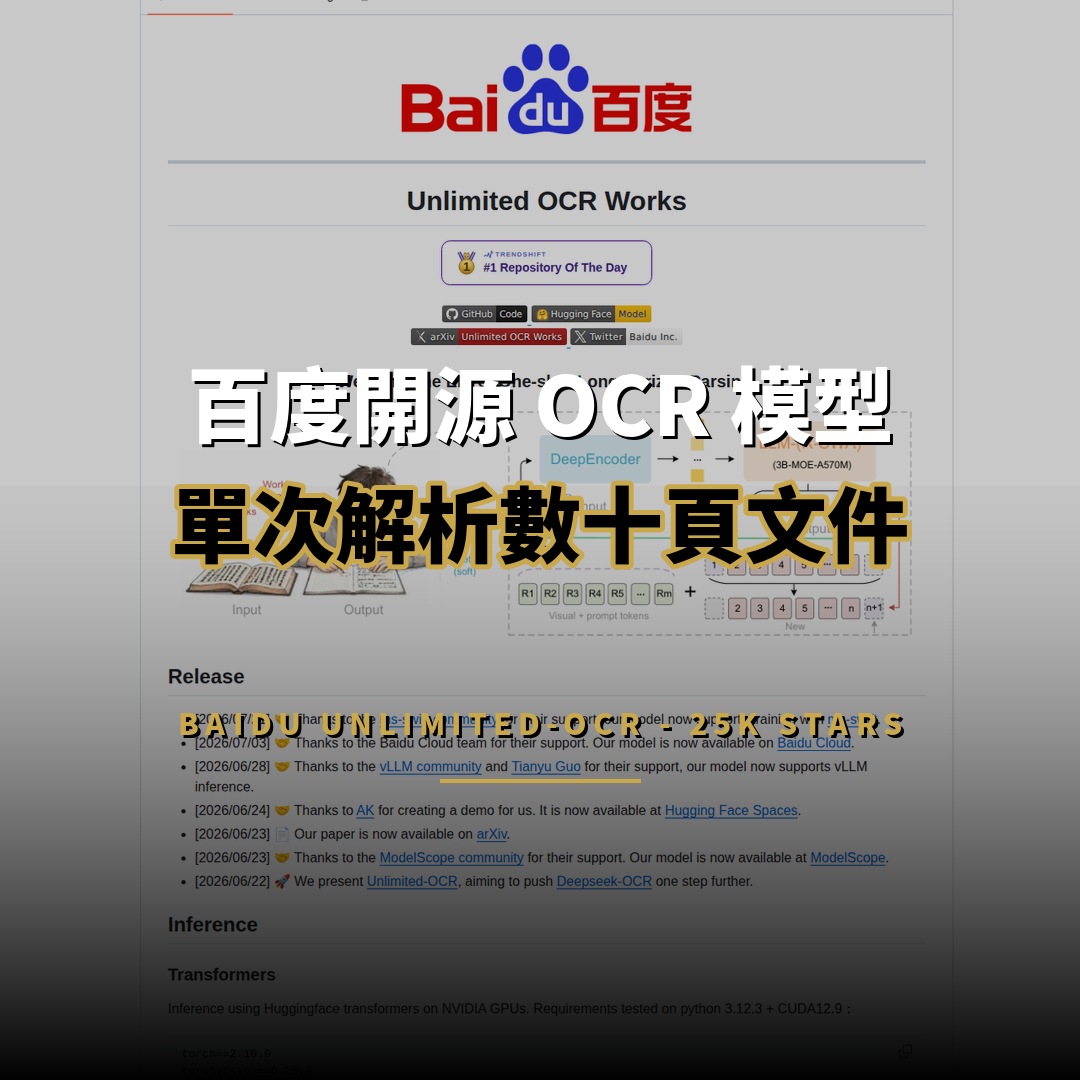
Unlimited-OCR 是百度於 2026 年 6 月開源的端到端文件解析模型,GitHub 星標已達 25,425,fork 數 2,631,採用 MIT 授權。該專案以 DeepSeek-OCR 為基準,將解碼器的全部注意力層替換為自研的 Reference Sliding Window Attention(R-SWA),使 KV 快取在整個解碼過程中維持恆定,從而在標準 32K 上下文內以單次前向傳遞完成數十頁文件轉錄,並相容 vLLM 與 SGLang 推論框架。對於需要處理長文件數位化的團隊而言,此設計直接回應了端到端 OCR 模型最現實的成本瓶頸。
Unlimited-OCR 是百度 2026 年 6 月開源的端到端文件解析模型,GitHub 星標 25,425,以 R-SWA 讓 KV 快取維持恆定,可單次解析數十頁文件。
Unlimited-OCR 是什麼?
Unlimited-OCR 是百度研發的開源文件解析模型,基於 DeepSeek-OCR 改良,2026 年 6 月發布並開放權重下載。
Unlimited-OCR 由百度團隊研發,2026 年 6 月 22 日於 GitHub 公開,並在 Hugging Face 與 ModelScope 同步釋出模型權重。其技術報告已提交至 arXiv,編號為 2606.23050,作者群來自百度的多模態與文件理解團隊。該專案在 README 中明確定位為 DeepSeek-OCR 的延伸版本,目標是實現「一次完成長時程解析」(one-shot long-horizon parsing),而非重新設計一套全新的 OCR 骨幹。
在生態整合方面,專案釋出後數週內即陸續完成多項外部支援。2026 年 6 月 23 日模型登上 ModelScope,同日由 AK 製作的示範空間上線 Hugging Face Spaces;6 月 28 日支援 vLLM 推論;7 月 3 日於百度雲提供服務;7 月 21 日進一步支援 ms-swift 訓練框架。這種多平台同步推進的節奏,說明百度將其視為面向開發者社群的通用文件解析基礎模型,而非單一產品的內部元件。專案採用 MIT 授權,模型權重與程式碼皆可自由使用與商業化。
Unlimited-OCR 的架構有什麼創新?
Unlimited-OCR 以自研的 R-SWA 取代解碼器全部注意力層,讓 KV 快取固定不變,因此輸出序列再長也不會拖慢生成速度。
端到端 OCR 的核心構想,是讓大型語言模型充當解碼器,藉由語言先驗分布提升辨識準確度。然而此設計存在明顯代價:輸出序列愈長,累積的 KV 快取就愈龐大,記憶體消耗隨之攀升,生成速度也逐步下降。這與人類在長時間抄錄時效率幾乎不減的特性形成強烈反差,也是長文件解析難以規模化的根本原因。
Unlimited-OCR 的解法是 Reference Sliding Window Attention。該機制將解碼器中所有注意力層替換為滑動視窗形式,並以固定的參考表徵作為錨點,使注意力計算成本大幅降低,同時讓 KV 快取在整個解碼過程中維持不變。結合 DeepSeek-OCR 編碼器本身的高壓縮率,模型得以在標準 32K 最大長度下,以單次前向傳遞轉錄數十頁文件,而非逐頁分段處理後再拼接。
研究團隊強調,R-SWA 屬於通用型的解析注意力機制。除了 OCR 之外,同樣可套用於自動語音辨識、機器翻譯等需要長時程對齊的任務,意味這項設計的價值可能超出文件解析的單一領域。
Unlimited-OCR 的效能與部署方式如何?
Unlimited-OCR 可在 32K 上下文單次解析數十頁文件,官方提供 Transformers、vLLM 與 SGLang 三種部署路徑,並附批次推論腳本。
部署層面的支援相當完整。使用者可透過 Hugging Face Transformers 在 NVIDIA GPU 上直接載入模型,官方測試環境為 Python 3.12.3 搭配 CUDA 12.9,並提供 infer 與 infer_multi 兩組介面,前者處理單張影像、後者處理多頁文件。單張影像提供 gundam 與 base 兩種配置:gundam 採 1024 基準尺寸與 640 影像尺寸並開啟裁切模式,適合細節密集的頁面;base 則以 1024 全尺寸處理,適用於多頁與 PDF 情境。
推論框架方面,vLLM 社群已提供官方 recipe 與預建 Docker 映像,分別對應 CUDA 13.0 與 Hopper GPU 的 CUDA 12.9 版本;SGLang 亦提供完整啟動指令,透過 --context-length 32768 與自訂 logit processor 支援串流輸出。專案另附 infer.py 批次推論腳本,可自動啟動 SGLang 服務並對影像目錄或 PDF 發送並行請求,支援 --concurrency 參數控制併發數。針對學術評測,README 亦提供 OmniDocBench 所需的 <|det|> 標記清除與區塊重組後處理程式碼。
Unlimited-OCR 有哪些實際應用場景?
Unlimited-OCR 適用於掃描文件數位化、多頁 PDF 全文擷取、財報與合約批量解析、學術論文轉錄,以及需要長文件一次性處理且成本可控的企業文件自動化流程。
最直接的應用是文件數位化。傳統 OCR 流程面對數十頁掃描件時,往往必須切分頁面、逐頁推論、再手動拼接結果,過程中不僅耗時,跨頁的段落與表格也容易斷裂。Unlimited-OCR 以單次前向傳遞處理連續多頁,可維持章節結構與閱讀順序的完整性,對財報、合約、技術手冊等長文件尤其有利。
第二類場景是需要大量文件吞吐的企業流程。由於 KV 快取恆定,批次處理時的記憶體占用不隨文件長度線性成長,相同的 GPU 資源可承載更多並行請求,推論成本更容易預估。這對於發票、保單、申報文件的批量數位化具有實質意義。
第三類場景來自 R-SWA 的通用性。研究團隊指出該機制可延伸至自動語音辨識與機器翻譯,意味同一套技術路線有機會被用於會議逐字稿、長篇影音字幕與多語文件對齊等長時程任務。此外,模型以 MIT 授權釋出,企業可自行部署於內部環境,滿足金融、醫療、法律等行業對資料落地的要求。
Unlimited-OCR 的數據表現如何?
Unlimited-OCR 在 GitHub 累積 25,425 星標與 2,631 次複製,採 MIT 授權,語言為 Python,2026 年 6 月建立、9 月仍持續更新。


出處連結有哪些?
本文資訊來源為 Unlimited-OCR 的 GitHub 儲存庫與 arXiv 技術報告(編號 2606.23050),內容涵蓋星標、授權、架構設計與部署方式等公開資料。
出處連結:Unlimited-OCR GitHub 儲存庫。專案另有 Hugging Face 模型頁面、ModelScope 鏡像、vLLM 官方部署 recipe 與 arXiv 論文可供查閱。此外,README 致謝 DeepSeek-OCR、DeepSeek-OCR-2 與 PaddleOCR 等前序專案,反映該模型建立在既有開源成果之上。
總結:Unlimited-OCR 適合什麼團隊?
Unlimited-OCR 適合需要批量處理長文件、又希望控制推論成本的團隊,包括文件自動化服務商、金融與法律機構,以及研究長時程序列建模的開發者。
Unlimited-OCR 的價值在於把「長文件解析」從工程難題轉為可規模化的推論任務。它沒有重新發明 OCR 骨幹,而是在既有端到端架構上針對 KV 快取與注意力成本下手,並以 MIT 授權、完整的部署文件與多框架支援降低採用門檻。對需要處理數十頁文件、又必須預估 GPU 成本的團隊而言,恆定 KV 快取帶來的資源可預測性是關鍵優勢;對研究者而言,R-SWA 作為通用解析注意力機制,亦提供了可延伸至語音與翻譯任務的新思路。考量其 25K 星標的社群關注度與百度持續的維護投入,該專案具備成為長文件解析標準工具的潛力。