
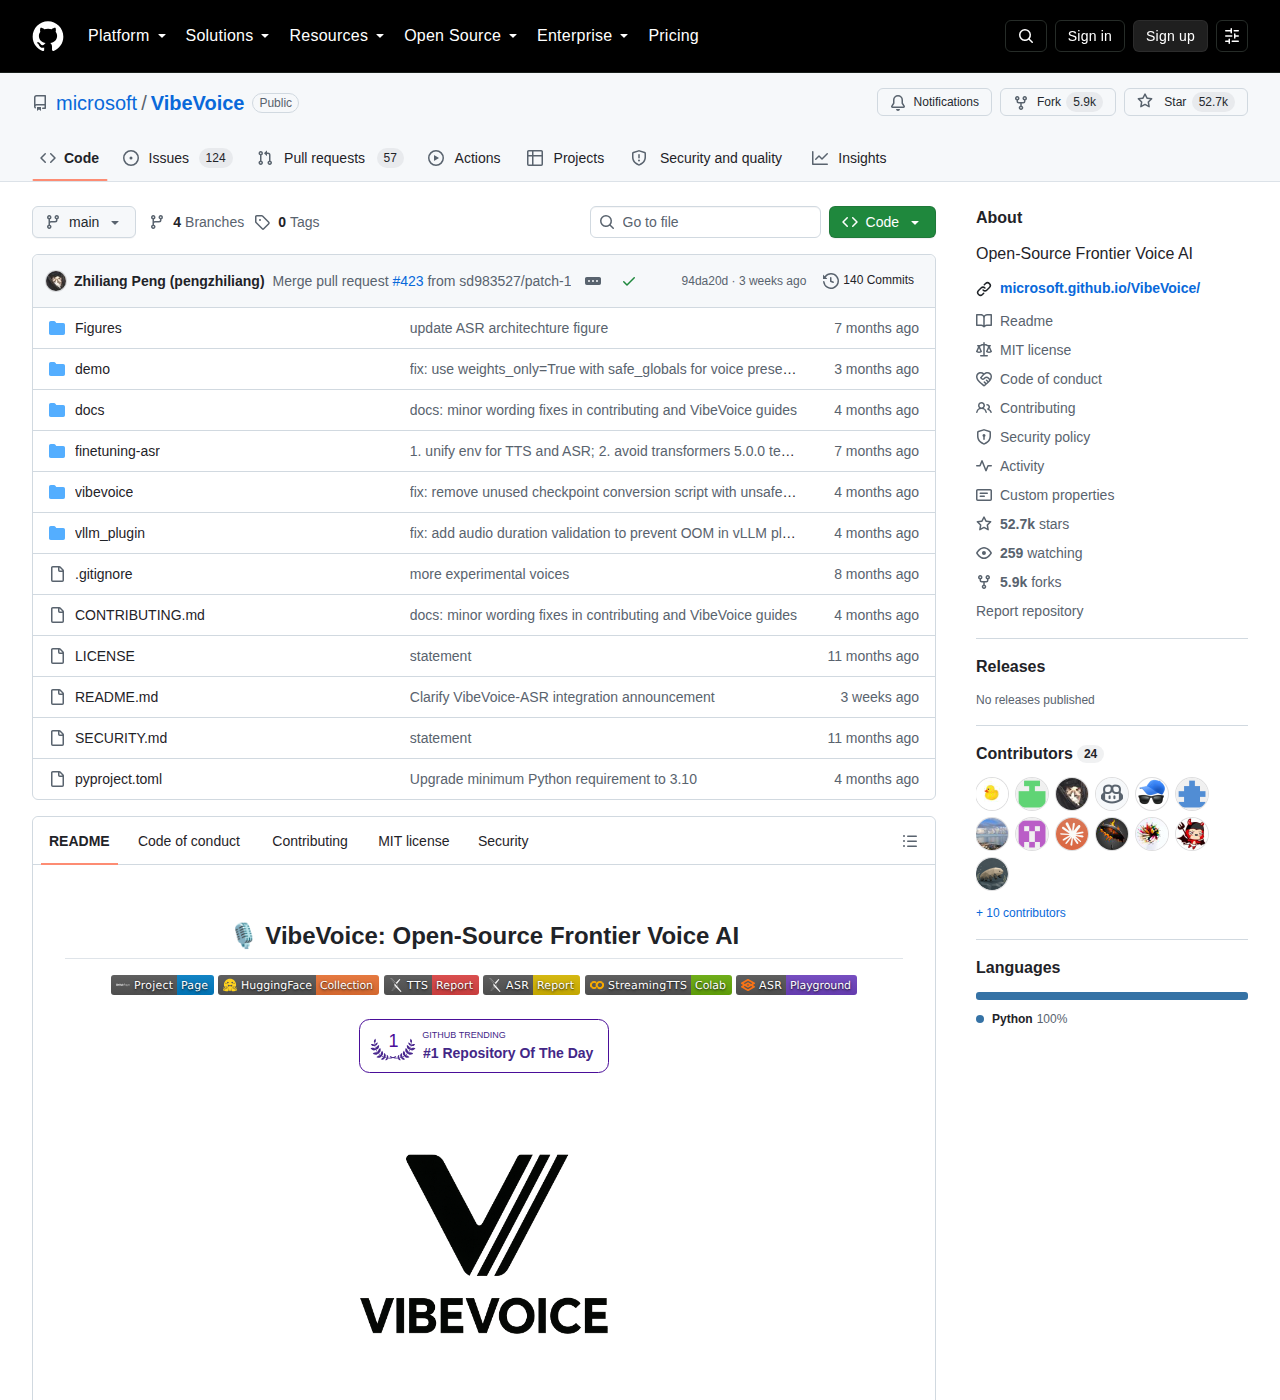
VibeVoice 是微軟開源的前沿語音 AI 模型家族,在 GitHub 上累積 52,713 顆星標與 5,948 次復刻,涵蓋語音辨識(ASR)、語音合成(TTS)與即時串流語音三大模型,以極低幀率的連續語音 Tokenizer 與 Next-Token Diffusion 架構實現長語音處理,採 MIT 授權免費開放,是當前開源語音領域星標成長最快的項目之一。
VibeVoice 是微軟開源的語音 AI 模型家族,GitHub 星標 52,713,涵蓋 ASR、TTS 與即時串流模型,以 7.5Hz 連續語音 Tokenizer 實現長語音處理,採 MIT 授權。
VibeVoice 是什麼?微軟為何開源語音 AI 家族?
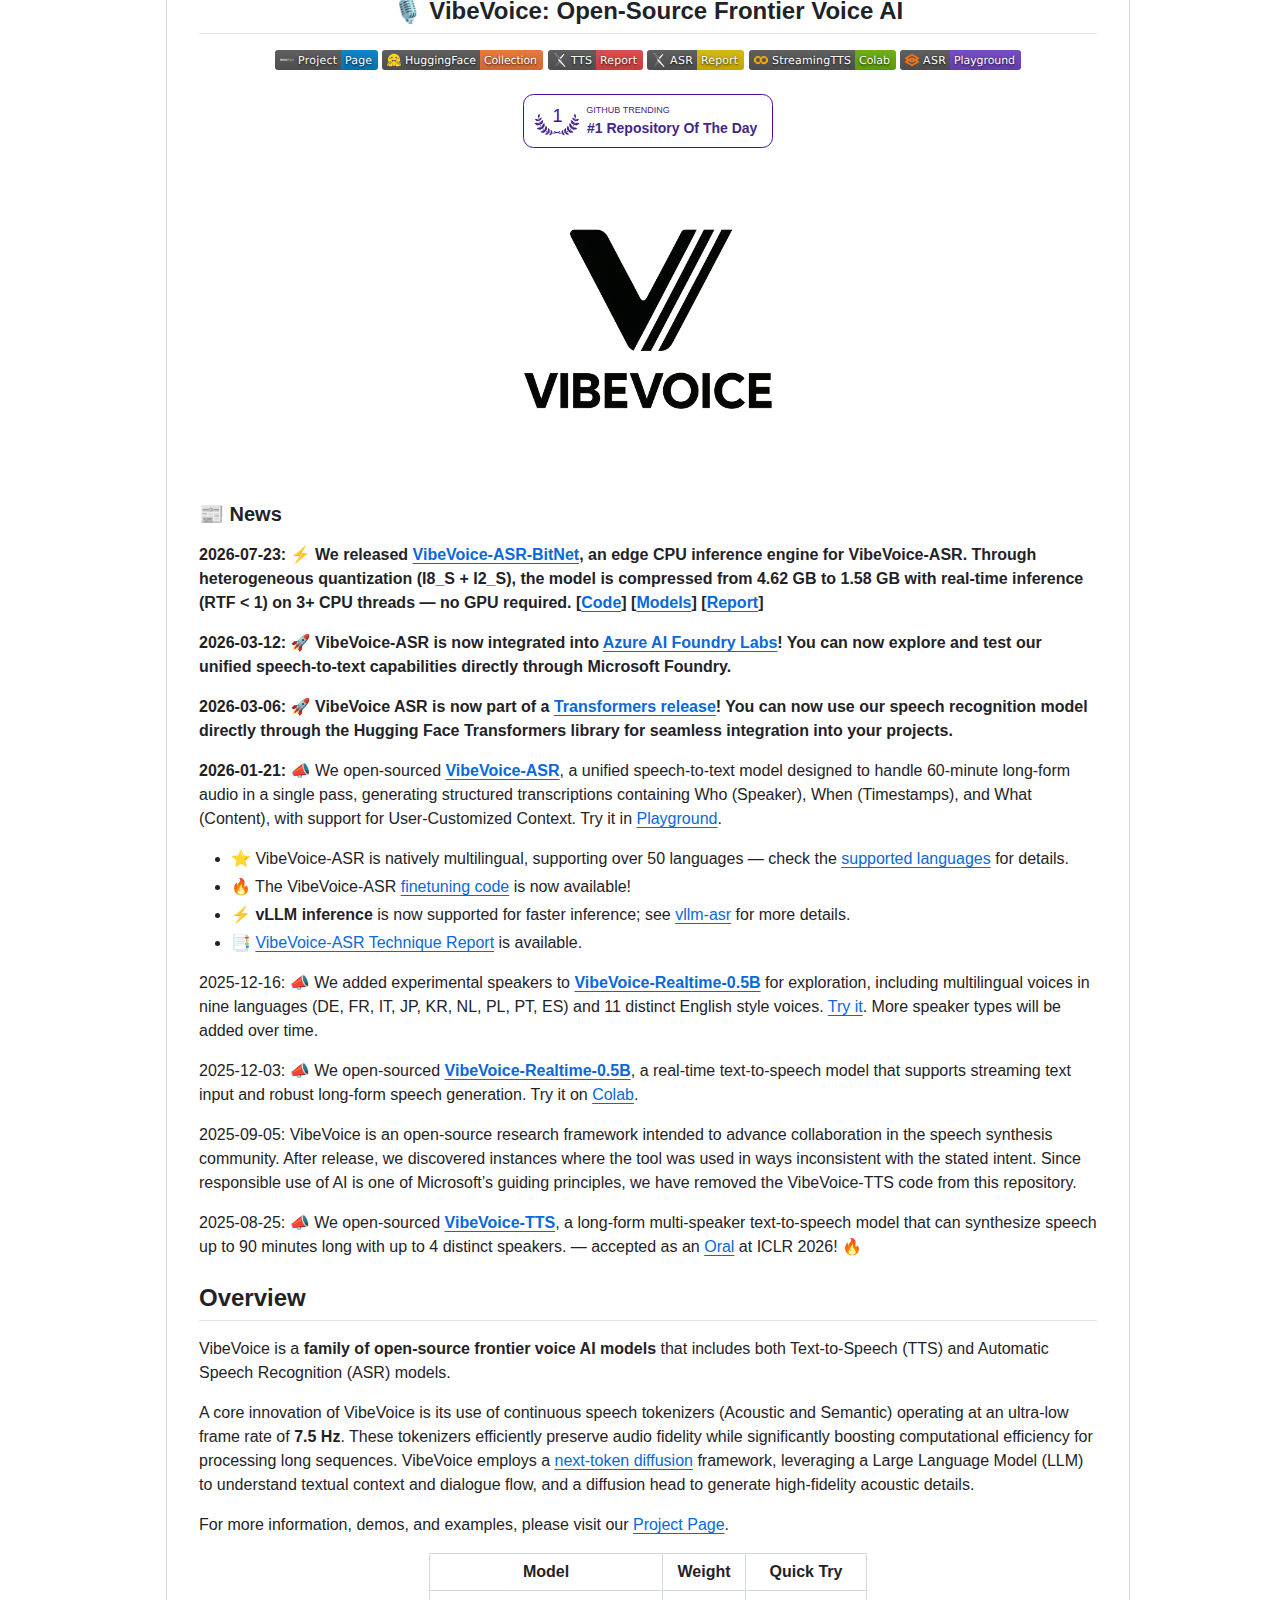
VibeVoice 是微軟在 2025 年 8 月推出的開源語音 AI 項目,定位為「開放原始碼的前沿語音 AI 家族」,由微軟語音研究團隊維護,並以 MIT 授權向社群開放。項目涵蓋三個核心模型:VibeVoice-ASR 負責語音轉文字,支援長達 60 分鐘音訊的單次辨識;VibeVoice-TTS 負責文字轉語音,可合成最多 90 分鐘、涵蓋 4 位不同說話人的長篇對話;VibeVoice-Realtime-0.5B 則以輕量參數規模提供即時串流語音合成。三大模型共同覆蓋了語音處理「聽」與「說」兩大方向,形成完整的研究與應用閉環。
VibeVoice 是微軟 2025 年 8 月推出的開源語音 AI 家族,以 MIT 授權開放,涵蓋 60 分鐘長語音辨識、90 分鐘多說話人語音合成與即時串流語音三大模型。
微軟開源 VibeVoice 的戰略意圖相當明確:透過開放原始碼搶佔語音 AI 的標準制定權,並將研究成果轉化為 Azure 雲端服務的技術儲備。項目發布後迅速在開源社群引起迴響,不到一年即累積超過 5.2 萬顆星標,2026 年 3 月 VibeVoice-ASR 更相繼整合進 Azure AI Foundry Labs 與 Hugging Face Transformers 生態,顯示微軟正同時布局商業雲端服務與開源社群兩條路線。
微軟開源 VibeVoice 旨在搶佔語音 AI 標準與 Azure 技術儲備,項目不到一年累積逾 5.2 萬星標,ASR 模型已整合進 Azure AI Foundry Labs 與 Hugging Face Transformers。
VibeVoice 的核心技術架構有什麼特別之處?
VibeVoice 最核心的技術創新在於其連續語音 Tokenizer 設計。傳統語音模型通常以 20 至 50Hz 的幀率處理音訊,而 VibeVoice 的聲學與語義 Tokenizer 僅以 7.5Hz 的超低幀率運作,在保留音訊保真度的同時大幅降低長序列處理的計算成本,這是模型能夠單次處理長達 60 至 90 分鐘音訊的關鍵基礎。
VibeVoice 採用 7.5Hz 超低幀率連續語音 Tokenizer,在保留音訊保真度的同時降低長序列計算成本,是支撐長達 90 分鐘語音處理的關鍵創新。
在生成架構上,VibeVoice 採用 Next-Token Diffusion 框架:以大型語言模型理解文本語境與對話流程,再由擴散頭(Diffusion Head)生成高保真的聲學細節。這種混合架構讓模型同時具備語言理解能力與音訊生成品質,既能在長篇對話中維持說話人一致性與語義連貫,又能產出自然的語調與情感層次。
VibeVoice 採 Next-Token Diffusion 框架,以 LLM 理解語境、擴散頭生成聲學細節,兼顧語言理解與音訊品質,在長對話中維持說話人一致性與語義連貫。
VibeVoice-ASR 如何處理長達 60 分鐘的語音?
VibeVoice-ASR 是項目中最受矚目的模型,其核心能力是單次處理長達 60 分鐘的連續音訊,並在 64K Token 長度內維持一致的說話人追蹤與語義連貫。與傳統將音訊切成短片段、容易遺失全局語境的 ASR 方案不同,VibeVoice-ASR 以完整長序列輸入,輸出具結構化的轉錄結果,標示「誰(說話人)在什麼時間(時間戳)說了什麼(內容)」,一次完成語音辨識、說話人分離與時間標記三項工作。
VibeVoice-ASR 單次處理 60 分鐘連續音訊,在 64K Token 內維持說話人追蹤與語義連貫,輸出包含說話人、時間戳與內容的結構化轉錄,一次完成辨識、分離與時間標記。
針對專業領域的辨識需求,模型支援自訂熱詞(Customized Hotwords)機制,用戶可提供特定人名、技術術語或背景資訊引導辨識過程,顯著提升專業內容的準確度。模型原生支援超過 50 種語言,並提供微調程式碼與 vLLM 推理加速支援,讓開發者可以針對特定領域或語言進一步調整模型。
VibeVoice-ASR 支援自訂熱詞提升專業內容辨識準確度,原生支援逾 50 種語言,提供微調程式碼與 vLLM 推理加速,適合領域客製化部署。
2026 年 7 月,微軟進一步發布 VibeVoice-ASR-BitNet 邊緣 CPU 推理引擎,透過異質量化(I8_S + I2_S)將模型從 4.62 GB 壓縮至 1.58 GB,在 3 條以上 CPU 執行緒上即可實現即時推理(RTF < 1),完全不需要 GPU,大幅降低語音辨識的部署門檻,讓一般筆電與伺服器也能執行高品質的長語音轉錄。
VibeVoice-ASR-BitNet 透過異質量化將模型由 4.62 GB 壓縮至 1.58 GB,在 CPU 上即時推理且不需 GPU,大幅降低長語音辨識的部署門檻。
VibeVoice-TTS 與即時語音模型表現如何?
VibeVoice-TTS 主打長篇多說話人語音合成,單次生成可達 90 分鐘的對話式語音,支援最多 4 位不同說話人同時參與,並在整個生成過程中維持說話人一致性與自然輪替。模型同時支援英文、中文及其他語言的跨語言合成,其技術論文已獲 ICLR 2026 接受為 Oral 口頭報告,學術認可度相當高。
VibeVoice-TTS 單次生成長達 90 分鐘、最多 4 位說話人的對話語音,支援中英文等跨語言合成,技術論文獲 ICLR 2026 Oral 口頭報告。
值得注意的是,微軟在 2025 年 9 月基於負責任 AI 原則,移除了 VibeVoice-TTS 的原始碼,原因是發布後發現工具被用於與既定目的不符的情境。目前 TTS 模型權重仍透過 Hugging Face 提供,但專案將重心轉向 ASR 與即時語音模型。這一調整反映語音合成技術在深度偽造風險下的敏感性,也顯示微軟在開源與安全之間取捨的態度。
微軟基於負責任 AI 原則於 2025 年 9 月移除 VibeVoice-TTS 原始碼,模型權重仍於 Hugging Face 提供,專案重心轉向 ASR 與即時語音模型。
即時語音方面,VibeVoice-Realtime-0.5B 以僅 0.5B 的參數規模實現即時串流語音合成,首字延遲約 300 毫秒,支援串流文字輸入與約 10 分鐘的穩健長篇生成,部署門檻低。2025 年 12 月更加入實驗性說話人聲線,涵蓋德、法、義、日、韓等九種語言與 11 種英文風格聲線,擴展了多語系應用的可能性。
VibeVoice-Realtime-0.5B 以 0.5B 參數實現約 300 毫秒首字延遲的即時串流合成,支援 10 分鐘長篇生成,並提供九種語言與 11 種英文風格的實驗聲線。
VibeVoice 對語音 AI 生態有何影響?
VibeVoice 的開源對語音 AI 生態的影響體現在三個層面。首先是技術標準的競爭:7.5Hz 連續語音 Tokenizer 與 Next-Token Diffusion 架構提供了一套可與閉源商業模型抗衡的開源方案,讓研究機構與中小企業不必依賴 API 也能建立自己的語音應用。其次是生態整合:VibeVoice-ASR 已納入 Hugging Face Transformers 官方發行版,開發者可以直接以一行指令載入模型,與既有 NLP 工作流程無縫銜接。
VibeVoice 開源影響體現在三層面:以 7.5Hz Tokenizer 架構提供可抗衡閉源模型的方案,ASR 已整合 Hugging Face Transformers,並透過 Azure AI Foundry 打通商業雲端路徑。
在商業化路徑上,微軟採取「開源社群 + 雲端服務」雙軌策略:模型以 MIT 授權免費開放,累積開發者生態與品牌影響力,同時透過 Azure AI Foundry Labs 提供受管的雲端服務,企業用戶可直接在微軟雲端使用相同技術而無需自行部署。這種模式與 OpenAI 的閉源策略形成鮮明對比,也反映了微軟「以開放換生態、以雲端變現」的一貫思路。
微軟採開源社群與雲端服務雙軌策略,模型 MIT 授權免費開放累積生態,同時在 Azure AI Foundry 提供受管服務,與 OpenAI 閉源策略形成對比。
從社群反饋來看,項目開放 181 個 Issue,討論涵蓋模型部署、微調與應用場景,顯示開發者對長語音處理能力有實際需求。加上 5,948 次復刻與持續的版本更新,VibeVoice 已成為開源語音領域不可忽視的力量,尤其在會議轉錄、播客製作、影音字幕與客服語音分析等長語音場景中具備明顯的應用潛力。
VibeVoice 開放 181 個 Issue,5,948 次復刻,社群對長語音處理需求明確;在會議轉錄、播客製作、字幕與客服語音分析等場景具備應用潛力。
常見問題有哪些?
VibeVoice 提供 60 分鐘長語音辨識、90 分鐘多說話人語音合成與即時串流語音模型,採 MIT 授權,支援逾 50 種語言,可透過 Hugging Face 與 Azure 使用。
VibeVoice 是免費的嗎? 是。VibeVoice 以 MIT 授權開放原始碼,模型權重可透過 Hugging Face 免費下載,商用與研究用途均不受限制,企業亦可選擇 Azure AI Foundry 受管服務。
VibeVoice 支援哪些語言? ASR 模型原生支援超過 50 種語言,TTS 模型支援英文、中文及其他多種語言,即時語音模型亦提供九種語言的實驗聲線。
VibeVoice-ASR 與一般語音辨識工具有何不同? 一般工具將音訊切成短片段處理,容易遺失全局語境;VibeVoice-ASR 單次處理長達 60 分鐘的音訊,並一次輸出說話人、時間戳與內容,特別適合會議錄音與長篇訪談轉錄。
VibeVoice-TTS 的原始碼為何被移除? 微軟在 2025 年 9 月基於負責任 AI 原則移除了 TTS 原始碼,原因是工具被用於與既定目的不符的情境;模型權重仍可於 Hugging Face 取得,專案重心轉向 ASR 與即時語音模型。
VibeVoice 需要什麼硬件才能運行? ASR 模型可透過 VibeVoice-ASR-BitNet 在純 CPU 環境即時推理,不需 GPU;Realtime-0.5B 參數規模僅 0.5B,一般裝置即可運行,另有 Colab 筆記本可直接試用。
總結:VibeVoice 值得一試嗎?
VibeVoice 以 52,713 顆星標、MIT 授權與完整的「辨識+合成+即時」模型矩陣,確立了其在開源語音 AI 領域的領先地位。項目的核心價值在於以 7.5Hz 連續語音 Tokenizer 解決了長語音處理的技術瓶頸,讓 60 分鐘的會議轉錄與 90 分鐘的對話合成成為單次即可完成的任務,這是多數開源語音方案無法比擬的能力。
VibeVoice 以 5.2 萬星標與完整模型矩陣確立開源語音 AI 領先地位,7.5Hz Tokenizer 解決長語音處理瓶頸,60 分鐘轉錄與 90 分鐘合成單次即可完成。
從使用角度評估,對於需要長語音轉錄的會議記錄、訪談整理與字幕製作場景,VibeVoice-ASR 的單次長序列處理與結構化輸出具有明顯優勢;對於語音合成應用,TTS 的多說話人能力雖因原始碼移除而受限,但模型權重仍可透過 Hugging Face 使用。加上 MIT 授權與 CPU 可跑的輕量部署方案,該項目是目前開源語音領域最值得嘗試的選擇之一,適合研究機構、開發者與內容創作者深入研究。
對長語音轉錄與字幕製作場景,VibeVoice-ASR 的單次處理優勢明顯;TTS 權重仍可用,加上 MIT 授權與 CPU 輕量部署,是開源語音領域最值得嘗試的項目之一。
出處連結有哪些?
本文資訊整理自 VibeVoice 官方 GitHub 專案,包含 README 文件、模型說明文件、Hugging Face 模型頁面與官方技術報告,讀者可直接前往項目頁面查看完整文件、原始碼與示範範例。