
whisper.cpp 是 GitHub 星標超過 52,957 顆的開源語音辨識項目,將 OpenAI 的 Whisper 自動語音辨識模型以純 C/C++ 無第三方依賴的方式重新實作,支援 CPU 與 Apple Silicon 原生推理,可完全離線運行在 PC、手機、單板電腦甚至網頁瀏覽器等各種裝置,MIT 開源授權免費開放,2022 年 9 月發布至今持續更新,是開源社群中部署語音轉文字功能最輕量、最通用的實現之一。
whisper.cpp 是 GitHub 逾 5 萬星的開源項目,以純 C/C++ 重新實作 OpenAI Whisper 語音辨識,零依賴、支援 CPU 與 Apple Silicon 原生推理,可離線運行於多種裝置,MIT 授權免費使用。
whisper.cpp 是什麼?
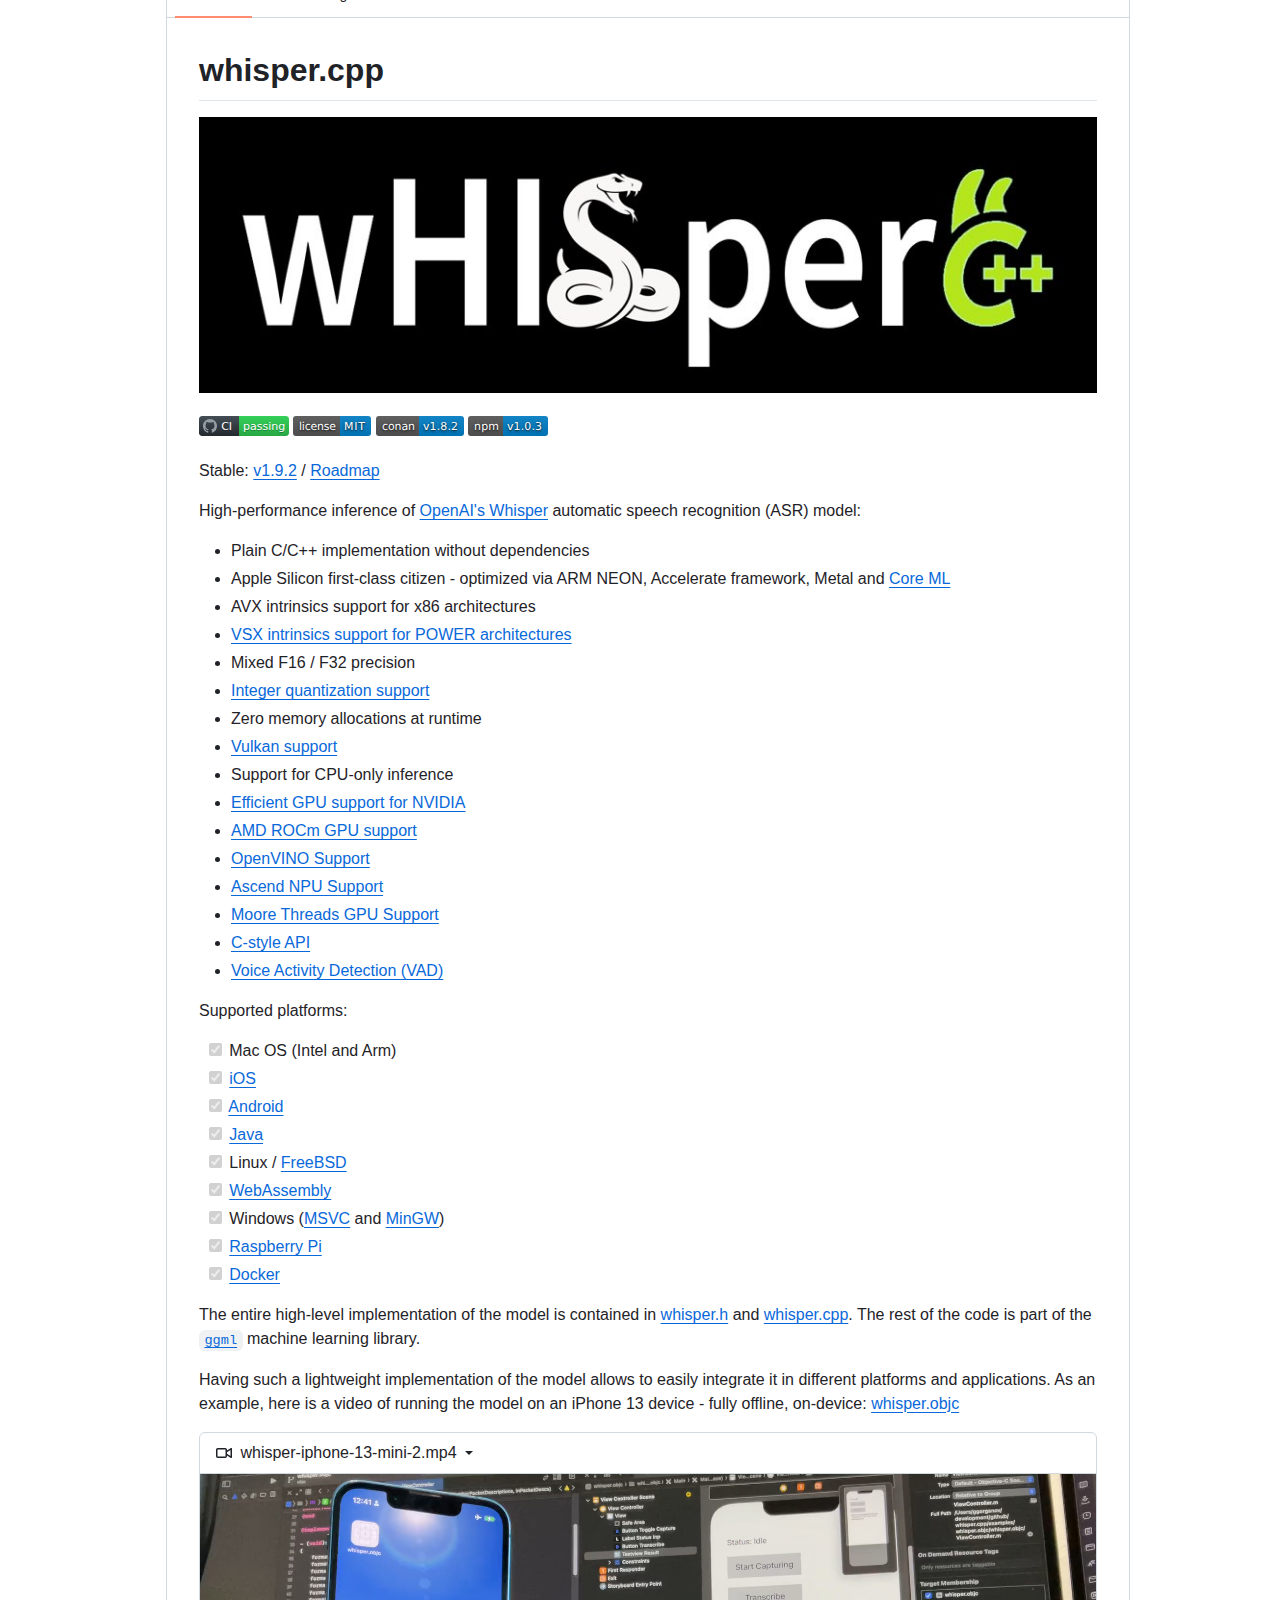
whisper.cpp 是由開發者 Georgi Gerganov 發起、現由 ggml-org 組織維護的開源項目,核心目標是將 OpenAI Whisper 這套功能強大的自動語音辨識(ASR)模型,以極度輕量且可移植的方式重新實作。與官方 Python 版不同,whisper.cpp 幾乎完全以 C/C++ 撰寫,不依賴 Python 執行環境或任何第三方深度學習框架,整個高層模型的實作都集中在 whisper.h 與 whisper.cpp 兩個檔案之中,其餘部分則是基於自家 ggml 機器學習函式庫。
whisper.cpp 是 Georgi Gerganov 發起、ggml-org 維護的開源項目,以 C/C++ 重新實作 OpenAI Whisper 語音辨識,不依賴 Python 或第三方框架,僅靠 whisper.h 與 ggml 實現。
項目的核心價值在於「把語音辨識從雲端搬回本地」。官方 Whisper 模型需要較高的運算資源,而 whisper.cpp 透過 ggml 函式庫針對常見硬件進行深度優化,讓 Apple Silicon 成為「頭等公民」——利用 ARM NEON、Accelerate 框架與 Metal 進行加速,也支援 x86 的 AVX 指令集、POWER 架構的 VSX 指令集,以及 NVIDIA CUDA、AMD ROCm、Vulkan、OpenVINO、Ascend NPU 等各種硬體平台,最終達到無需網路連線、無需付費即可在個人設備上完成語音轉文字的目標。
項目核心是將語音辨識從雲端搬回本地,透過 ggml 針對 Apple Silicon、x86、NVIDIA、AMD 及 Arm 等硬件深度優化,實現離線、免費的語音轉文字。
whisper.cpp 有哪些核心技術亮點?
whisper.cpp 最突出的技術亮點之一就是「純 C/C++、零依賴」的設計哲學。整個模型不需要額外安裝 Python、PyTorch 或 CUDA 環境,只要編譯一次即可將語音辨識能力嵌入任何應用程式,這對嵌入式開發、桌面工具與跨平台應用特別有價值。內建的 ggml 函式庫支援混合 F16/F32 精度與整數量化,一個量化後的模型檔案會比原版佔用更少的磁碟與記憶體,同時在部分硬體上還能提升處理效率。
核心亮點是純 C/C++ 零依賴設計,不需 Python 或深度學習框架即可嵌入任何應用;支援混合精度與整數量化,減少記憶體與磁碟佔用並提升部分硬體效率。
在運行效能方面,whisper.cpp 對 Apple Silicon 提供第一等支援,透過 Core ML 將 Encoder 推理交由 Apple 神經網路引擎(ANE)執行,官方指出可比純 CPU 快超過三倍;同時維持「運行時零記憶體分配」的特性,適合在資源受限的裝置上穩定執行。此外,模型支援多種尺寸——從僅 75 MiB 磁碟空間的 tiny 模型到 2.9 GiB 的 large 模型,記憶體需求約在 273 MB 至 3.9 GB 之間,讓用戶可以依照硬體條件自由取捨準確度與速度。
Apple Silicon 透過 Core ML 讓推理比純 CPU 快逾三倍,並實現運行時零記憶體分配;提供 tiny 至 large 多種模型尺寸,記憶體需求 273 MB 至 3.9 GB,可按硬體彈性選擇。
whisper.cpp 支援哪些平台與硬體加速?
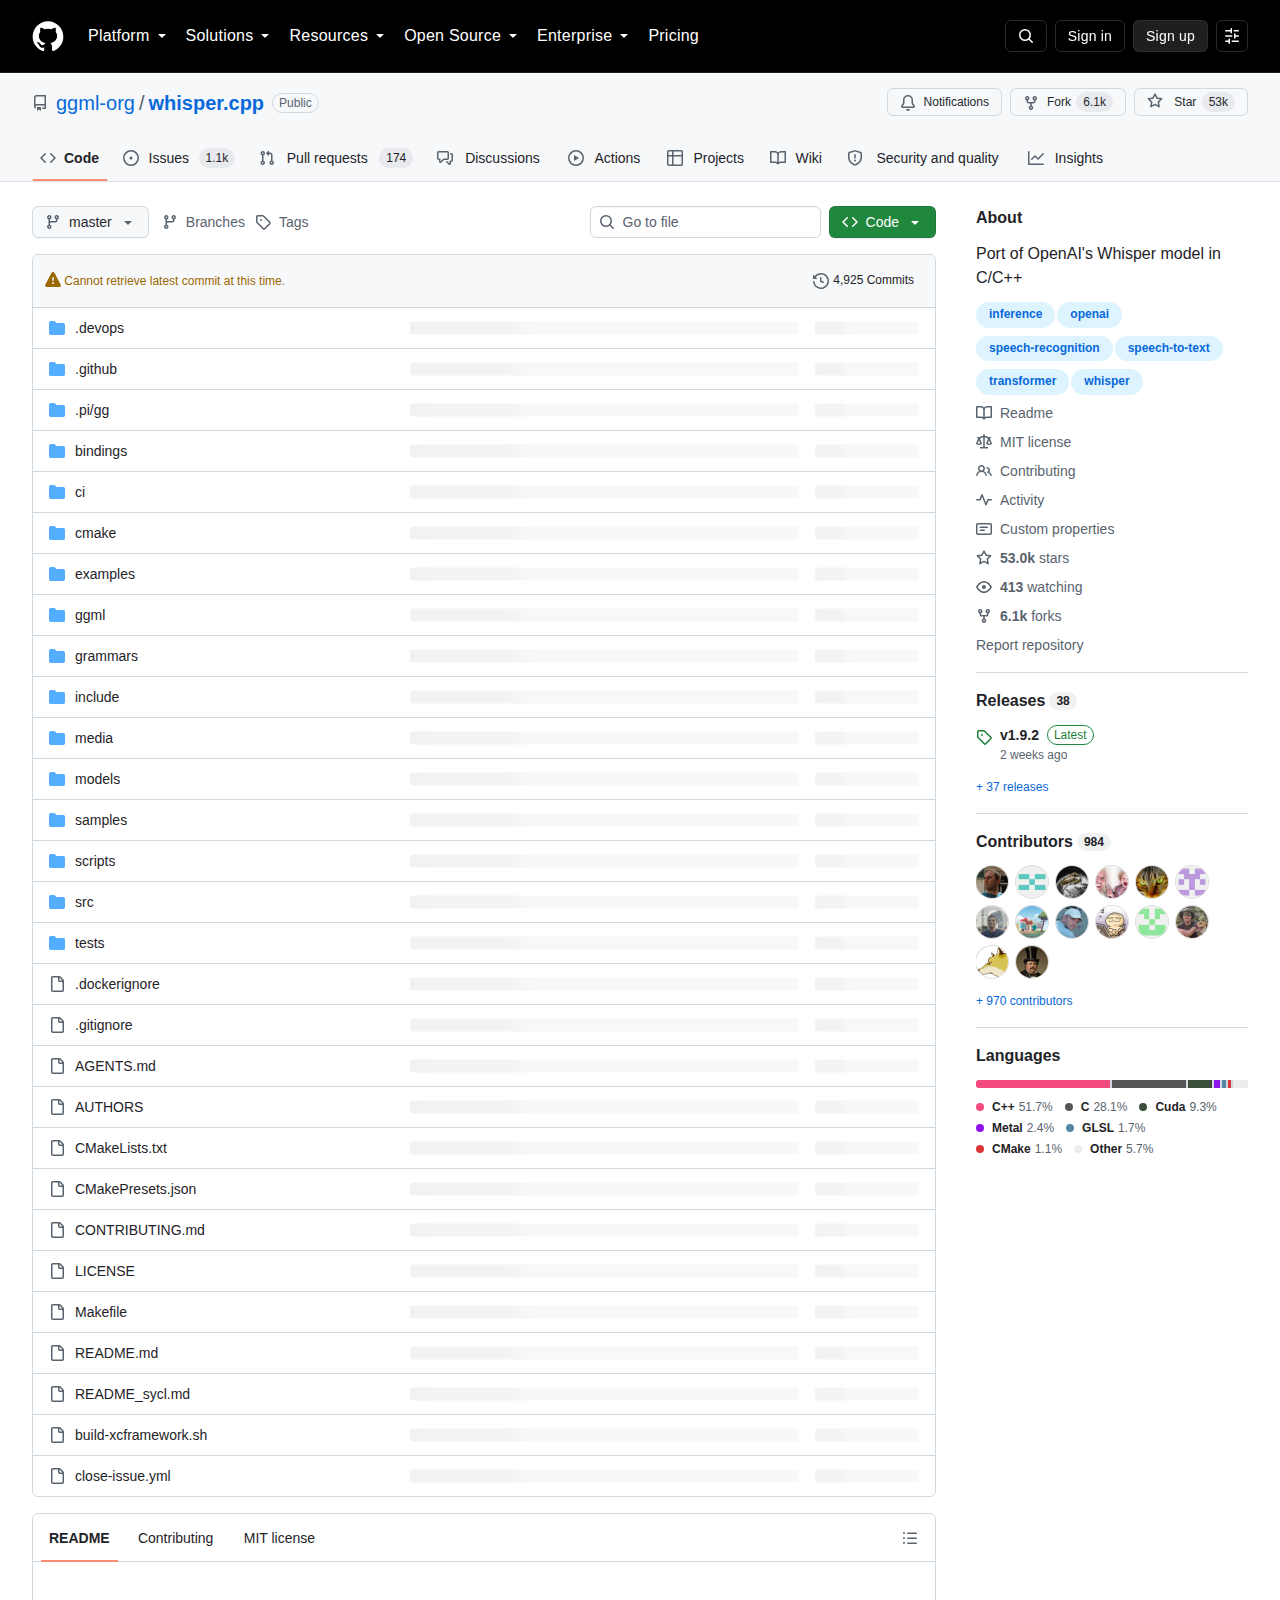
whisper.cpp 的跨平台支援範圍在開源語音辨識項目中名列前茅。官方支援清單涵蓋 macOS(Intel 與 Arm)、Linux、Windows(MSVC 與 MinGW)、FreeBSD,以及 iOS、Android、Java、Raspberry Pi 等單板電腦,更可透過 WebAssembly 在網頁瀏覽器內直接運行。這種「一次編譯、處處運行」的特性,使開發者能用同一套程式碼同時覆蓋桌面、行動裝置與嵌入式的部署需求。
官方支援 macOS、Linux、Windows、FreeBSD、iOS、Android、Raspberry Pi,並可透過 WebAssembly 在瀏覽器中運行,是跨平台覆蓋最廣的開源語音辨識項目之一。
在硬體加速方面,項目針對 NVIDIA GPU 提供 CUDA/cuBLAS 加速,針對 AMD GPU 提供 HIP/ROCm 加速,並支援跨廠商的 Vulkan 方案;Intel 平台的 OpenVINO、華為昇騰 NPU、摩爾線程 GPU 等也都有對應支援。透過 CMake 的多個開關,開發者只需改變建置參數即可針對特定硬件啟用加速,例如 -DGGML_CUDA=1 啟用 NVIDIA、-DWHISPER_OPENVINO=1 啟用 OpenVINO,彈性極高。官方同時提供多個 Docker 鏡像,包含一般版、CUDA 版與 MUSA 版,方便伺服器端部署。
硬體加速支援 CUDA、ROCm、Vulkan、OpenVINO、昇騰 NPU 與摩爾線程 GPU,透過 CMake 開關即可啟用;官方提供多個 Docker 鏡像方便伺服器部署。
whisper.cpp 如何做到即時語音轉文字?
除了批次處理音訊檔案,whisper.cpp 也提供即時語音辨識的範例工具 whisper-stream,可以接上麥克風,每半秒取樣一次音訊並持續輸出轉錄結果,即時顯示在終端機上。此外,內建的 Voice Activity Detection(VAD)功能會先以 Silero-VAD 等輕量模型偵測語音片段,只將含有人聲的段落送入 Whisper 模型處理,大幅減少無意義音訊的運算量,從而顯著加快轉錄速度。
whisper-stream 可接麥克風每半秒取樣持續轉錄;Voice Activity Detection 先以輕量模型偵測語音片段,只處理含人聲的段落,顯著加快轉錄速度。
在輸出格式上,項目具備豐富的進階能力:--print-colors 可用顏色標示每個字詞的辨識信心度、--max-len 可輸出逐字時間戳記、tinydiarize 提供實驗性的說話者分段功能、-owts 參數更能產出卡拉 OK 風格的逐字高亮影片。這些工具讓語音轉文字不僅是「跑出文字」,還能應用在字幕製作、逐字稿校對、互動語音助理與影音內容後製等更專業的場景。
輸出支援信心度顏色標示、逐字時間戳記、說話者分段與卡拉 OK 風格拉片,適用於字幕製作、逐字稿校對與影音後製等專業場景。
whisper.cpp 的生態系統與商業化潛力如何?
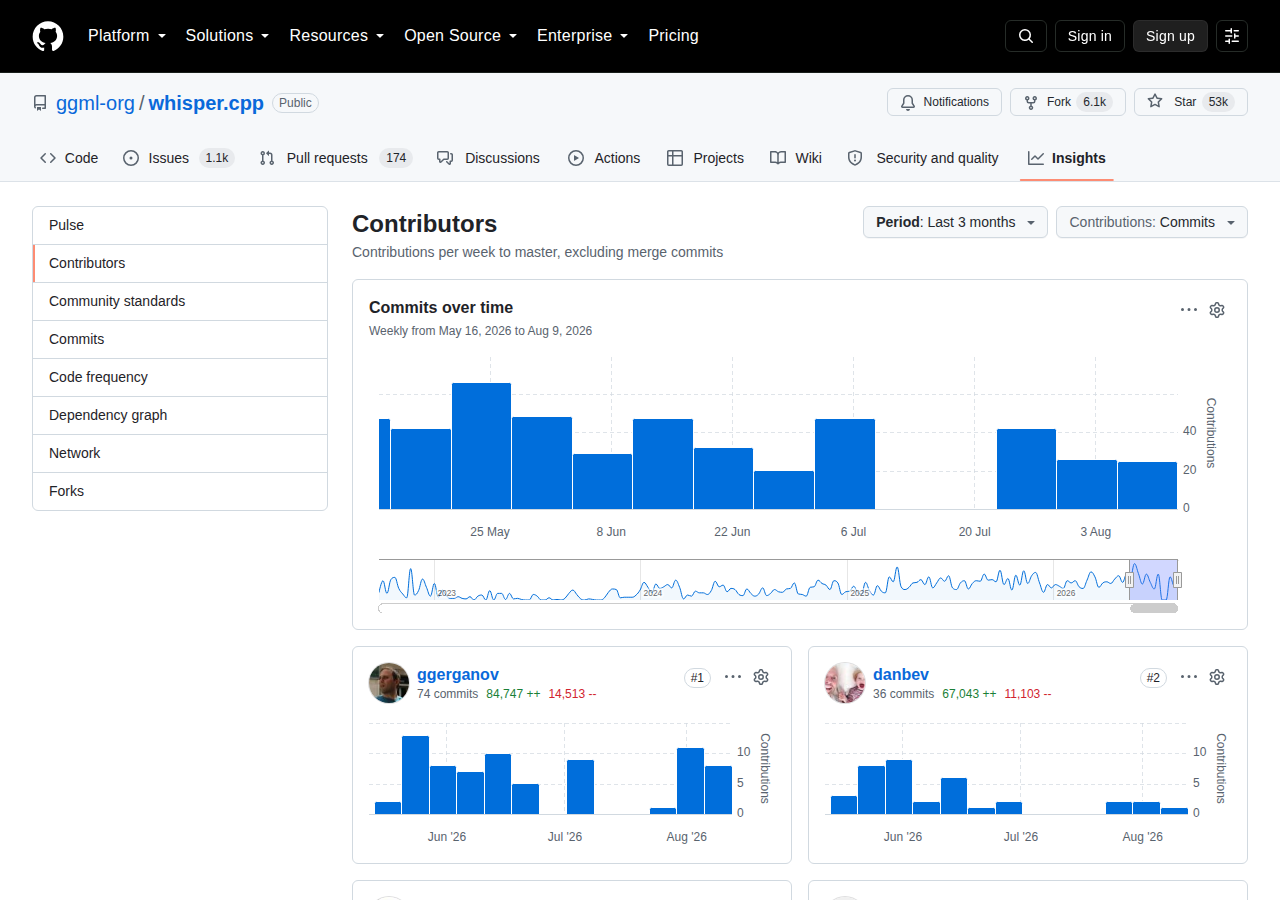
whisper.cpp 不只是一個單一工具,更圍繞著完整的生態系統。官方社群提供了 Rust、JavaScript、Go、Java、Ruby、.NET、Python、Swift、Unity 等多種語言的綁定,讓不同技術背景的開發者都能夠在自己的專案中呼叫語音辨識功能;常見的 React Native 套件、Swift 套件與 Python 封裝讓它非常容易整合。加上 whisper-server 提供與 OpenAI 相容的 HTTP 轉錄 API,開發者可以輕鬆將其部署為自家的語音辨識服務端點。
社群提供 Rust、JS、Go、Java、.NET、Python、Swift、Unity 等多語言綁定,whisper-server 提供 OpenAI 相容 API,生態成熟且易於整合至自有服務。
在商業化與應用層面,MIT 授權允許完全免費的商用,加上離線運行的隱私優勢,使其成為需要處理敏感語音資料公司、或者在雲端成本高企場景下的理想選擇。結合即時辨識、逐字時間戳記與說話者分段等能力,whisper.cpp 已被大量應用於會議轉錄、VoIP 語音客服、字幕生成與語音控制等產品之中,在本機端 AI 的浪潮下,其地位與日俱增。
MIT 授權允許免費商用,離線運行具隱私優勢,廣泛應用於會議轉錄、語音客服、字幕生成與語音控制等產品,在本機端 AI 浪潮中地位日增。
如何快速開始使用 whisper.cpp?
要開始使用 whisper.cpp,最快的方式是直接從 GitHub 複製儲存庫,下載官方轉換好的模型,再編譯命令列工具並轉錄一段音訊。具體步驟為:先用 git clone 取得源碼,再用 sh ./models/download-ggml-model.sh base.en 下載 base.en 模型,接著以 CMake 建置專案,最後以 ./build/bin/whisper-cli -f samples/jfk.wav 完成一次轉錄。整個過程不需 Python 環境,只要具備 C++ 編譯工具鏈即可。
快速入門:git clone 源碼、下載 base.en 模型、CMake 建置,再以 whisper-cli -f 轉錄音訊,不需 Python 環境,只要 C++ 編譯工具鏈即可。
對於想立即體驗效果的開發者,make base.en 一條指令就會自動下載模型並對內建範例音訊進行推理;若輸入的是其他格式音訊,官方建議先用 ffmpeg 轉換為 16-bit WAV。需要以服務形式整合的人可以啟動 whisper-server,而希望做性能評估的則可運用 whisper-bench 進行基準測試。整體而言,whisper.cpp 提供了從單機測試到伺服器部署的一條龍輕量方案。
make base.en 可一鍵體驗,ffmpeg 可轉換其他格式;whisper-server 提供服務化整合,whisper-bench 提供基準測試,提供從單機到伺服器的一條龍方案。
出處連結有哪些?
本篇文章的資訊來源為 whisper.cpp 的 GitHub 官方儲存庫,包含 README 說明文件、版本發布紀錄、官方範例與社群討論。有興趣的讀者可以前往 GitHub 查看原始碼、功能更新與跨平台使用方式。
本篇文章資訊來自 whisper.cpp 官方 GitHub 儲存庫,包含 README、版本發布紀錄、官方範例與社群討論,讀者可前往查看原始碼與功能更新。
出處:ggml-org/whisper.cpp — GitHub
常見問題有哪些?
總結:whisper.cpp 值得一試嗎?
whisper.cpp 以 5.2 萬顆星標證明了「本機端語音辨識」的龐大需求與其技術實力的領先地位。它以純 C/C++ 的零依賴設計、橫跨桌面、行動與瀏覽器的廣闊平台支援,以及對 Apple Silicon 等多種硬體的深度優化,把過去需要雲端算力與付費服務的語音轉文字,壓縮到「一支離線、免費、可嵌入任何裝置」的解決方案。對於希望控制隱私、節省雲端成本的開發者與產品團隊而言,whisper.cpp 提供了一套極具價值且成熟穩定的開源選擇,絕對值得一試。
whisper.cpp 以 5.2 萬星標驗證本機端語音辨識需求,零依賴設計、平台覆蓋廣、硬體優化深,提供離線免費可嵌入的語音轉文字方案,值得一試。