
Whisper 是 OpenAI 開源的通用語音識別模型,在 GitHub 上累積逾 106,800 顆星標,以超過 68 萬小時的多語言音訊進行弱監督訓練,可同時執行多語言語音轉錄、語音翻譯與語言識別等多項任務,採 MIT 授權,官方定位為「Robust Speech Recognition via Large-Scale Weak Supervision」。 此項目於 2022 年 9 月發布,以 Python 撰寫,提供 tiny 至 large 六種模型尺寸及優化的 turbo 版本,成為開源語音 AI 領域應用最廣泛的基礎模型之一。本文將從官方 README 與技術論文出發,分析 Whisper 的架構設計、部署方式與生態影響。
Whisper 是什麼?
Whisper 是 OpenAI 發布的通用語音識別模型,以逾 68 萬小時多語言音訊訓練,支援多語言轉錄、語音翻譯與語言識別,提供六種模型尺寸,採 MIT 授權,GitHub 星標逾 10.7 萬。
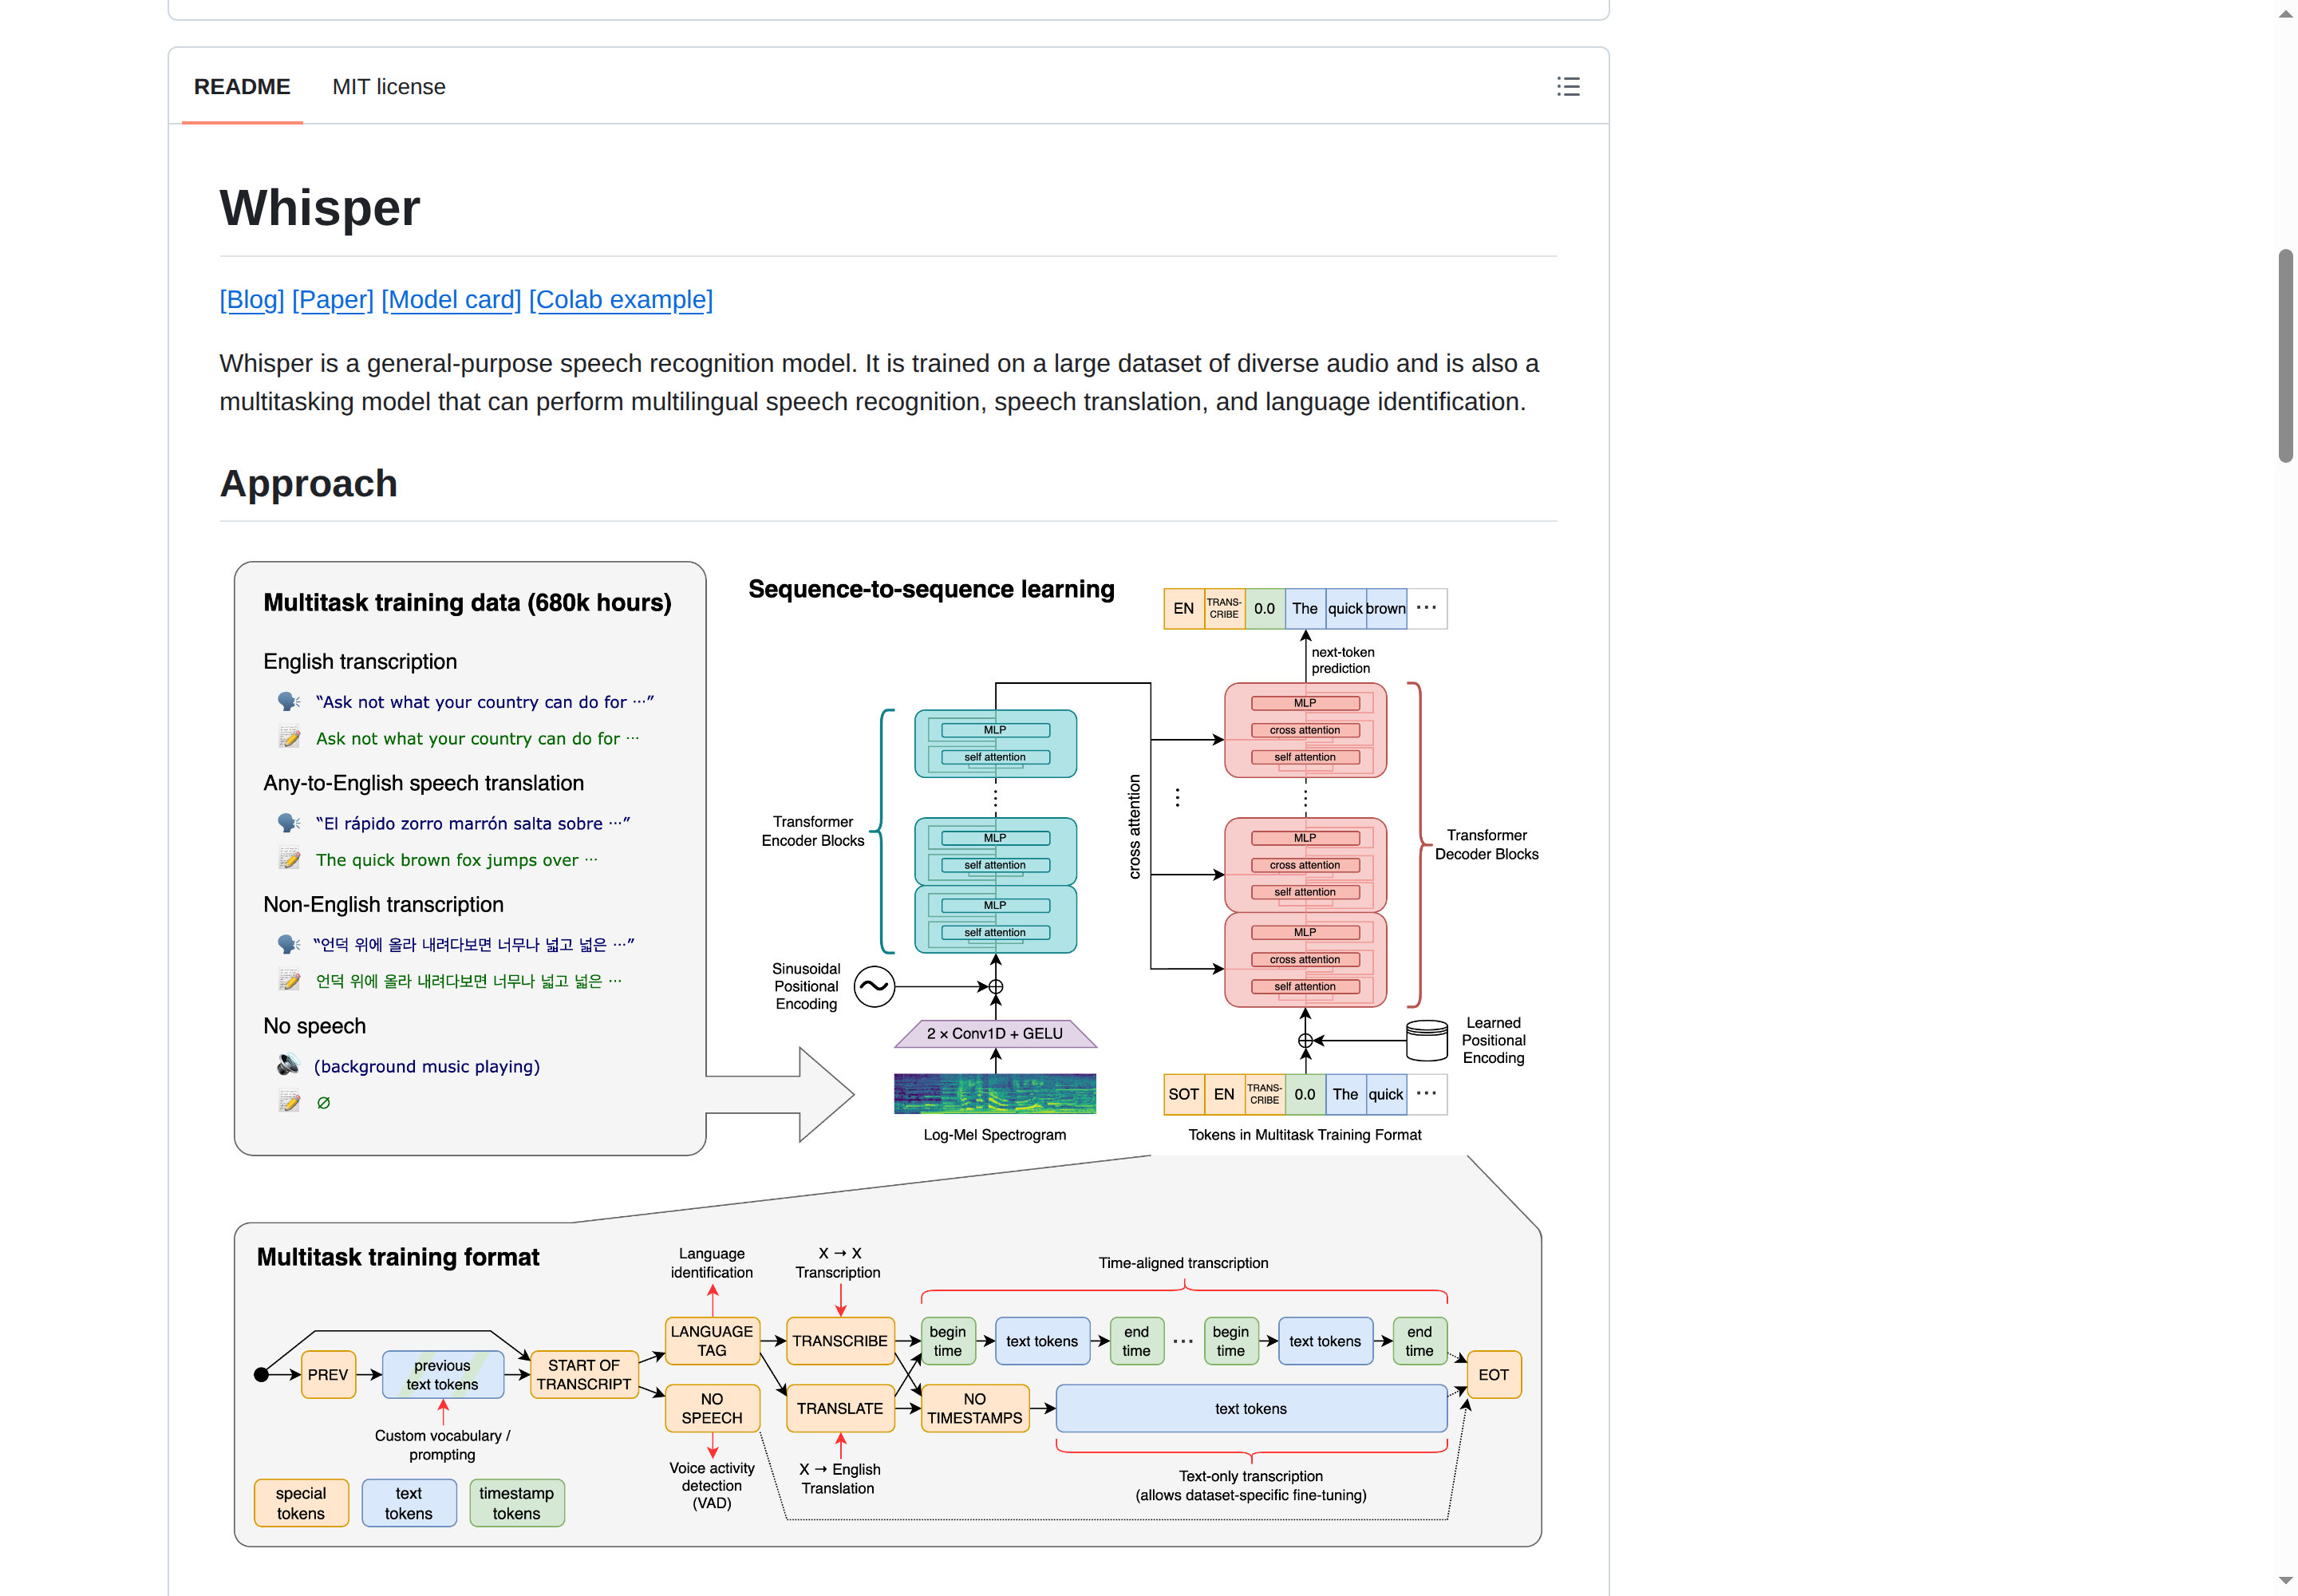
Whisper 是 OpenAI 於 2022 年 9 月開源的通用語音識別模型,其核心特點在於「通用」二字:一套模型即可處理多語言語音轉錄、任意語言到英語的語音翻譯、口語語言識別與語音活動偵測等多項任務,取代傳統語音處理管線中多個獨立元件。模型採用 Transformer 序列到序列架構,透過大規模弱監督學習,從網路收集的逾 68 萬小時多語言音訊中學習語音與文字之間的對應關係。
項目的訓練數據涵蓋英語轉錄、非英語轉錄、任意語言翻譯至英語以及無語音片段等多種類型,並以特殊 token 標記任務類型,例如語言標籤、轉錄指令、翻譯指令與時間戳記控制等。這套多任務訓練格式讓單一模型得以同時勝任多種語音任務,是 Whisper 與傳統語音辨識系統最顯著的差異。官方提供論文、模型卡與 Colab 範例,並以 MIT 授權開放原始碼與模型權重。
Whisper 有哪些核心技術亮點?
Whisper 以 Transformer 序列到序列架構為核心,將多種語音任務統一表示為 token 序列,透過特殊任務 token 控制輸出格式,並以逾 68 萬小時弱監督數據訓練,實現多語言轉錄、翻譯與語言識別。
Whisper 的第一項技術亮點是其多任務訓練架構。模型將語音處理任務統一表示為 decoder 預測的 token 序列,由一組特殊 token 充當任務指定器與分類目標,例如語言標籤、轉錄或翻譯指令、語音活動標記與時間戳記 token。這意味著傳統管線中分離的語音活動偵測、語言識別、轉錄與翻譯階段,可以收斂為單一模型的端到端預測,大幅簡化系統複雜度。
第二項亮點是完整的模型尺寸梯度。Whisper 提供 tiny、base、small、medium、large 五種基礎尺寸,參數量從 3,900 萬至 15.5 億不等,並為前四種尺寸提供僅限英語的 .en 版本;turbo 版本則以 8.09 億參數達到約八倍的推論加速,是 large-v3 的優化版本,在速度與準確度之間取得平衡。小型模型僅需約 1 GB 顯示記憶體即可運行,使語音識別能力得以部署於個人電腦與邊緣裝置。
第三項亮點是輸入處理的簡潔設計。模型將音訊轉換為 log-Mel 頻譜圖作為輸入,以滑動 30 秒視窗進行自回歸序列到序列預測,並支援語言自動偵測、時間戳記輸出與多語言翻譯。官方同時提供命令列工具與 Python API,Python 介面公開 load_model、transcribe、detect_language 與 decode 等低階方法,方便開發者進行細粒度控制與二次開發。
如何快速開始使用 Whisper?
安裝 Whisper 只需執行 pip install -U openai-whisper 並安裝 ffmpeg,即可透過 whisper 命令列或 Python API 轉錄音訊;預設 turbo 模型適合英文,翻譯任務則建議使用 medium 或 large 模型。
Whisper 的安裝流程十分直接。開發者先以 pip install -U openai-whisper 安裝套件,並確保系統已安裝 ffmpeg,後者可透過 Ubuntu、Homebrew、Chocolatey 或 Scoop 等套件管理工具取得;若 tiktoken 未有預編譯版本,則需額外安裝 Rust 開發環境。安裝完成後,即可使用 whisper 命令列工具轉錄音訊檔案,例如執行 whisper audio.flac audio.mp3 audio.wav –model turbo,預設即採用 turbo 模型處理英文語音。
對於需要翻譯非英語語音的場景,官方明確建議改用 tiny、base、small、medium 或 large 等多語言模型,因為 turbo 模型並未針對翻譯任務訓練;執行 whisper japanese.wav –model medium –language Japanese –task translate 即可將日語語音翻譯為英語。命令列工具支援指定語言、輸出格式與時間戳記等參數,開發者可透過 whisper –help 查看完整選項。
Python 使用者則可透過簡潔的 API 整合語音識別能力:以 whisper.load_model(“turbo”) 載入模型後,呼叫 model.transcribe(“audio.mp3”) 即可取得轉錄文字;需要低階控制時,可使用 load_audio、log_mel_spectrogram、detect_language 與 decode 等方法,自行組合音訊前處理、語言偵測與解碼流程,適合建置自訂語音應用。
Whisper 的市場定位與生態影響如何?
Whisper 定位為開源通用語音識別基礎模型,以 MIT 授權與多尺寸模型降低部署門檻,帶動 whisper.cpp、faster-whisper 等衍生生態,成為語音 AI 應用的事實標準之一。
Whisper 身處的語音識別賽道過去長期由商業雲端服務主導,開發者需要付費呼叫 API 並受供應商鎖定;Whisper 以 MIT 授權開源模型權重,讓開發者可以自由下載、部署與修改,將語音識別能力從雲端服務帶回本地端。逾 68 萬小時的多語言訓練數據與 96 種語言支援,使其在語音翻譯與低資源語言場景具備顯著優勢,打破過往英語優先的技術格局。
從生態角度觀察,Whisper 的開源策略催生了龐大的衍生工具鏈。社群圍繞 Whisper 開發了 whisper.cpp(C/C++ 本地推論)、faster-whisper(CTranslate2 加速)、whisperX(詞級時間戳對齊)等優化實作,以及大量 Web 示範與第三方整合,這些衍生項目多數同樣採用開源授權,形成以 Whisper 為核心的語音處理生態。OpenAI 官方亦持續維護此項目,並以論文、模型卡與範例筆記本降低研究與應用門檻。
Whisper 對 AI 基礎設施的影響具有指標意義。作為少數以 MIT 授權釋出的大型語音模型,它讓語音轉錄、會議紀要、字幕生成、語音助理與多語言翻譯等應用得以在本地端低成本運行,與 vLLM、Ollama 等開源 AI 基礎設施項目形成互補。隨着邊緣運算與隱私保護需求上升,具備離線能力的 Whisper 生態預期將持續擴大影響範圍。
Whisper 的關鍵數據表現如何?
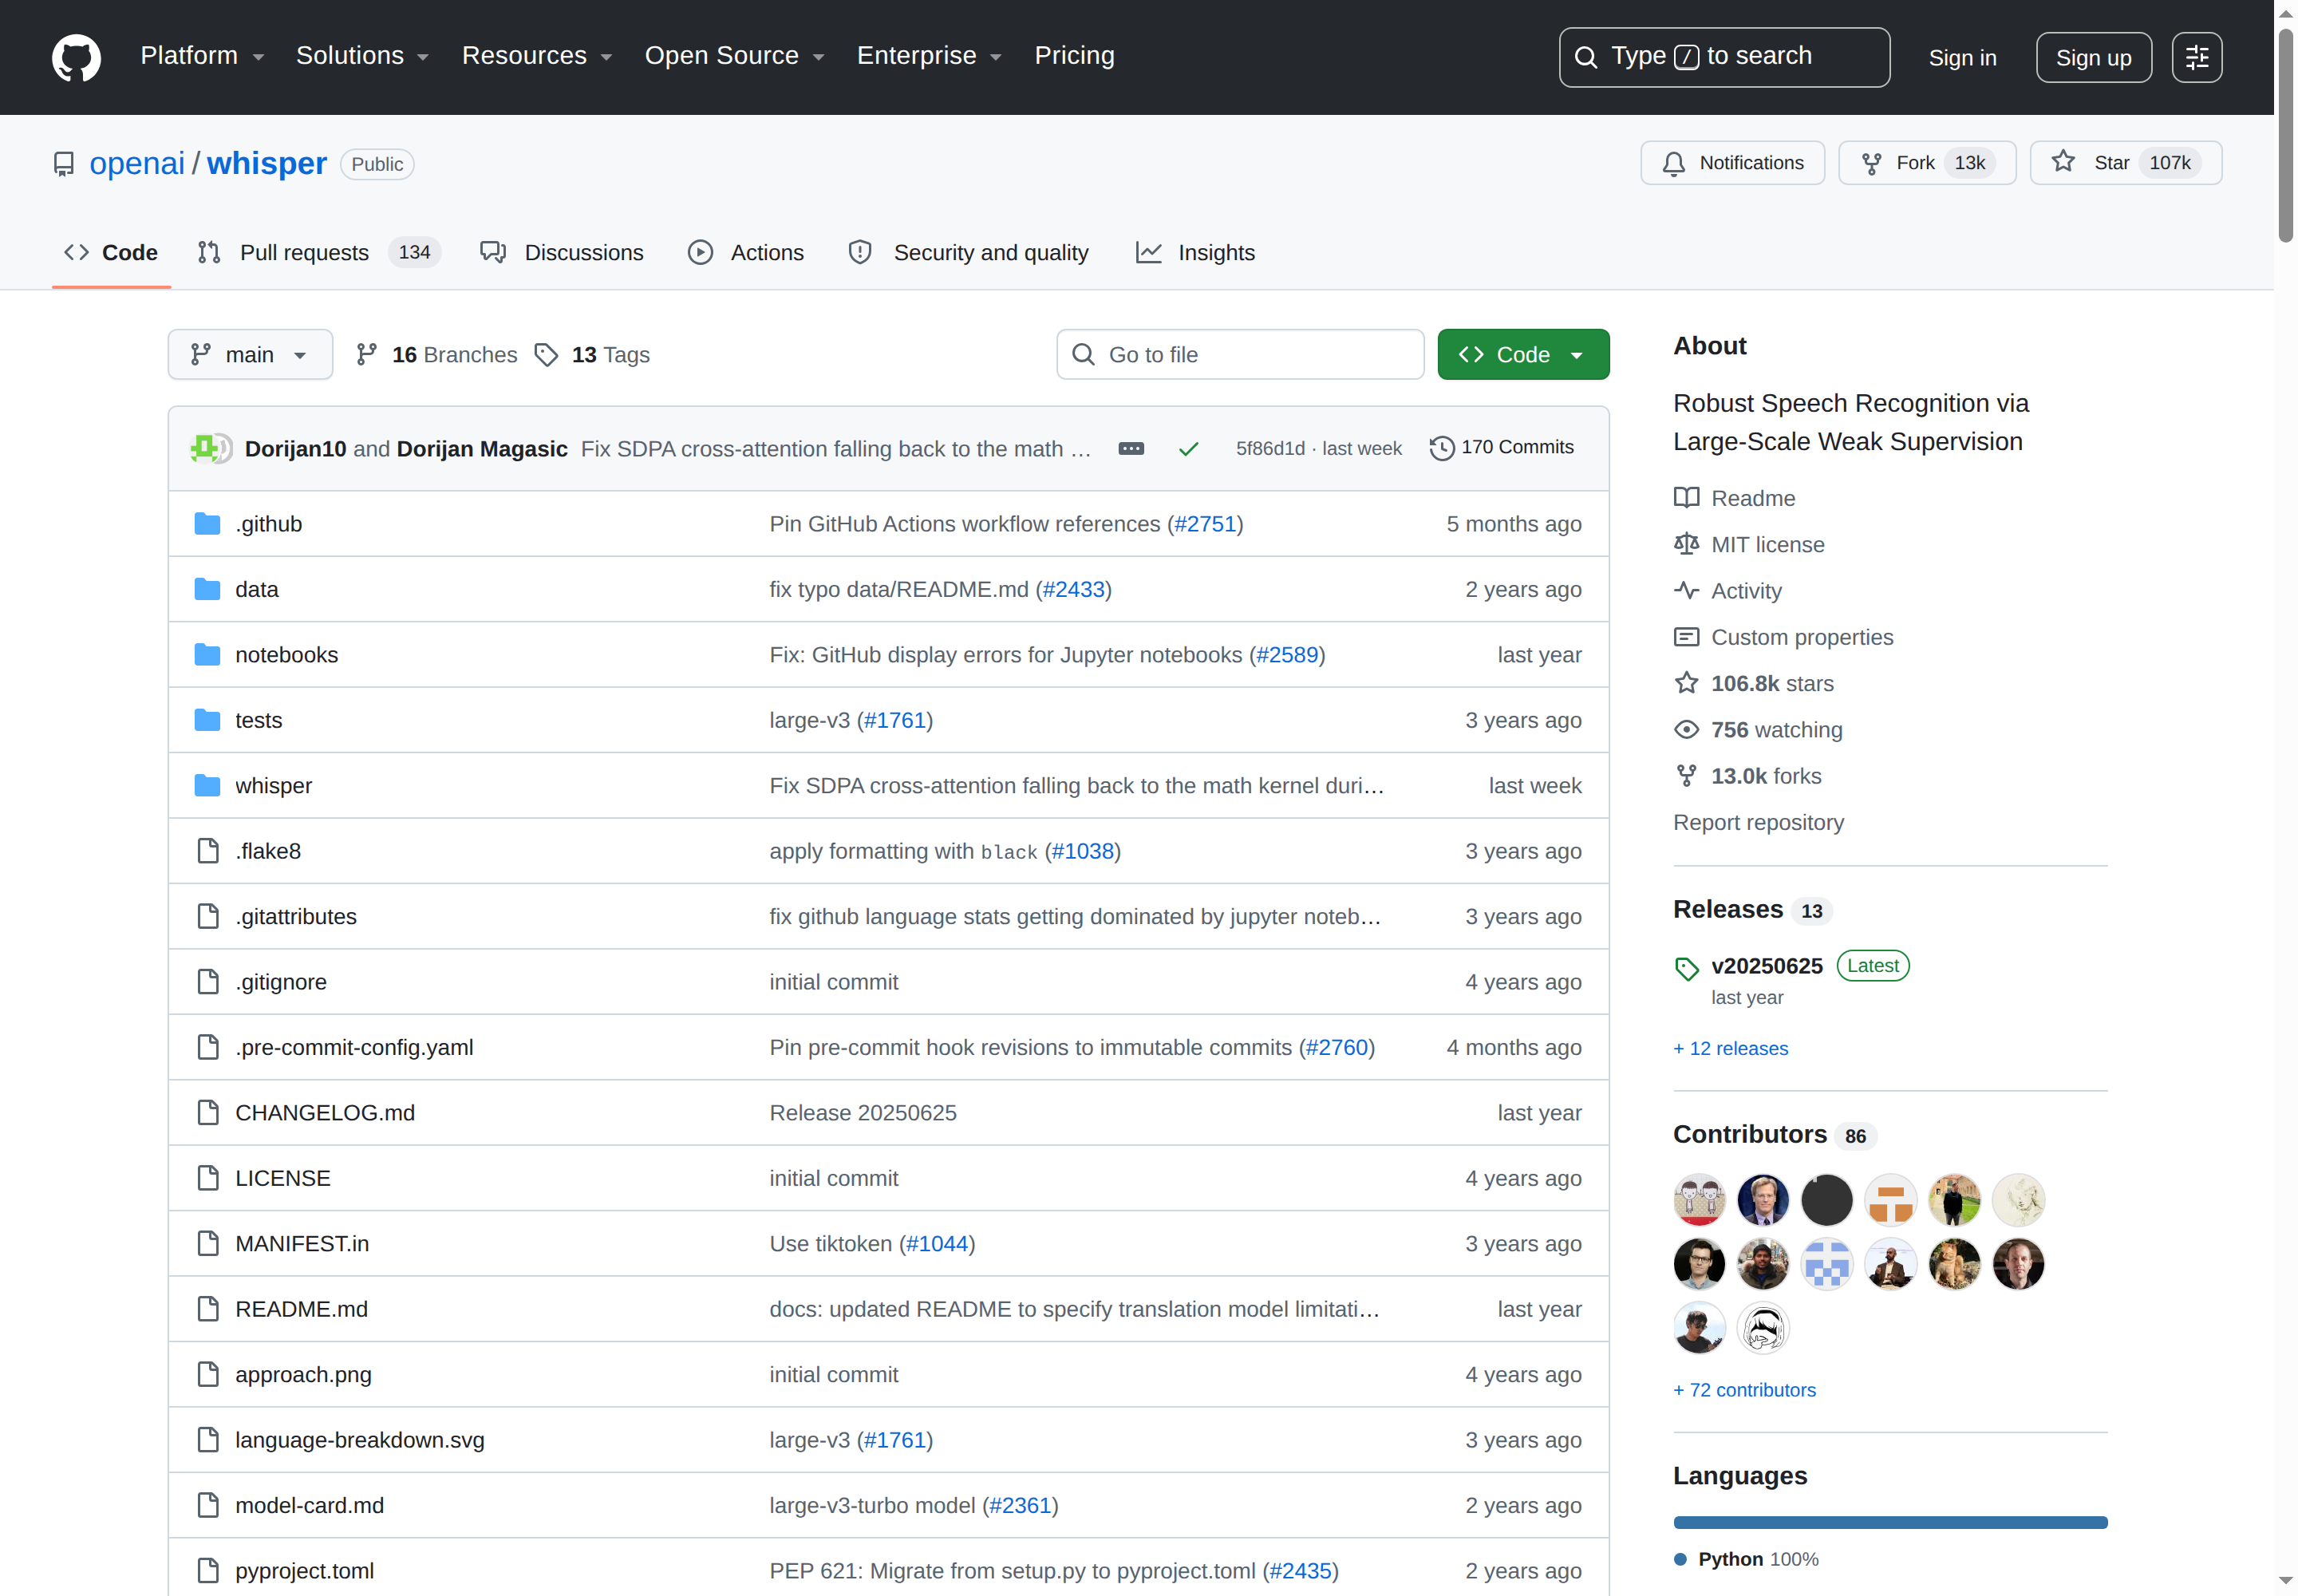
Whisper 累積逾 10.7 萬星標與 13,000 次 fork,創建於 2022 年 9 月,以 Python 撰寫,採用 MIT 授權,最近活躍更新於 2026 年 7 月,官方網站為 openai.com/blog/whisper。
建立日期:2022-09-16|最近 commit:2026-07-28|開發者:OpenAI|官方網站:https://openai.com/blog/whisper|論文:https://arxiv.org/abs/2212.04356
出處
Whisper 值得一試嗎?
值得。對於需要語音轉錄、翻譯或語言識別能力的開發者,Whisper 以 MIT 授權與多尺寸模型提供低成本部署方案,配合成熟衍生生態與持續維護,是現階段最值得採用的開源語音識別模型之一。
「以模型能力、授權開放度與生態成熟度衡量,Whisper 是開源語音 AI 領域最具代表性的項目之一。」