
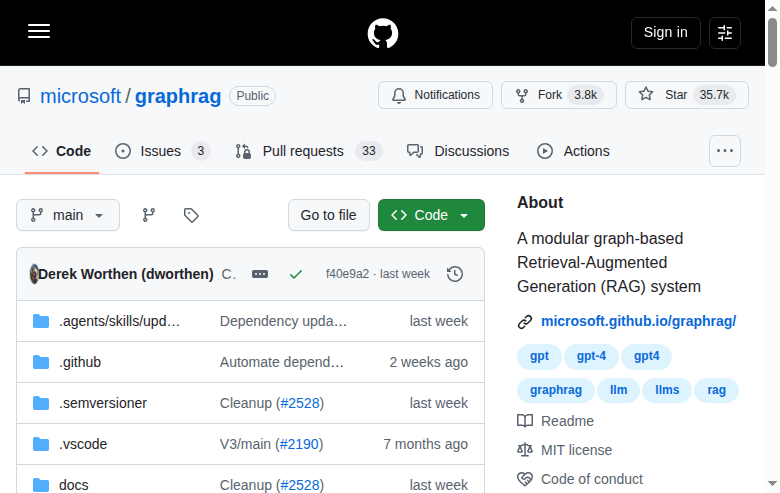
GraphRAG 是微軟研究院於 2024 年 7 月推出的開源知識圖譜檢索增強生成(RAG)框架,在 GitHub 上累積超過 3.57 萬星標與 3,700 分叉,以 MIT 授權釋出。此框架的核心創新在於運用大型語言模型從非結構化文本中抽取出實體與關係,建構成知識圖譜,再配合社群偵測與分層摘要機制,解決傳統向量檢索難以回答「縱觀整個資料集」這類全域性問題的缺陷,是 RAG 技術演化過程中的重要節點。
GraphRAG 是微軟研究院開發的開源知識圖譜 RAG 框架,使用大型語言模型從非結構化文本建構實體關係圖譜,透過社群偵測與分層摘要回答全域性問題。目前擁有超過 3.57 萬星標,採用 MIT 授權,最新版本為 2026 年 8 月發佈的 v3.1.2。
GraphRAG 是什麼?
GraphRAG 由微軟研究院於 2024 年 3 月開始開發,同年 7 月正式開源釋出,定位為「模組化的圖形化檢索增強生成系統」。此項目的設計目標是解決傳統 RAG 架構的根本限制:標準的向量檢索只從文件中抓取與問題最相似的片段,當問題涉及整個資料集的全域脈絡,例如「這個部門過去一年的主要議題是什麼」或「這些文件中反覆出現的主題有哪些」,片段式檢索便會失效。
GraphRAG 的解決方案是將知識圖譜作為記憶結構引入 RAG 管線。系統先以大型語言模型將原始文本轉化為實體、關係與主張(claim)的圖形表示,再透過社群偵測演算法將圖譜劃分為不同層級的社群,並為每個社群產生摘要。查詢時,系統同時運用圖譜結構與分層摘要進行「全域搜尋」與「局部搜尋」,讓模型能基於整個資料集的結構化理解回答問題,而非僅依賴單一片段。
GraphRAG 是一個開源的知識圖譜檢索增強生成框架,以大型語言模型從文本建構實體關係圖譜,結合社群偵測與分層摘要,讓 AI 能回答傳統 RAG 無法處理的全域性問題。此項目由微軟研究院主導,於 2024 年 7 月開源。
GraphRAG 與傳統 RAG 有什麼不同?
傳統 RAG 以向量相似度作為檢索核心,將文件切割成片段並轉換為向量嵌入,查詢時透過語義相似度尋找相關片段交給模型回答。這種架構對「事實查詢」表現良好,例如「合約中的違約金條款是什麼」,但缺乏對資料集整體結構的理解,面對需要跨文件歸納、比較與推理的全域性問題時,檢索結果往往零散且不完整。
GraphRAG 則以知識圖譜取代純片段檢索。系統建構的圖譜保留了實體之間的關係脈絡,例如「甲公司投資了乙公司」「丙文件提及其供應商」等結構化資訊;分層摘要則提供不同粒度的資料集概覽,讓模型能先掌握整體再深入細節。根據微軟研究院發表的論文《From Local to Global》,GraphRAG 在需要全域理解的問題類別上顯著優於傳統 RAG 方法,這使其特別適合企業級文件分析、研究報告歸納與風險評估等場景。
傳統 RAG 以向量相似度做片段檢索,擅長事實查詢但無法回答跨文件的全域問題;GraphRAG 建構知識圖譜並以分層摘要提供資料集整體理解,在全球性問題類別上表現顯著更佳。兩者差異在於「片段級檢索」與「資料集級結構化理解」的架構分野。
GraphRAG 的核心技術亮點有哪些?
GraphRAG 的技術架構可分為索引與查詢兩大階段。索引階段由大型語言模型驅動,執行實體抽取、關係抽取、主張抽取與社群偵測四個步驟,將非結構化文本轉化為可查詢的圖形資料結構;查詢階段則提供全域搜尋與局部搜尋兩種模式,全域搜尋基於社群摘要回答宏觀問題,局部搜尋則深入特定實體與其鄰接關係回答細部問題。
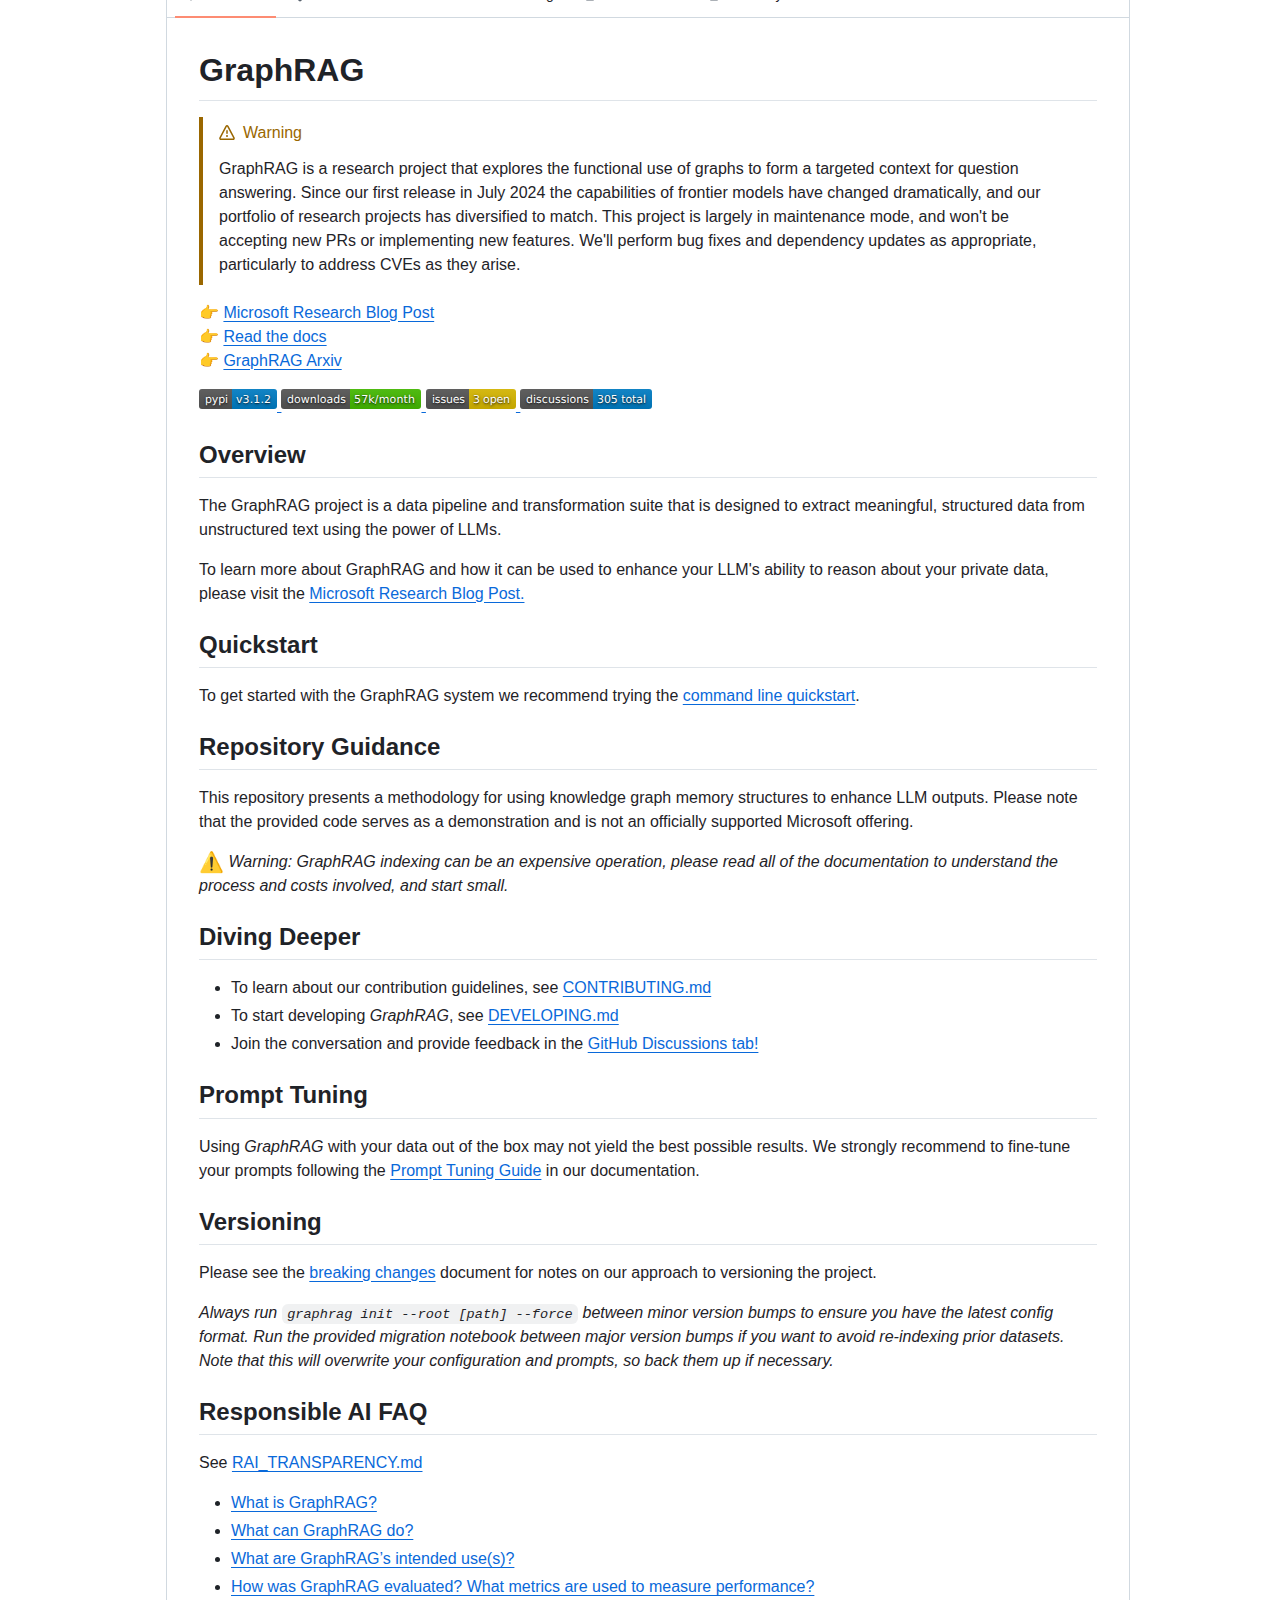
此框架的另一個亮點是 Prompt Tuning 機制。官方文件強烈建議使用者針對自己的資料領域微調提示詞,以達到最佳抽取品質,並提供完整的調校指引。GraphRAG 以 Python 為主要語言,支援命令列介面與 Python API 兩種使用方式,並提供 graphrag init 快速初始化工具,讓開發者能以最少設定開始建立知識圖譜管線。
GraphRAG 的核心亮點包括實體與關係抽取、社群偵測、分層摘要,以及全域搜尋與局部搜尋雙模式查詢。其 Prompt Tuning 機制可針對特定領域優化抽取品質,並提供命令列與 Python API 兩種介面,以 MIT 授權釋出。
如何快速開始使用 GraphRAG?
GraphRAG 的官方快速入門建議從命令列工具開始。開發者先以 pip 安裝 graphrag 套件,接著執行 graphrag init --root [路徑] 初始化專案設定,再透過 graphrag index 對文件目錄建立索引,最後以 graphrag query 進行全域或局部查詢,全程只需要數個命令。官方文件同時提醒,索引過程可能相當昂貴,建議先以小型資料集測試並了解成本結構。
此框架支援多種大型語言模型供應商作為抽取與回答的後端,開發者可依成本與私隱需求選擇雲端模型或本地部署。較新版本之間存在設定格式變更,官方文件明確建議在版本升級時執行 graphrag init --force 以確保組態格式正確,並提供遷移筆記協助使用者避免重新索引既有資料。對於需要深度整合的團隊,Python API 提供更細緻的管線控制能力。
開始使用 GraphRAG 只需四個步驟:安裝 graphrag 套件、執行 graphrag init 初始化、以 graphrag index 建立知識圖譜索引、用 graphrag query 進行查詢。官方建議先以小資料集測試成本,版本升級時需執行 init –force 更新組態格式。
GraphRAG 進入維護模式代表什麼?
GraphRAG 的 README 明確指出,此項目現階段「主要處於維護模式」,不會再接受新的 Pull Request 或實作新功能,微軟僅會進行錯誤修正與依賴更新,特別是針對安全漏洞(CVE)的處理。官方說明提到,自 2024 年 7 月首次釋出以來,前沿模型的能力已發生巨大變化,微軟的研究投資組合亦已分散至其他方向。
此公告對採用者而言具有雙重意義。一方面,維護模式代表專案仍可使用且有基本安全支援,適合已建立索引管線的既有使用者;另一方面,不再實作新功能意味著知識圖譜 RAG 的創新重心已從 GraphRAG 轉移。對新專案而言,開發者應評估其他持續活躍的 RAG 框架,或考慮 GraphRAG 論文提出的方法論是否能由其他工具實作,以確保長期技術路線的延續性。
GraphRAG 目前處於維護模式,不再接受新功能或新 Pull Request,微軟僅進行錯誤修正與安全更新。此狀態代表其方法論已成熟但創新停滯,既有使用者仍可安全使用,新專案則應評估替代方案以確保長期技術延續。
GraphRAG 的市場定位與影響是什麼?
GraphRAG 在開源 RAG 生態中具有獨特地位,它將知識圖譜與檢索增強生成結合,開創了「資料集級理解」的技術路線。此方法論影響了後續多個 RAG 框架的設計方向,包括圖形記憶結構在代理系統中的應用,以及 LightRAG、HippoRAG 等新一代圖形化 RAG 專案的出現,這些專案皆在某種程度上回應或延伸了 GraphRAG 提出的問題意識。
此項目的商業化路徑相對低調,微軟未為 GraphRAG 提供大規模雲端託管服務,而是以開源形式擴散方法論,並將研究能量轉移至其他方向。對企業而言,GraphRAG 的價值在於提供了可自行部署的知識圖譜 RAG 參考實作,特別適合需要深度文件理解、稽核軌跡與可解釋性的場景;對個人開發者而言,雖然索引成本偏高,但從學習知識圖譜 RAG 方法論的角度,此專案仍是目前最完整的開放參考。
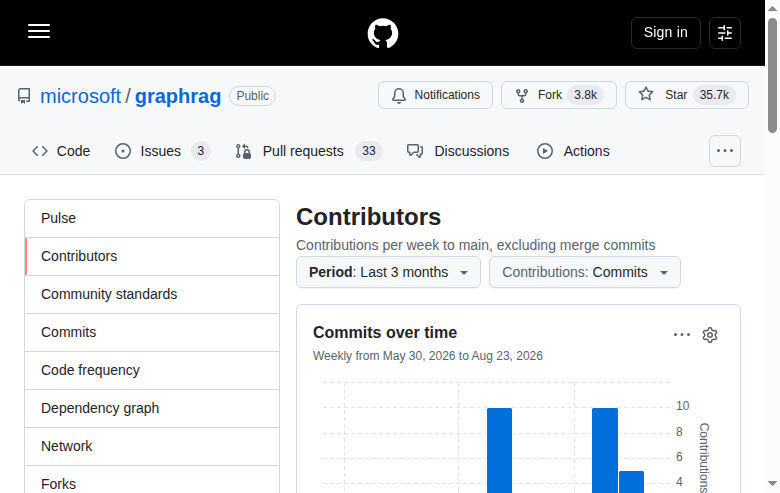
GraphRAG 開創知識圖譜與 RAG 結合的技術路線,影響了 LightRAG、HippoRAG 等後續圖形化 RAG 專案。微軟以開源形式擴散此方法論而未推出雲端服務,使此專案成為學習知識圖譜 RAG 最完整的開放參考實作。
出處連結有哪些?
本文資訊來源為 microsoft/graphrag 的 GitHub 儲存庫,包含完整的 README 文件、快速入門指南、Prompt Tuning 調校指引與版本遷移說明。讀者可前往官方儲存庫查看原始碼、參與社群討論,並透過官方文件網站取得詳細的技術文件與架構說明,相關方法論細節亦記載於微軟研究院發表的 GraphRAG 論文。
本文資訊來源為 microsoft/graphrag 的 GitHub 儲存庫及官方文件網站,包含 README、快速入門、Prompt Tuning 指南與版本遷移說明。方法論細節可參考微軟研究院發表的論文《From Local to Global》。
- GitHub 儲存庫:microsoft/graphrag
- 官方文件:GraphRAG Documentation
- 研究論文:From Local to Global (arXiv)
總結:GraphRAG 適合什麼團隊?
GraphRAG 適合需要知識圖譜級文件理解的團隊,包括企業文件分析、研究報告歸納與風險評估場景,以及想學習知識圖譜 RAG 方法論的開發者。已建立索引管線的既有使用者可繼續安全使用,新專案則應評估持續活躍的替代框架。
GraphRAG 以知識圖譜作為 RAG 記憶結構的設計,在開源社群中建立了獨特的技術定位,其超過 3.57 萬星標反映學術界與業界對「資料集級理解」路線的高度興趣。雖然微軟已宣布項目進入維護模式,但此框架所提出的社群偵測與分層摘要方法論,仍持續影響新一代圖形化 RAG 專案,並為需要深度文件理解的團隊提供完整的開放參考實作。對開發者而言,理解 GraphRAG 的架構原理,等同掌握知識圖譜 RAG 這條技術路線的核心概念,其價值不會因維護模式而消退。