
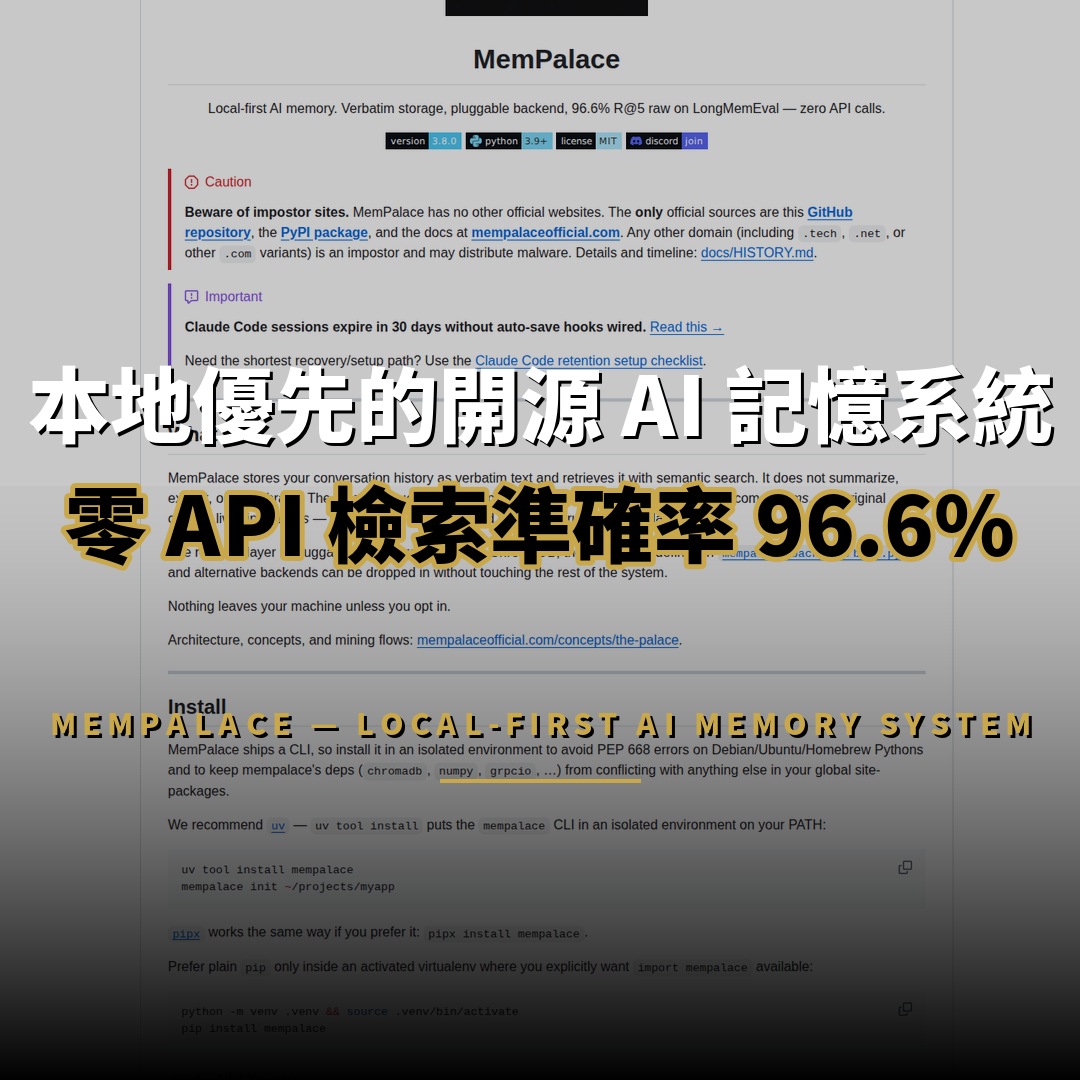
MemPalace 是一套本地優先的開源 AI 記憶系統,GitHub 星標數達 58,549 顆,由 MemPalace 團隊維護,以 Python 撰寫並採用 MIT 授權,2026 年 4 月創立。它的核心承諾是將 AI 對話記憶完整保留在使用者自己的機器上,以逐字原文儲存、語意檢索取回,全程不需要任何 API 金鑰或雲端服務,並在 LongMemEval 基準測試中以純檢索模式取得 96.6% 的 R@5 準確率,成為目前公開基準成績最佳的開源記憶系統之一。
MemPalace 是一套本地優先的開源 AI 記憶系統,GitHub 獲 58,549 顆星標,採用逐字儲存與語意檢索,不呼叫任何 API 即可在 LongMemEval 基準測試取得 96.6% 的 R@5 檢索準確率,提供 44 個 MCP 工具,MIT 授權可自由商用。
MemPalace 是什麼?為何定位為「本地優先」的 AI 記憶系統?
MemPalace 是一套將 AI 對話記憶以逐字原文儲存在本機的開源系統,透過 wings、rooms、drawers 三層結構組織記憶,預設所有運算都在本地完成,除非使用者主動開啟,否則沒有任何內容會離開機器,適合處理敏感資料。
MemPalace 的設計起點是解決 AI 對話記憶的兩大痛點:記憶被摘要壓縮而失真,以及對話內容被送往雲端而失控。多數記憶系統會將對話歷史摘要、抽取或改寫後儲存,MemPalace 則反其道而行,將原始對話以逐字(verbatim)形式完整保存,再以語意檢索取回,確保記憶內容不因摘要過程而丟失細節。
「本地優先」的含義在於資料主權。系統所有運算,包括語意檢索與嵌入計算,預設都在本機完成,除非使用者主動開啟伺服器端嵌入或雲端檢索功能,否則沒有任何內容會離開使用者的機器。這項特性使其特別適合處理敏感商業對話、法律文件或個人隱私資料的使用場景。
在資料組織上,MemPalace 引入宮殿隱喻的三層結構:人物與專案成為「wings」(翼),主題成為「rooms」(房間),原始內容則存放於「drawers」(抽屜)。這套結構讓檢索可以限定範圍進行,而非在扁平化的語料庫中盲目搜尋,例如搜尋特定專案的決策紀錄時,系統會優先掃描該專案對應的 wing,提升精準度與速度。

MemPalace 的核心技術亮點有哪些?
MemPalace 的核心亮點包括逐字儲存不失真的記憶機制、五種可插拔儲存後端、具時間效期的知識圖譜,以及 44 個 MCP 工具。預設以 ChromaDB 儲存,支援 SQLite、Milvus、Qdrant 與 pgvector,可整合 Claude Code、Codex 等開發工具。
MemPalace 的技術架構圍繞四個支柱設計:逐字儲存、可插拔檢索後端、時間感知知識圖譜,以及完整的 MCP 整合。逐字儲存保證記憶不失真,可插拔後端則避免系統被單一向量資料庫綁架。
儲存後端採用合約化設計,預設使用 ChromaDB,同時支援 SQLite 精確檢索、Milvus、Qdrant 與 pgvector 等五種後端,每一種都透過統一的 base.py 介面接入,開發者不需修改其他程式碼即可替換。非預設後端全部採選用制,避免不必要的相依套件占用資源。
知識圖譜是另一項特色功能,它是一套具備時間效期(validity windows)的實體關係圖,支援新增、查詢、失效與時間軸追溯,資料儲存在本地 SQLite。這讓系統不只記得「說了什麼」,還能理解「什麼時候說的」,例如一份合約條款在特定日期後失效,圖譜會記錄這項時間約束,避免檢索時引用過期資訊。
MCP(Model Context Protocol)伺服器則提供 44 個工具,涵蓋宮殿讀寫、知識圖譜操作、跨 wing 導覽、drawer 管理、代理日記與代理協調等功能。任何支援 MCP 的 AI 用戶端都可以直接掛載 MemPalace,取得完整的記憶讀寫能力。
MemPalace 在檢索準確率基準測試中的表現如何?
MemPalace 在 LongMemEval 基準測試以純語意檢索取得 96.6% 的 R@5 準確率,全程零 API 呼叫;混合檢索模式在保留測試集達 98.4%,疊加 LLM 重新排序後可達 99% 以上,LoCoMo 混合模式 R@10 為 88.9%。
MemPalace 公開了可完全重現的基準測試數據,所有結果都能從儲存庫內的指令重跑。在 LongMemEval 的 500 題檢索測試中,純語意檢索模式(不加入任何啟發式規則或 LLM)達到 96.6% 的 R@5 準確率,全程不需要 API 金鑰、雲端或任何模型。
加入混合檢索管線後,系統透過關鍵字加權、時間鄰近性加權與偏好模式抽取,在保留的 450 題測試集上取得 98.4% 的 R@5 準確率,這組數據刻意使用未參與調校的題目,被團隊視為更具一般化意義的誠實數字。若再疊加 LLM 重新排序(rerank),以任何具備合理能力的模型從前 20 名候選中挑選最佳結果,準確率可達 99% 以上,且與模型廠牌無關。
在其他基準測試中,MemPalace 於 LoCoMo 混合檢索模式取得 88.9% 的 R@10,於 ConvoMem 全類別平均召回率達 92.9%,於 ACL 2025 的 MemBench 基準取得 80.3% 的 R@5。團隊特別強調,最後 0.6% 的差距是透過檢視特定錯誤答案修正而來,因此不宣稱 100% 的成績,避免數據造假疑慮。
| 基準測試 | 指標 | 分數 | 備註 |
|---|---|---|---|
| LongMemEval(純檢索) | R@5 | 96.6% | 500 題,零 API |
| LongMemEval(混合 v4) | R@5 | 98.4% | 保留 450 題 |
| LongMemEval(混合 + LLM 重排序) | R@5 | ≥99% | 任意模型 |
| LoCoMo(混合 v5) | R@10 | 88.9% | 1,986 題 |
| ConvoMem(全類別) | 平均召回 | 92.9% | 250 項 |
| MemBench(ACL 2025) | R@5 | 80.3% | 8,500 項 |
MemPalace 如何與 Claude Code 等 AI 開發工具整合?
MemPalace 以 MCP 伺服器形式整合 Claude Code、Gemini CLI、Codex 等工具,提供 44 個記憶讀寫工具。自動儲存鉤子支援 Claude Code、Codex 與 Cursor IDE,會在上下文壓縮前保存快照,並可批次匯入既有對話紀錄。
MemPalace 的整合方式以 MCP 為核心,開發者可將它作為標準 I/O 的 MCP 伺服器掛載至 Claude Code、Gemini CLI、Codex 等工具,掛載後 AI 助理即可在對話中直接查詢與寫入記憶。Docker 映像同時支援 amd64 與 arm64 架構,可在 Apple Silicon 上原生執行。
針對會定期壓縮上下文的開發工具,MemPalace 提供自動儲存鉤子(auto-save hooks),支援 Claude Code、Codex CLI 與 Cursor IDE。這些鉤子會在上下文壓縮前自動保存對話快照,Cursor 版本更額外加入會話開始時的記憶回顧功能,確保壓縮過程中不遺失關鍵決策紀錄。
對於既有的大量歷史資料,使用者可透過 mempalace mine 指令批次匯入,例如掃描 ~/.claude/projects/ 目錄下的舊對話 JSONL 檔案,並以 mempalace sweep 定期增量補全逐字訊息紀錄。官方文件強調,Claude Code 的對話紀錄若未接上自動儲存鉤子,會在 30 天後過期,因此建議新使用者優先完成鉤子設定與歷史資料回填。
MemPalace 的儲存後端架構有何特別之處?
MemPalace 提供五種可插拔儲存後端,預設 ChromaDB 嵌入式資料庫免設定即可使用,另支援 SQLite 精確檢索、Milvus、Qdrant 與 pgvector 伺服器型後端,具備命名空間隔離與 Lexical 檢索能力,嵌入計算可卸載至任何 OpenAI 相容端點。
MemPalace 的後端合約刻意在多種性質差異極大的儲存基座上驗證,避免介面被單一廠商綁架。預設的 ChromaDB 為嵌入式本地資料庫,不需額外設定即可使用;SQLite 精確模式則提供完全無外部相依的檢索選項,適合極簡部署。
伺服器型後端則滿足多使用者與團隊場景。Milvus Lite 可作為本地嵌入服務,Qdrant 以 REST 介面提供命名空間隔離,pgvector 則讓既有 PostgreSQL 基礎設施直接複用。命名空間(namespaces)支援在共享資料庫中隔離不同專案或使用者的記憶,Lexical 檢索能力則補足純向量檢索對精確字詞匹配的不足。
嵌入計算同樣具備彈性。預設使用本地嵌入模型,約需 300 MB 磁碟空間,其中 embeddinggemma-300m 支援超過 100 種語言,適合繁體中文等多語場景;all-MiniLM-L6-v2 則僅 30 MB,適合純英文環境。需要更強嵌入能力時,可將計算卸載至任何 OpenAI 相容的 /v1/embeddings 端點,包括 LM Studio、llama.cpp、vLLM 或 Ollama 的自架服務,當端點位於本機或區域網路時,內容依然不會離開使用者的網路。
MemPalace 與 Mem0 等其他記憶專案相比如何?
MemPalace 定位本地優先與資料主權,以逐字儲存與可插拔後端為核心,Mem0 則主打通用記憶層的 API 服務,兩者在架構哲學上互補。MemPalace 公開完整基準測試程式碼供任何人重跑驗證,強調數據嚴謹性。
MemPalace 團隊刻意避免與 Mem0、Mastra、Hindsight、Supermemory 或 Zep 進行直接比較,理由是各專案在基準測試中使用不同的資料集切割與指標定義,將檢索召回率與端到端問答準確率並列並非誠實的比較方式。這項立場反映其對數據嚴謹性的重視。
從定位差異觀察,Mem0 主打「通用記憶層」,以 API 服務形式為 AI 代理提供跨應用記憶,強調與各類框架的整合便利性;MemPalace 則強調本地優先與資料主權,以逐字儲存與可插拔後端為核心,適合對資料隱私有嚴格要求的開發者。兩者在架構哲學上形成互補,而非直接競爭。
對於重視開源透明度的團隊,MemPalace 的完整基準測試程式碼與逐題結果檔案均隨儲存庫公開,任何使用者都可以自行重跑驗證,這在 AI 記憶領域較為少見,也成為其社群信任的重要基礎。
MemPalace 的安裝與快速開始步驟是什麼?
安裝 MemPalace 可用 uv tool install mempalace 或 pipx 安裝 CLI,或使用 Docker 映像;初始化後以 mempalace mine 匯入檔案與對話紀錄,mempalace search 進行語意檢索,mempalace wake-up 為新對話載入上下文,約需 300 MB 空間存放嵌入模型。
MemPalace 提供 CLI 與 Docker 兩種主要安裝途徑。CLI 安裝建議使用 uv tool install mempalace 或 pipx install mempalace,將指令安裝在隔離環境,避免與系統 Python 套件衝突;偏好傳統方式的使用者則可在虛擬環境內以 pip 安裝。Docker 使用者可透過 docker pull ghcr.io/mempalace/mempalace:latest 取得多架構映像。
初始化與使用只需三個核心指令。首先以 mempalace init 建立宮殿,接著用 mempalace mine 將專案檔案或對話紀錄匯入記憶,最後以 mempalace search 進行語意檢索,或使用 mempalace wake-up 為新對話載入相關上下文。


MemPalace 的專案數據概覽為何?
MemPalace 目前 GitHub 獲 58,549 顆星標、7,508 次復刻,以 Python 為主要語言,採用 MIT 授權,2026 年 4 月創立,最近更新時間為 2026 年 8 月 22 日,主要貢獻者包括 igorls、mvalentsev 與 bensig。
MemPalace 的核心數據如下:58,549 顆星標、7,508 次復刻、MIT 授權、Python 為主要語言,2026 年 4 月 5 日建立,最近一次更新為 2026 年 8 月 22 日。儲存庫主題涵蓋 ai、llm、memory、mcp、chromadb 與 python,顯示其定位橫跨 AI 記憶、模型上下文協定與向量資料庫三大領域。主要貢獻者 igorls 累積 930 次提交,其次為 mvalentsev 的 137 次與 bensig 的 115 次,專案仍維持活躍開發節奏。
MemPalace 常見問題有哪些?
MemPalace 核心檢索不需要 API 金鑰,支援超過 100 種語言(含繁體中文),可在 Apple Silicon 原生執行。團隊認為各記憶專案基準數據不宜直接比較,因此公開完整可重現的測試程式碼供使用者自行驗證。
MemPalace 需要 API 金鑰嗎?
核心檢索路徑完全不需要 API 金鑰。純語意檢索模式在 LongMemEval 取得 96.6% 的 R@5 準確率,全程零雲端呼叫;只有當使用者主動設定 OpenAI 相容嵌入端點或 LLM 重排序時才需要對應的金鑰。
MemPalace 支援繁體中文嗎?
支援。預設的 embeddinggemma-300m 嵌入模型支援超過 100 種語言,涵蓋繁體中文;若需更強的語意理解,可將嵌入計算卸載至自架的 OpenAI 相容端點,內容仍不會離開使用者的網路。
MemPalace 可以在 Apple Silicon 上執行嗎?
可以。官方 Docker 映像支援 amd64 與 arm64 雙架構,可在 Apple Silicon 原生執行;GPU 映像則僅提供 x86_64 版本,因為 onnxruntime-gpu 沒有 aarch64 Linux 套件。
MemPalace 與其他記憶系統的基準數據可以比較嗎?
團隊認為不宜直接比較,因為各專案使用不同的資料集切割與指標定義。MemPalace 選擇公開完整可重現的基準測試程式碼與逐題結果,讓使用者自行驗證與判斷。
出處連結有哪些?
本文資訊來源為 MemPalace 的 GitHub 儲存庫(MemPalace/mempalace),包括 README、基準測試文件與官方文件網站 mempalaceofficial.com,數據擷取時間為 2026 年 8 月 23 日。
本文內容參考自 MemPalace GitHub 儲存庫(https://github.com/MemPalace/mempalace),以及官方文件網站 mempalaceofficial.com 的架構、基準測試與安裝指南。所有數據以儲存庫內公開資訊為準。
總結:MemPalace 適合什麼團隊?
MemPalace 適合重視資料隱私與主權的開發者與團隊,尤其是需要長期保存敏感對話紀錄、追求記憶不失真、且希望完全掌控基礎設施的使用者;對已採用 Claude Code、Codex 等 MCP 相容工具的開發流程,整合成本極低。
綜合而言,MemPalace 以逐字儲存、可插拔後端與時間感知知識圖譜三項設計,回應了 AI 記憶系統常見的失真與隱私兩大疑慮。它的基準測試成績公開可重現,MIT 授權降低採用門檻,本地優先的架構則讓資料主權回到使用者手中。對於已經建置 MCP 工具鏈的團隊,MemPalace 提供了一條低摩擦的記憶整合路徑;對於仍將記憶委託雲端的團隊,它則展示了另一種以隱私為核心的技術選擇。