
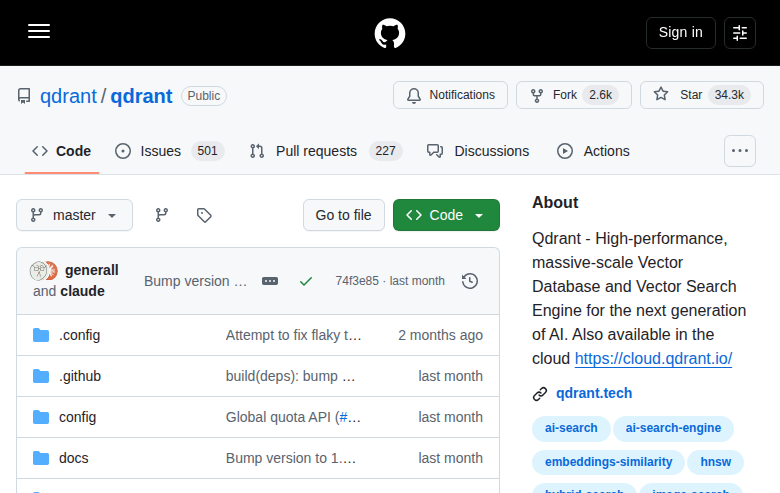
Qdrant 是一款以 Rust 撰寫的開源向量資料庫,目前於 GitHub 上累積超過 34,000 顆星標,定位為「下一代 AI 應用的向量搜尋引擎」。它提供生產就緒的服務與 API,讓開發者將神經網路產生的向量嵌入轉換為搜尋、推薦與語意比對應用,是當前 AI 基礎設施領域最具代表性的事業級開源專案之一。
向量資料庫是大型語言模型應用的關鍵底層組件。當企業需要對大量文件、圖片或商品進行語意搜尋時,傳統關鍵字檢索無法理解內容含義,而向量資料庫則透過數學上的相似度計算,直接找出「意思相近」的資料。Qdrant 的出現,正是為了以高吞吐、低延遲的方式承載這類工作負載。
Qdrant 是什麼?
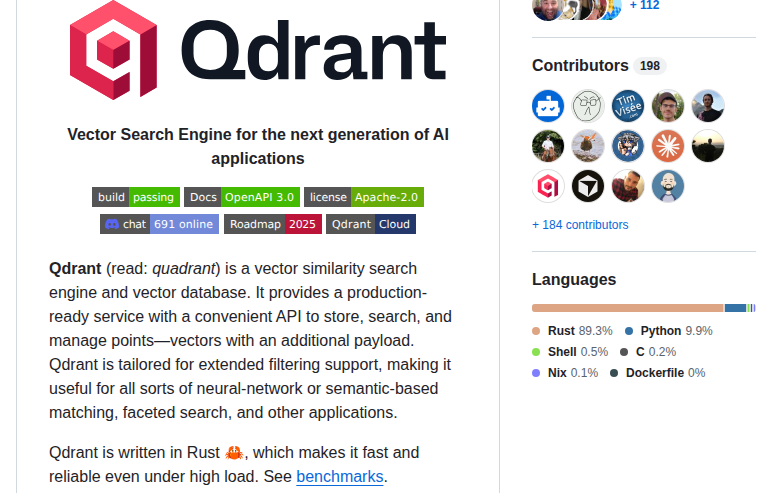
Qdrant 是一個用 Rust 撰寫的開源向量相似度搜尋引擎與向量資料庫,提供 REST 與 gRPC 介面儲存、搜尋和管理帶有 payload 的向量資料。它以高效能、可水平擴展與豐富的過濾條件著稱,並提供雲端託管版本,目前星標數超過 34,000。
Qdrant 的核心設計圍繞「向量 + 附加資料」的雙層結構。每一筆資料被稱為 point,由向量座標與 JSON payload 組成;向量負責語意相似度的計算,payload 則承載可供過濾的中繼資料。這種設計讓開發者可以在進行向量搜尋的同時,以關鍵字、數值範圍、地理位置等條件進行精確篩選,滿足電商分類、內容推薦等真實業務需求。
專案由 Qdrant 公司主導開發,以 Apache 2.0 授權釋出,並同時提供完全託管的 Qdrant Cloud 服務,內含免費額度。其企業版與開源版共享同一核心架構,意味著開發者可以從本機容器開始,無痛遷移至雲端規模化部署。
Qdrant 的核心技術亮點有哪些?
Qdrant 的核心亮點包括稠密、稀疏與多向量搜尋三種模式,混合搜尋搭配融合策略,以及內建的向量量化與磁碟儲存,可將 RAM 使用量降低最多 97%。它同時支援分片與複寫的水平擴展,並具備 GPU 加速索引與 SIMD 硬體加速。
首先,Qdrant 原生支援三種向量模式。稠密向量適用於語意相似度搜尋,稀疏向量可用於全文檢索,多向量則支援 ColBERT 這類晚期交互模型。三種模式可以在同一集合中並存,讓單一資料庫同時滿足語意理解與關鍵字精確匹配的需求。
其次,混合搜尋(Hybrid Search)是 Qdrant 的差異化功能。系統可以將多個向量的檢索結果,透過 Reciprocal Rank Fusion(RRF)或 Distribution-Based Score Fusion(DBSF)等策略合併,兼顧召回率與精確度。這對於 RAG 應用尤其重要,因為語意檢索與字面檢索互補,能顯著降低答案遺漏的風險。
最後,效能優化是 Qdrant 的招牌。內建的向量量化技術可將 RAM 需求降低最多 97%,開發者可以按需調整速度與精確度的取捨;on-disk 儲存模式則讓資料集可以超出記憶體容量。底層採用寫入前日誌(WAL)確保斷電時資料不遺失,並利用 io_uring 異步 I/O 最大化磁碟吞吐,甚至支援 NVIDIA 與 AMD GPU 加速索引建置。
Qdrant 與其他向量資料庫有何不同?
Qdrant 以 Rust 撰寫,強調單一伺服器的極致效能與豐富的 payload 過濾能力,相較 Milvus 的分散式架構更易於部署。它的混合搜尋與量化技術成熟,且提供雲端託管選項,適合追求低延遲與快速落地的事業級應用。
向量資料庫市場中,主要競爭者包括 Milvus、Weaviate 與 Chroma 等專案。Milvus 定位於大型分散式部署,架構較為複雜;Weaviate 強調模組化與圖形介面;Chroma 則主打輕量與開發者體驗。Qdrant 的切入點,是以 Rust 帶來的單節點效能優勢與部署簡潔性。
在過濾能力方面,Qdrant 的 payload 索引與查詢規劃器是顯著優勢。系統會利用已儲存的 payload 資訊最佳化查詢執行策略,並支援分面統計(faceting)、推薦搜尋與 discovery 等進階操作。對於需要「先篩選、再比對」的業務場景,例如地理位置附近的商店推薦,Qdrant 的表現明顯優於單純的向量引擎。
此外,Qdrant 提供 Web UI 與完整的 OpenAPI 3.0 規格,客戶端涵蓋 Python、JavaScript、Go、Rust、Java 與 .NET 等主流語言。無程式碼與低程式碼平台也支援整合,讓資料管線團隊可以快速串接現有 AI 堆疊。
如何快速開始使用 Qdrant?
使用 Qdrant 最快的方式是執行官方容器指令,啟動後以 Python 客戶端連接本機 6333 連接埠即可儲存與查詢向量。官方提供 Quick Start 指南、Essentials 課程與語意搜尋教學,協助開發者在數分鐘內建立第一個搜尋應用。
開發者只需要一條容器指令即可在本機啟動 Qdrant:docker run -p 6333:6333 qdrant/qdrant。啟動後,透過官方 Python 客戶端 qdrant_client 建立連線,便能開始建立集合、上傳向量並執行搜尋查詢。官方文件同時強調,正式部署前應閱讀安裝與安全指南,避免以未驗證的配置暴露於網路。
對於資源受限的邊緣裝置,Qdrant Edge 提供了程序內執行的輕量版本。它將資料儲存與查詢直接嵌入應用程式,支援離線運作,並可與 Qdrant Server 同步;開發者只需初始化 EdgeShard 實例即可操作。這項設計讓向量搜尋可以進入物聯網與行動裝置場景。
此外,Qdrant 官方提供 Agent Skills 集合,可將向量搜尋能力直接帶入 AI 編程助手,協助開發者在量化、分片、多租戶隔離與模型遷移等工程決策上取得建議。這對於正在建置 RAG 管線的團隊而言,是降低試錯成本的實用資源。
Qdrant 有哪些實際應用場景?
Qdrant 適用於語意搜尋、以圖搜圖、電商極端分類、推薦系統與 RAG 知識庫檢索等場景。官方示範專案涵蓋文字語意搜尋、美食圖片視覺搜尋與百萬級標籤的產品分類,均可在線上直接體驗。
在實際應用中,Qdrant 最常見的場景是企業知識庫的 RAG 檢索層。文件經嵌入模型轉為向量後存入 Qdrant,查詢時以混合搜尋同時比對語意與關鍵字,大幅提升檢索品質。結合 payload 過濾,還可以實現「只搜尋特定部門文件」或「只搜尋近期資料」的精確控制。
視覺搜尋是另一條成熟應用路徑。官方提供的食物發現示範專案,展示了以圖片查詢相似料理的完整流程;電商平台的極端分類示範則處理百萬級標籤的多標籤分類問題。這些案例說明 Qdrant 有能力承接影像嵌入模型的輸出,實現「不知道名稱也能找到商品」的搜尋體驗。
推薦系統同樣受益於 Qdrant 的向量比對能力。透過正例與反例的組合查詢,系統可以找出與使用者偏好最相似的內容;多租戶分割功能則讓 SaaS 業者以單一叢集服務大量客戶,同時確保資料隔離與查詢隔離,降低營運成本。
出處連結有哪些?
本文資訊來源為 Qdrant 的官方 GitHub 儲存庫,包含原始碼、文件與授權資訊。讀者可前往 github.com/qdrant/qdrant 查看專案最新動態、提交紀錄與討論內容。
- GitHub 儲存庫:https://github.com/qdrant/qdrant
- 官方文件:https://qdrant.tech/documentation/
- 雲端服務:https://cloud.qdrant.io/
總結:Qdrant 適合什麼團隊?
Qdrant 適合需要高效能向量搜尋且重視部署簡潔性的團隊,尤其是正在建置 RAG 知識庫、推薦系統或視覺搜尋的開發者。它提供免費開源版本與雲端託管選項,從原型驗證到規模化生產皆可行,是向量資料庫領域值得評估的成熟方案。
綜合而言,Qdrant 以 Rust 的高效能基底、完整的混合搜尋能力與成熟的量化壓縮技術,在向量資料庫市場中建立了明確的定位。對於希望快速落地 AI 搜尋功能、又不想承擔分散式系統維運複雜度的團隊,Qdrant 提供了一個兼顧效能與易用性的選擇。
隨著 RAG 與代理式 AI 應用的普及,向量資料庫已成為 AI 基礎設施的標準配備。Qdrant 持續以 2 小時內的高頻率提交節奏開發,並由公司團隊與社群共同維護,其長期發展路線與生態系統的完善程度,值得技術決策者納入評估清單。