
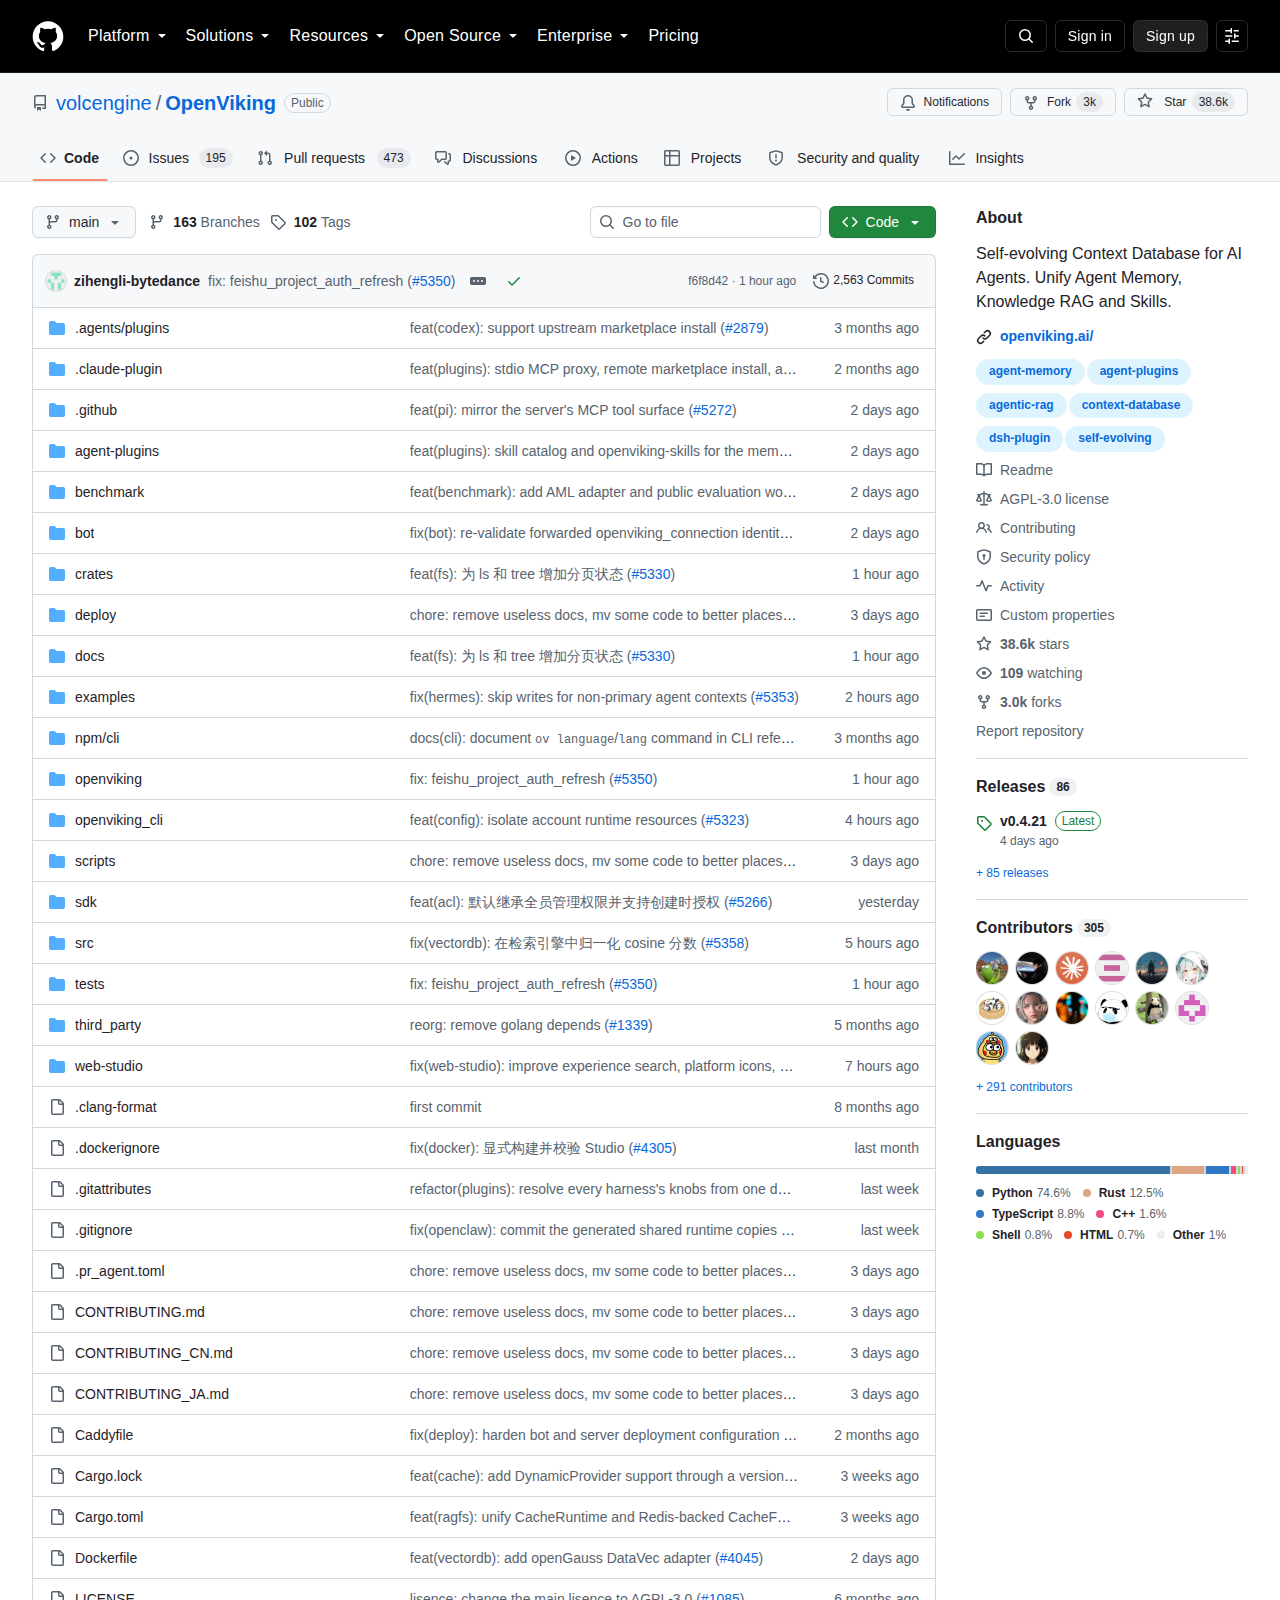
火山引擎(Volcengine)開源的 OpenViking 是一個面向 AI 代理的上下文資料庫,目標是把代理所知的知識、記憶與技能收進同一個虛擬檔案系統。該專案於 2026 年 1 月建立,至今累積 38,601 顆星標、3,010 個分支與 281 位貢獻者,並已發布至 v0.4.21。其核心主張相當明確:代理的上下文不應該是無法檢視的黑箱,而應該是可瀏覽、可編輯、可檢索的目錄結構。
OpenViking 是火山引擎開源的上下文資料庫,把代理的知識、記憶與技能存入虛擬檔案系統,以 viking:// 檢索,累積 38,601 星標。
OpenViking 是什麼?
它將代理所需的資源、記憶與技能組織成 viking:// 下的目錄樹。資源存放文件與程式碼,記憶保存使用者偏好與經驗,技能定義任務執行方式,三者皆可瀏覽與編輯。
多數代理記憶系統的運作方式是把文字轉為嵌入向量,再從向量池中取回相近片段。這種做法雖然有效,卻難以回答一個基本問題:代理到底記住了什麼。開發者無法打開某個索引目錄,逐項檢視或修正其中的內容。
OpenViking 的設計選擇了另一條路徑。它把上下文視為檔案系統,代理以 ls、tree、read、write、grep 等操作在 viking:// 之下移動。資源(resources)保存專案文件、程式碼與網頁;記憶(memories)保留使用者偏好與過往經驗;技能(skills)則定義任務的執行方式。三者各自帶有 URI,可被瀏覽、檢索與版本化。
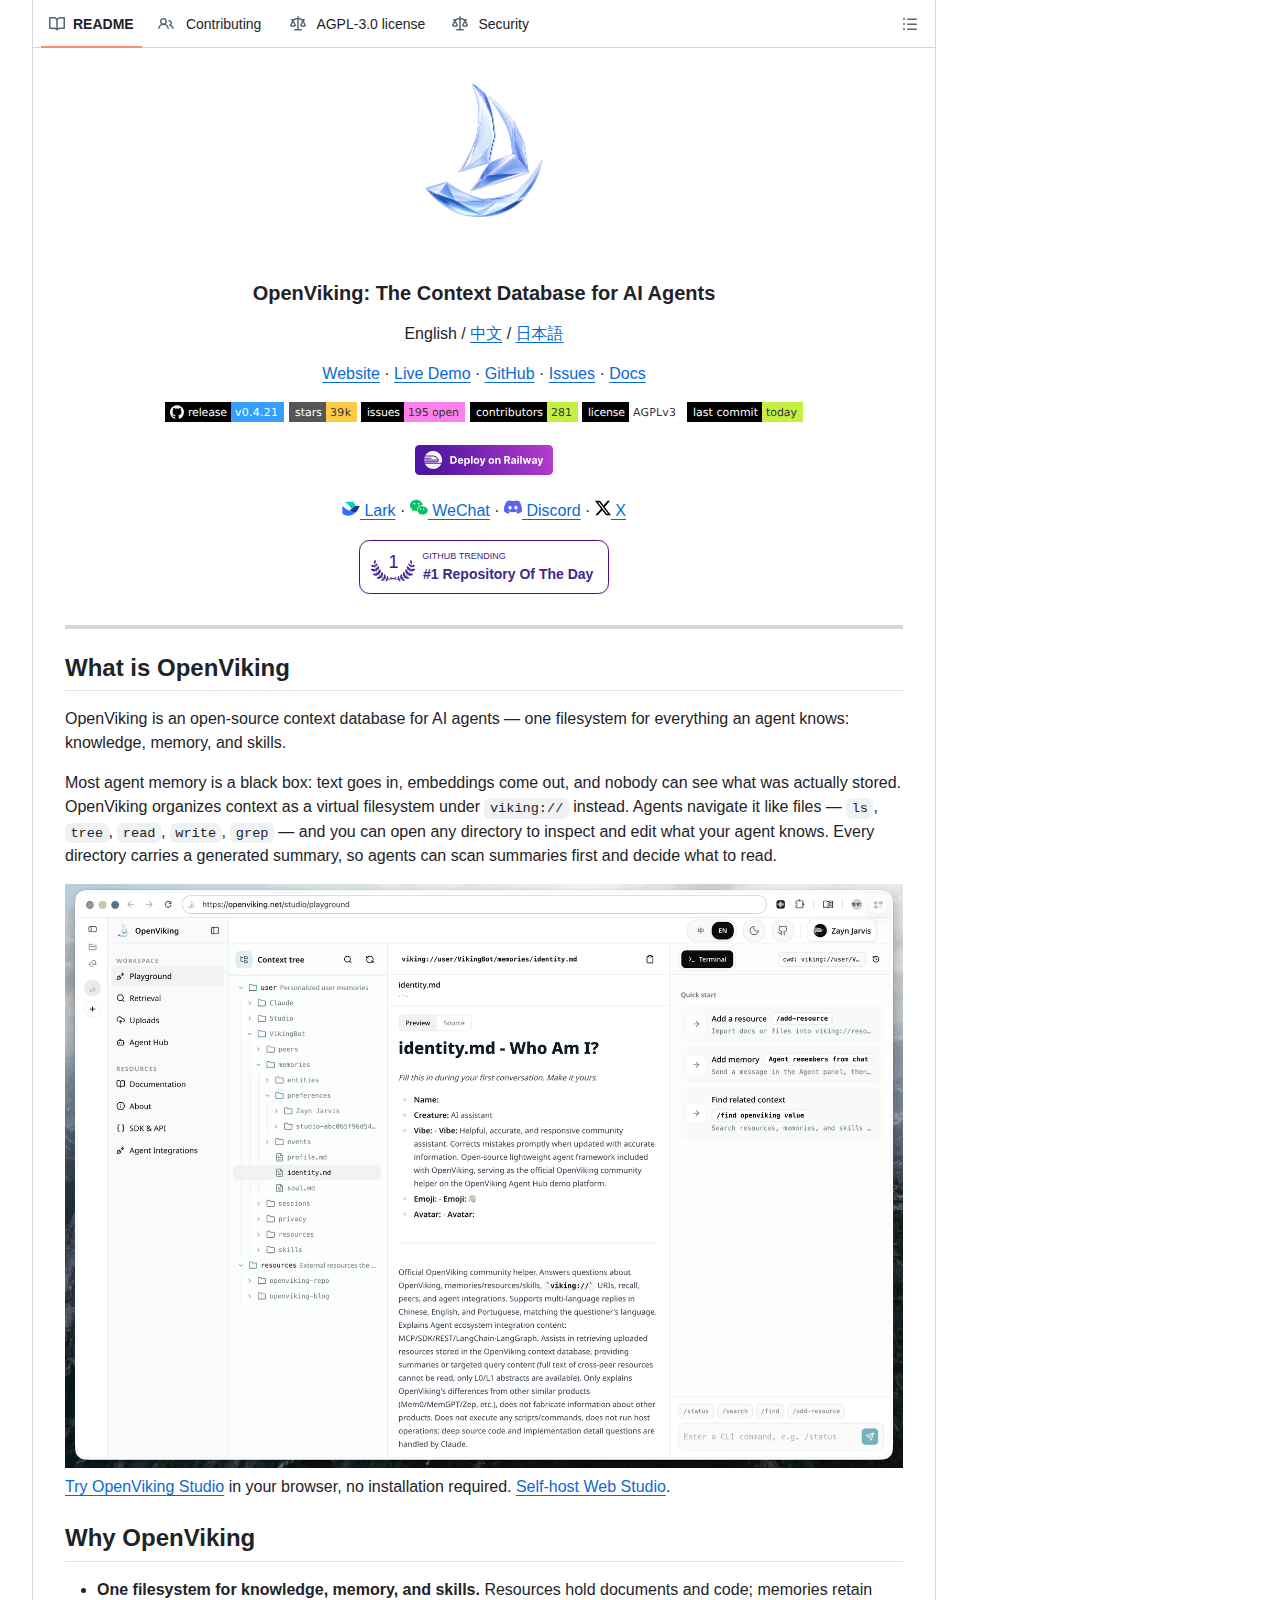
這種結構的關鍵在於可檢視性。使用者可以直接開啟任一目錄,檢視代理所依賴的內容,並在必要時手動調整。對於需要稽核代理行為、或要求記憶內容可追溯的企業場景,這種透明度具備實際價值。
OpenViking 的架構有什麼特別之處?
它以三層上下文載入機制運作:L0 為單句摘要,用於快速判斷相關性;L1 為概覽,用於規劃;L2 為完整原文,僅在需要時載入。目錄因此附帶自動生成的摘要。
架構上最值得注意的設計,是目錄層級的分層載入。每個經語意處理的目錄都會生成 L0 摘要與 L1 概覽:L0 是一句話摘要,供代理快速判斷相關性;L1 說明結構與使用場景,供代理規劃檢索路徑;L2 則是完整原文,只有在確定需要時才載入。
這套機制的效益直接反映在 token 消耗上。代理可以先掃描摘要,再決定開啟哪些內容,避免一次性把整個語料庫載入上下文。專案文件指出,導入後輸入 token 可下降 34.3% 至 91.0%,查詢延遲則降低 58.45% 至 66.10%。
檢索方式同樣有別於傳統做法。OpenViking 允許把語意搜尋限定在特定專案或記憶子樹,而非掃描整個扁平向量池。專案論文把這項能力稱為目錄感知檢索,並整合 TrieHI 機制,在向量排序之前先解析目錄範圍,讓代理保留周邊結構脈絡。
另一個設計是工作階段(session)的處理。提交一段工作階段後,對話會被歸檔,記憶則以 Markdown 形式抽取出來,供使用者檢視、編輯與合併。搭配內建的 VikingBot,ov compile 指令可把素材整理成 wiki、知識圖譜或報告。
OpenViking 的效能表現在基準測試中如何?
在 LoCoMo 長對話測試中,三款代理導入後準確度由 24% 至 57% 升至 80% 至 83%;多輪任務中經驗記憶令零售場景成功率提升 6.87 個百分點。
專案在兩類基準測試上公布了結果。第一類是長對話使用者記憶測試 LoCoMo。原生狀態下,三款代理的準確度分別落在 24.20%、33.38% 與 57.21%;導入 OpenViking 後,三者皆提升至 80% 至 83% 區間,其中兩款由二十多個百分點躍升至八成以上。
第二類是多輪代理任務測試 tau2-bench。在不改變底層模型的前提下,加入經驗記憶後,零售場景的任務成功率提升 6.87 個百分點,航空場景則提升 11.87 個百分點。這組數據的意義在於,記憶層的改善可以獨立於模型升級而產生效果。
測試環境使用 Doubao 2.0 Pro 作為視覺語言模型、Doubao-embedding-vision-251215 作為嵌入模型,完整結果與重現腳本收錄於專案的 benchmark 目錄。
OpenViking 支援哪些代理整合方式?
它提供原生整合與 MCP 兩種路徑。原生整合涵蓋 Claude Code、Codex、Cursor 等代理,另有 Python、Go 與 TypeScript SDK。
整合層面,OpenViking 採取雙軌策略。原生整合以 hooks 加 MCP 的組合,讓代理自動完成記憶召回與工作階段擷取,目前已涵蓋 Claude Code、Codex、Cursor、TRAE、OpenCode、pi 與 DeerFlow 等工具,LangChain 與 LangGraph 則以工具與儲存層的形式接入。
另一軌是通用 MCP 用戶端。透過 MCP,代理可直接取得記憶與上下文工具,不需要針對個別框架撰寫專用插件。對於自建代理的團隊,專案另提供 Python、Go 與 TypeScript 三種 SDK,以及完整的 HTTP API。
這種安排的策略意涵在於降低綁定風險。無論團隊使用閉源商用代理或自建框架,都能以相對統一的介面接入同一套上下文層。專案同時提供 macOS、Windows 的桌面應用測試版,用於檢視召回與擷取事件。
如何開始使用 OpenViking?
安裝需 Python 3.10 以上與可存取的嵌入及視覺語言模型。執行 pip install openviking 與 server init 後啟動,再以 ov 命令匯入資源。
部署門檻屬於中等。環境需求為 Python 3.10 以上,並需要可存取的嵌入模型與視覺語言模型,兩者皆可使用雲端服務或本地部署。安裝流程為執行 pip install openviking,接著以 openviking-server init 完成供應商與模型設定,再以 openviking-server doctor 檢查連線狀態。
設定檔寫入 ~/.openviking/ov.conf,官方支援的供應商包括火山引擎、OpenAI、Codex OAuth、Kimi、GLM 與本地 Ollama。伺服器啟動後,使用者可透過 ov 命令列工具匯入資源庫並執行檢索,例如以 ov add-resource 匯入專案、以 ov tree 檢視目錄結構、以 ov find 或 ov grep 進行查詢。
專案另提供瀏覽器版 OpenViking Studio,無需安裝即可試用。若要在正式環境部署,官方建議先完成帳號隔離與資源存取控制設定,再對外開放服務。
OpenViking 的授權與商業模式如何運作?
主專案採 AGPLv3 授權,命令列工具與範例為 Apache 2.0。火山引擎另提供代管與自管兩種商業方案,後者支援分散式部署與官方支援。
授權採用分層設計。主專案以 AGPLv3 釋出,crates/ov_cli 與 examples 目錄則採 Apache 2.0,Hermes 插件保留 MIT 授權。開源伺服器不需啟用金鑰即可自行部署。
商業模式延續開源加代管的常見路徑。火山引擎提供代管 SaaS,分個人與企業方案,並附帶遷移工具;自管版本則支援部署於自有雲端帳號或離線環境,加入分散式部署與官方支援,需以授權金鑰啟用。官方亦表示中國以外地區的託管服務計畫由 BytePlus 提供。
這種安排的策略意涵在於兼顧採用與變現。AGPLv3 對以服務形式提供衍生版本的行為設有較強約束,同時保留社群採用空間;需要企業級支援與分散式能力的客戶,則導向付費版本。對採用者而言,授權條款是導入前必須評估的重點。
OpenViking 與同類方案相比有什麼差異?
差異主要在可檢視性與檢索範圍。多數代理記憶方案以扁平向量池運作,難以直接檢視內容;OpenViking 以目錄樹組織上下文,允許把檢索限定在特定子樹。
與市面上以向量資料庫為核心的記憶方案相比,OpenViking 的差異集中在兩點。其一是可檢視性:多數方案把記憶存為嵌入向量,使用者難以逐項檢視或修正;目錄樹結構則讓內容可被直接閱讀與編輯。其二是檢索範圍:限定於子樹的語意搜尋,可避免跨專案內容互相干擾。
另一項差異是把三類上下文統一管理。一般做法會把知識庫檢索與代理記憶拆成兩套系統,各自維護索引與生命週期;OpenViking 則把它們收進同一套 URI 體系,並以相同的分層摘要機制處理。這降低了整合成本,但也意味著團隊需要接受其目錄結構的組織方式。
專案亦與多個開源專案建立合作關係,包括長程代理框架 deer-flow、分散式檔案系統 NoKV,以及代理專案 Hermes Agent。論文層面,團隊在 VLDB 2026 發表記憶管理的 VikingMem,另有目錄感知檢索與 VikingRAG 兩篇論文分別被 ICDE 接受或投稿中。
出處連結有哪些?
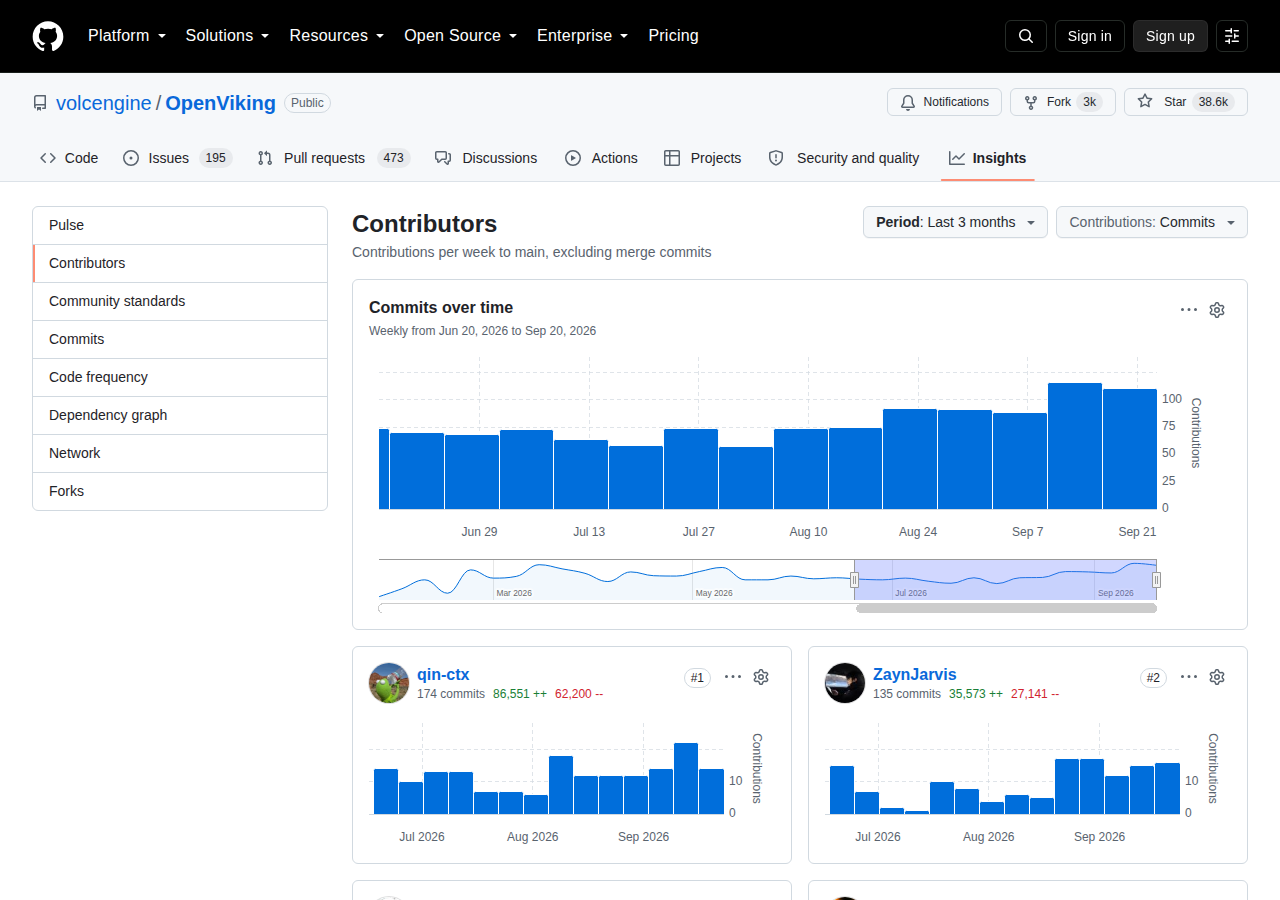
本文資訊整理自 OpenViking 的 GitHub 專案首頁與 README,內容涵蓋其架構設計、基準測試數據、代理整合方式、安裝流程與授權條款。
本文內容整理自 OpenViking 的 GitHub 專案首頁 及其 README 文件,包括專案的目錄架構、三層上下文載入機制、LoCoMo 與 tau2-bench 基準測試結果、代理整合清單、安裝步驟與授權條款。相關數據以官方儲存庫公布內容為準,並可能隨版本更新而調整。
常見問題有哪些?
以下整理三個常見疑問,涵蓋專案定位、與向量資料庫方案的差異,以及商用授權的適用條件,協助讀者快速判斷是否採用。
OpenViking 和一般向量資料庫有何不同?
一般向量資料庫把內容存為嵌入向量,檢索時在扁平向量池中比對相似度。OpenViking 則以虛擬檔案系統組織上下文,每個目錄附有摘要,檢索可限定在特定子樹,內容也能直接開啟檢視與編輯。導入 OpenViking 需要哪些前置條件?
需要 Python 3.10 以上的執行環境,以及可存取的嵌入模型與視覺語言模型。兩者皆可選用雲端服務或本地部署,設定檔會寫入使用者目錄下的 ov.conf。AGPLv3 授權對商業使用有什麼影響?
主專案採 AGPLv3,若以網路服務形式提供衍生版本,需依條款開放對應原始碼。命令列工具與範例目錄為 Apache 2.0。需要企業級支援或分散式部署的團隊,可改用需授權金鑰的商業版本。總結:OpenViking 適合什麼團隊?
它適合需要可檢視、可稽核代理記憶的團隊。目錄化上下文讓記憶能被閱讀與修正,並在基準測試中顯著提升。若無法接受 AGPLv3,需另評估。
OpenViking 的價值主張,是把代理的上下文從無法檢視的黑箱,轉為可瀏覽、可編輯的目錄結構。對需要稽核代理行為、或要求記憶內容可追溯的團隊而言,這種透明度補上了既有方案的缺口;基準測試中八十多個百分點的記憶準確度,也說明結構化檢索具備實際效益。
真正的取捨在於接受度。目錄化代表團隊需要決定上下文如何分類、哪些內容歸入記憶、哪些歸入資源,這是一層額外的組織成本。同時,AGPLv3 對以服務形式提供衍生版本的行為設有約束,商業採用前必須先釐清條款影響。
從更長的角度看,這個專案反映代理基礎設施正在從單純的向量檢索,走向具備結構、分層與治理能力的上下文管理。當代理開始長時間運作並累積經驗,如何儲存、檢索與修正這些經驗,會逐漸成為與模型能力同等重要的工程課題。