
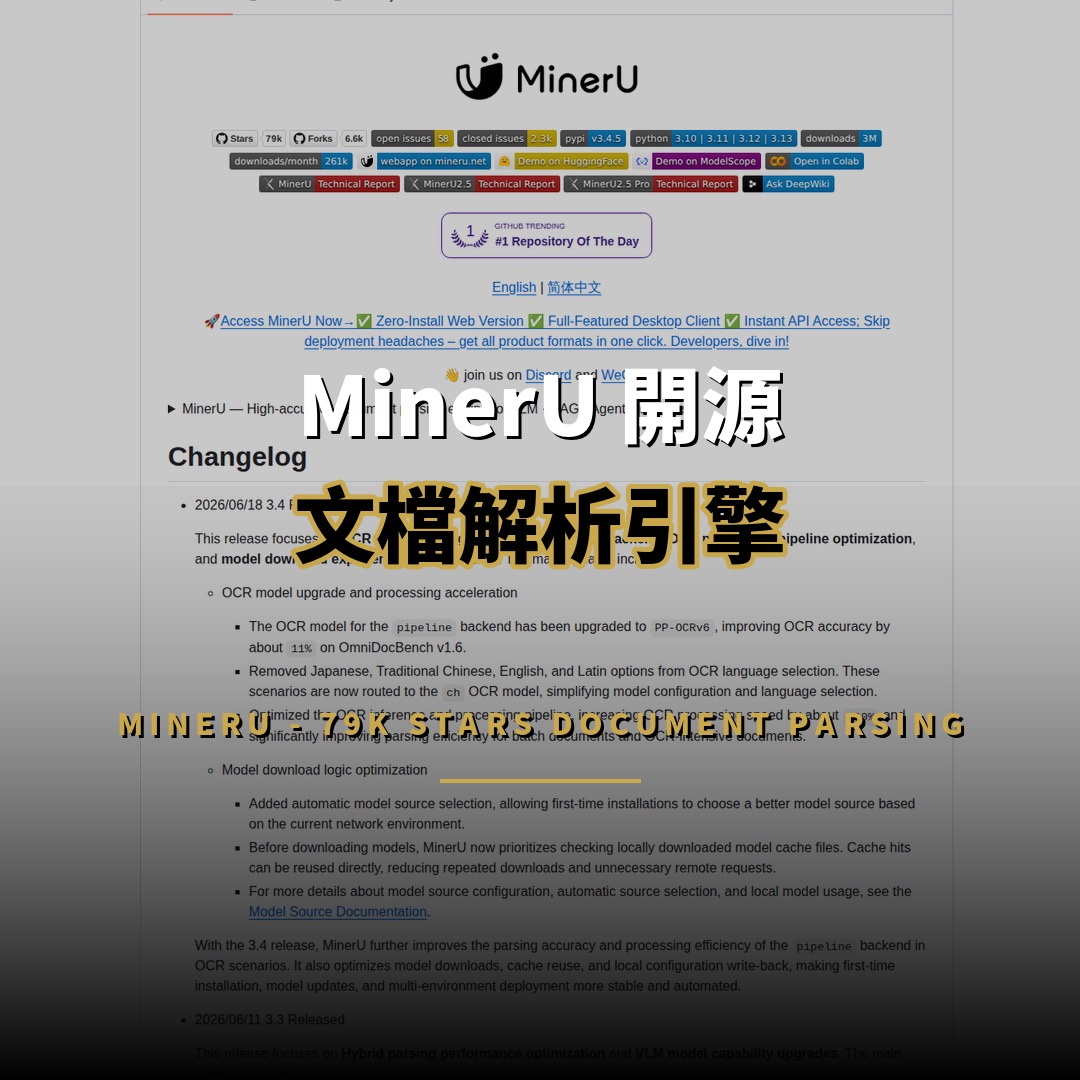
MinerU 是由 OpenDataLab 開發的高精度文檔解析引擎,專門將 PDF、DOCX、PPTX、XLSX 與圖片等複雜文檔轉換為 LLM 可直接使用的 Markdown 與 JSON 格式。截至 2026 年 9 月,該項目在 GitHub 上已累積約 7.9 萬星標與 6,600 個 fork,成為 RAG 與 Agent 工作流中最常被引用的文檔解析基礎設施之一。本文將從項目背景、核心技術、版本演進與應用場景四個層面,分析 MinerU 為何能在短時間內成為開發者社群的主流選擇。
MinerU 是什麼?
MinerU 是開源文檔解析引擎,支援 PDF、圖片、DOCX、PPTX、XLSX,輸出結構化 Markdown 與 JSON。
MinerU 的定位並非單純的檔案格式轉換器,而是面向大語言模型時代的「文檔理解基礎設施」。其核心能力包括公式自動轉換為 LaTeX、表格自動轉換為 HTML、頁首頁尾與頁碼自動移除,以及依人類閱讀順序重排多欄版面。這些能力直接對應 RAG 系統中「文件清洗」與「版面重構」兩大痛點,使解析結果可以直接進入向量化與檢索階段,而不需要大量人工前處理。

該項目在 GitHub 的 7.9 萬星標主要來自華人圈與全球開發者社群,其 README 提供中英雙語版本,並同時部署於 Hugging Face、ModelScope 與官方線上服務 mineru.net,降低不同地區使用者的試用門檻。

MinerU 的核心技術亮點有哪些?
它採 VLM 與 OCR 雙引擎,內建 pipeline、hybrid、vlm-engine 三種後端,支援 109 種語言辨識。
在架構設計上,MinerU 提供多種部署形態以適應不同場景。pipeline 後端為傳統版面分析流程,可在純 CPU 環境運行,最低僅需 4GB 顯示記憶體;hybrid 與 vlm-engine 後端則依賴視覺語言模型,需要 8GB 以上顯示記憶體,並可透過 vLLM、SGLang、LMDeploy 等推理框架部署。進階用戶可選擇 *-http-client 模式,將解析任務委派給任何 OpenAI 相容的推理伺服器,實現解析與模型服務的分離。
模型層面的整合能力是其另一項優勢。MinerU 內建 MCP Server,可直接接入 Cursor、Claude Desktop 與 Windsurf 等 AI 編碼工具;同時提供 LangChain、LlamaIndex、RAGFlow、Dify、FastGPT 等主流框架的原生整合,開發者無需編寫額外介面程式即可將文檔解析串入既有管線。此外,該項目支援昇騰、寒武紀、燧原、摩爾執行緒等十餘款國產 AI 晶片,在中國市場的企業部署中具備顯著的合規與成本優勢。
MinerU 3.4 版本帶來了什麼升級?
MinerU 3.4 於 2026 年 6 月發布,pipeline 後端 OCR 升級為 PP-OCRv6,解析速度提升約 100%。
3.4 版本的核心改進集中在 OCR 管線與工程體驗。OCR 語言選擇從原本的日文、繁體中文、英文、拉丁文等多套模型,簡化為統一由中文模型 ch 處理,降低模型配置複雜度,同時提升批次文檔與 OCR 密集型文檔的處理效率。對需要大量掃描文件數位化的企業而言,這項更新直接反映在單位時間處理量與人工校正成本的下降。
模型下載邏輯的優化則解決了安裝與更新的痛點。新版本會根據當前網路環境自動選擇較佳的模型來源,並在下載前優先檢查本地模型快取;快取命中即可直接重用,減少重複下載與不必要的遠端請求。這對多環境部署與離線環境尤其重要,讓首次安裝與版本更新的流程更穩定。
MinerU 的解析準確度表現如何?
在 OmniDocBench v1.6 中,pipeline 得 86.47 分,hybrid 為 95.39 分,vlm-engine 為 95.30 分。
準確度數據是 MinerU 社群信任度的關鍵指標。以 OmniDocBench 基準衡量,hybrid 與 vlm-engine 後端已穩定維持在 95 分以上的水準,而 pipeline 後端亦以 86.47 分超越上一代 VLM 主模型,展示了傳統版面分析流程在新一代模型輔助下的長足進步。

值得留意的是解析強度與效能之間的平衡設計。3.3 版本引入的 effort 參數將 hybrid 後端分為 medium 與 high 兩級,預設採用 medium。在 Linux 文字型 PDF 場景下速度提升約 80%,Windows 約 90%,macOS 最高可達 220%;代價僅是準確度微降 0.13 分。這項設計讓使用者在日常批次處理與最高精度需求之間有明確的取捨依據,也反映團隊對工程實用性的重視。
如何快速開始使用 MinerU?
支援 pip 或 uv 一鍵安裝,亦可用線上服務或桌面客戶端快速試用;本地部署最低需 16GB 記憶體與 4GB 顯示記憶體,適合 RAG 與大量文檔處理。
官方建議初次使用者先透過線上體驗驗證解析品質,再根據實際需求選擇部署方式。最簡單的路徑是直接使用 mineru.net 線上版本,無需安裝任何環境;開發者則可透過 Gradio WebUI 快速搭建本機介面,或使用 pip 安裝命令在本機部署完整功能。
對於資源受限的環境,pipeline 後端提供純 CPU 支援,記憶體建議 16GB 起、顯示記憶體最低 4GB,磁碟空間 20GB 以上;若使用 *-http-client 模式連接外部推理伺服器,本機僅需 2GB 磁碟空間,大幅降低部署門檻。Windows、Linux 與 macOS 三大平台均有官方支援,其中 macOS 需 14.0 以上版本。
MinerU 在 RAG 與 AI 工作流中如何應用?
MinerU 是 RAG 管線「文件進、結構出」的關鍵環節,其 MCP Server 讓 Cursor 與 Claude Desktop 可直讀文檔。
在 RAG 應用中,文檔解析品質直接決定檢索結果的上限。MinerU 的輸出保留標題層級、段落、清單、表格與公式結構,並依閱讀順序重排多欄與跨頁內容,使向量切塊(chunking)更加精準,減少語意斷裂。對合約審閱、研究論文分析與財務報告等專業場景,其表格轉 HTML、公式轉 LaTeX 的能力可保留原始語意,優於單純的文字擷取方案。
在 Agent 工作流方面,MinerU 透過 MCP Server 向 AI 編碼工具提供文檔理解能力,讓模型可以直接讀取 PDF、試算表與簡報內容,再據此生成摘要、撰寫程式或完成分析任務。搭配 mineru-router 統一入口與多 GPU 負載均衡,企業可將文檔解析部署為高並發的內部服務,支撐多團隊同時使用;滑動視窗與串流寫入機制則讓數萬頁的超長文檔無需手動分段即可處理。
出處連結有哪些?
本文資訊來源為 OpenDataLab 在 GitHub 發布的 MinerU 開源儲存庫(opendatalab/MinerU)。
項目原始碼與完整文件位於 GitHub 儲存庫:opendatalab/MinerU。技術細節可參考其 arXiv 技術報告(MinerU、MinerU2.5 與 MinerU2.5 Pro),部署與整合教學則見於官方文件網站 opendatalab.github.io/MinerU。
總結:MinerU 適合什麼團隊?
適合需將大量複雜文檔轉為結構化資料的團隊:RAG 知識庫、企業數位化與 AI Agent 開發者皆可受惠,尤以本機部署與批次處理需求最為合適。
從 7.9 萬星標與持續的版本迭代來看,MinerU 已從 InternLM 訓練過程中的內部工具,成長為文檔解析領域的基礎設施級項目。其 3.0 至 3.4 的演進脈絡,清晰呈現三條主線:解析準確度持續逼近甚至超越商業產品、部署形態從單機工具擴展至多 GPU 服務架構、授權模式由 AGPLv3 轉為基於 Apache 2.0 的自訂開源授權以降低商業採用門檻。對正在建構 RAG 系統或需要高品質文檔解析能力的開發者而言,MinerU 是目前開源生態中最值得評估的選項之一。